
Griffin by Tavus
Tavus · Voz e linguagem · Vídeo · Chatbot
Griffin by Tavus é o primeiro modelo de interação humana: um sistema de vídeo para vídeo, full-duplex, que observa, escuta e responde durante uma chamada de vídeo com IA em tempo real.
Sobre Griffin by Tavus
What Is Griffin by Tavus
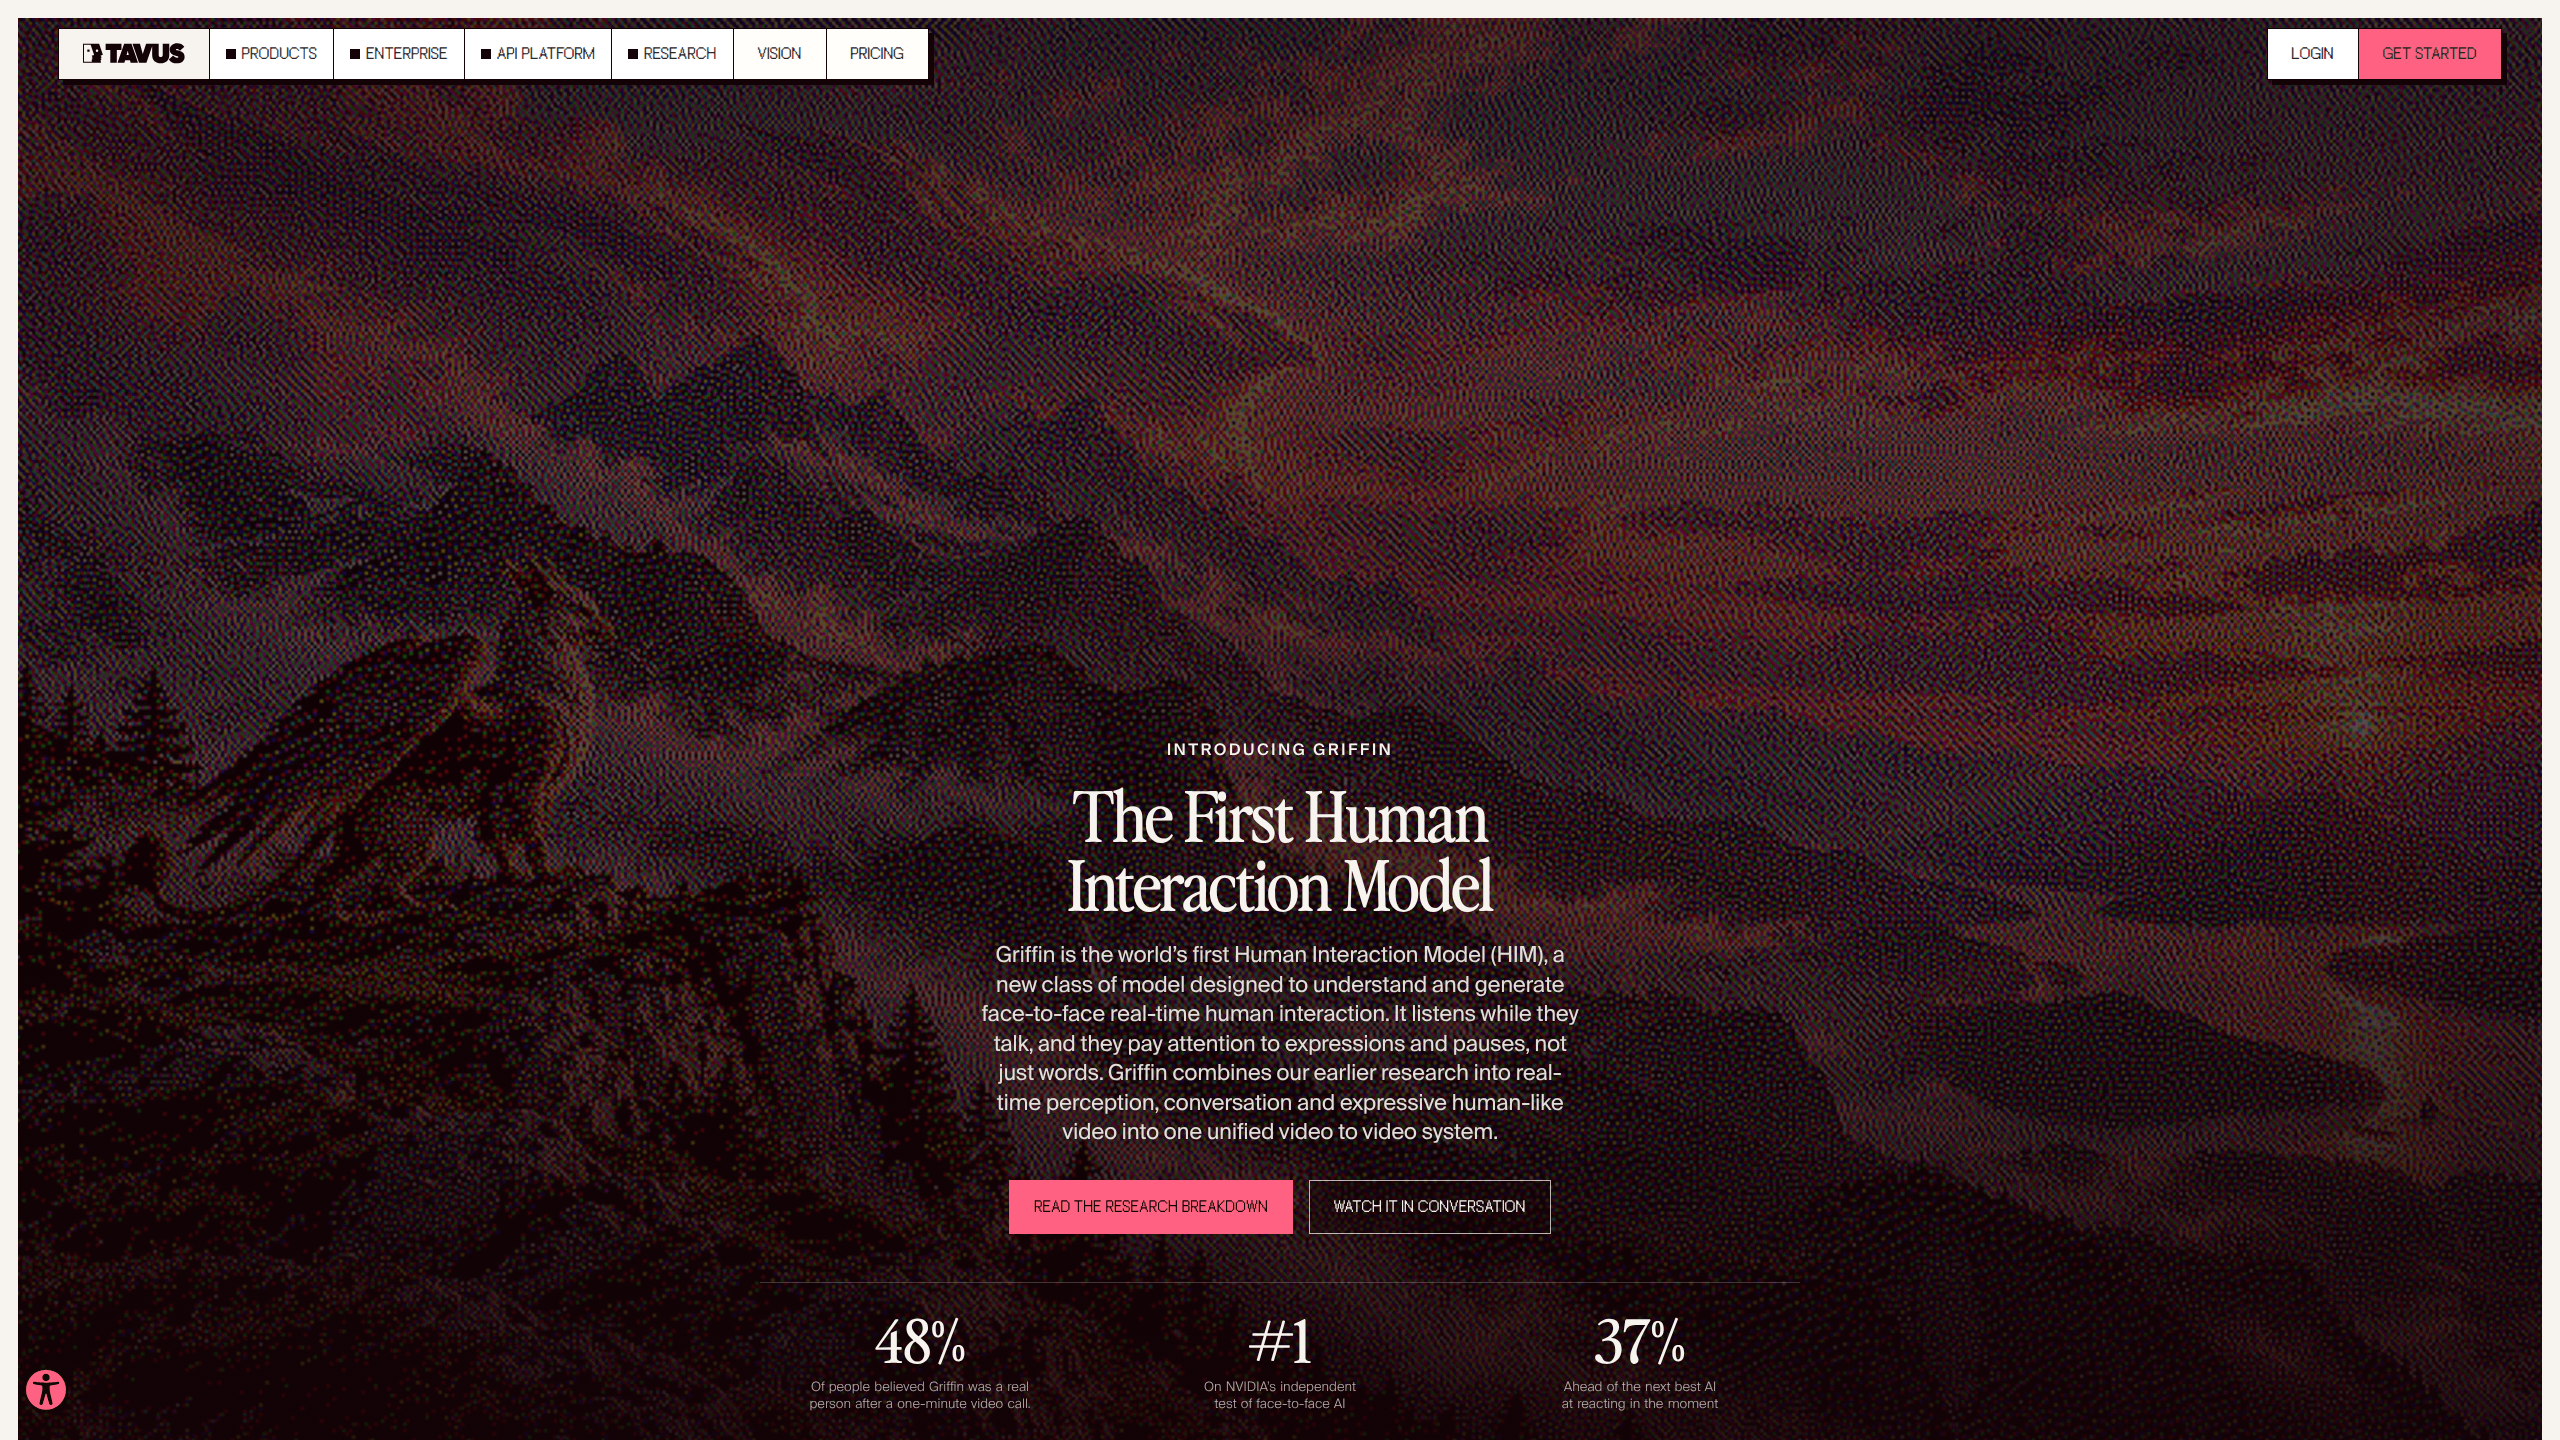
Griffin é um modelo de pesquisa da Tavus que sustenta uma conversa cara a cara numa chamada de vídeo. Ele lê a câmera e o microfone ao mesmo tempo, decide quando falar e gera o rosto e a voz da outra pessoa enquanto a conversa acontece. A Tavus publicou o modelo em 1º de outubro de 2026 e o apresenta como o primeiro modelo de interação humana, ou HIM.
O desenho rompe com a arquitetura comum da IA conversacional em vídeo. Quase todo sistema encadeia reconhecimento de fala, modelo de linguagem, síntese de voz e um gerador de avatar, e espera você terminar de falar para começar. Griffin decide a cada fração de segundo. Por isso consegue acenar enquanto você fala, entender uma pausa como tempo de raciocínio e retomar o fio quando é interrompido.
O preço disso é o acesso. O Griffin-Lite, versão que existe hoje, é uma prévia de pesquisa para um grupo pequeno de testadores de confiança. A Tavus diz que ele ainda não está na plataforma da empresa, não publicou preços e não oferece API pública. O número de 48% vem de um estudo da própria Tavus com 54 pessoas e chamadas de um minuto.
Getting Started
- Acesse tavus.io/griffin e envie o formulário de solicitação. O acesso é por convite, então não existe um botão de cadastro que garanta uma vaga.
- Se for aprovado, entre na chamada de vídeo com IA pelo link que receber. Não há nada para instalar.
- Libere câmera e microfone e fale como falaria com um colega de trabalho. O avatar de IA gera a resposta enquanto você fala.
- Teste um comportamento por vez. Interrompa no meio da frase, pare para pensar ou levante um objeto para a câmera e veja o que o modelo faz com ele.
- Encare a sessão como avaliação. Não há painel nem exportação, e também não existe página de cobrança: o Griffin-Lite não é um produto para clientes.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Griffin by Tavus.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Times de produto que constroem agentes de vídeo em tempo real
- Times de treinamento
- Pesquisadores de IA conversacional
Tarefas
- Ensaiar uma ligação de vendas
- Praticar entrevistas
- Praticar idiomas
- Preparar um escalonamento de suporte
Cenários
- Decidir se um agente de vídeo cabe num fluxo de trabalho
- Testar interrupções antes de desenvolver
- Avaliar uma conversa regulada
Principais recursos
Conversa full-duplex
Griffin escuta enquanto fala. Pode segurar o turno, cedê-lo ou parar quando você corta a fala, e continua processando a conversa durante a própria resposta. A Tavus construiu isso como um ciclo contínuo, não como uma troca de turnos, e é por isso que uma pausa na sua frase não encerra o seu turno automaticamente.
Geração da cena inteira
O modelo gera cada pixel do quadro a partir de uma única imagem de referência. Isso inclui rosto, mãos, a cadeira em que a pessoa está sentada, as sombras e o fundo. A maioria dos sistemas de avatar anima uma cabeça recortada, então uma mão em movimento quebra a ilusão. Griffin não tem essa emenda.
Saída em 720p em tempo real
O vídeo sai em 720p com a chamada rodando, um latente por vez. A Tavus mediu 0,43 segundo em média para gerar o menor trecho em uma H100, com melhor caso de 0,27 segundo. Numa chamada, o que conta é o intervalo entre a sua interrupção e a reação do rosto, e meio segundo já é lido como atenção.
Percepção visual
Griffin recebe vídeo, não apenas áudio. Ele capta olhar, expressão facial, gestos e objetos que você mostra para a câmera, além de ler uma tela compartilhada. É assim que reage quando você levanta uma peça quebrada ou desvia o olhar para pensar, em vez de responder à transcrição das suas palavras.
Comportamento e emoção
O modelo muda tom, expressão e gesto conforme o contexto da conversa. Ri na hora certa, fica sério quando o assunto pesa e usa sinais não verbais para confirmar o que você disse. A Tavus treinou esses comportamentos dentro do mesmo sistema que decide o que falar, não como uma camada colada depois.
Clonagem de voz com áudio curto
O gerador de fala do Griffin clona uma voz a partir de cerca de dez segundos de áudio de referência. Ele roda no Tavec, o codec de áudio da Tavus, que transmite em blocos de até 10 milissegundos. Para quem monta um avatar de IA de marca, essa amostra curta elimina uma sessão de gravação da preparação.
Prós e contras
Prós
- 48% dos participantes do estudo ao vivo da Tavus acharam que falavam com uma pessoa, contra 2,4% da pilha anterior da empresa, a Phoenix-4.5.
- O Griffin-Lite marcou 3,83 na trilha de geração do VideoFDB, da NVIDIA, com a referência humana em 3,92 e o próximo sistema de IA em 2,80.
- Ele lida com interrupções e confirmações sem perder o fio, que é onde as pilhas encadeadas de voz e avatar costumam quebrar.
- A geração da cena inteira faz mãos, postura e fundo se moverem com a conversa em vez de ficarem congelados.
- A clonagem de voz pede cerca de dez segundos de áudio, então um avatar de IA próprio fica pronto rápido.
Contras
- Não dá para comprar. O Griffin-Lite é restrito a testadores aprovados e a Tavus não marcou data de lançamento geral, então nenhum time consegue planejar um lançamento com ele.
- Não há API pública, identificador de modelo nem preço. Um desenvolvedor não consegue testá-lo na própria pilha nem colocá-lo no orçamento.
- Os 48% se apoiam em 54 pessoas e chamadas de um minuto, feitas pela empresa que criou o modelo. Chamadas longas e replicação independente seguem sem teste.
- A trilha de percepção mostra uma distância real: 3,73 contra 4,20 dos humanos, com 2,2 segundos de resposta contra 1,4. Contexto visual complexo ainda derruba o modelo.
Perguntas frequentes
Griffin é um modelo de vídeo para vídeo, full-duplex, que sustenta uma conversa cara a cara em tempo real. A Tavus o chama de modelo de interação humana porque resolve percepção, troca de turnos e geração audiovisual num único sistema, sem encadear modelos separados de fala, linguagem e avatar.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Griffin by Tavus.
Alternativas a Griffin by Tavus

Foley
Hanamori Labs, LLC · Voz e linguagem · Produtividade · Assistente de IAFoley é uma lista de tarefas por voz que transforma uma frase falada em tarefa arquivada, com projeto, data e hora já preenchidos, e depois ajuda você a organizar o dia com o que já está anotado.

HireKey
HireKey · Voz e linguagem · Produtividade · AprendizadoHireKey é um copiloto de busca de emprego com IA criado por uma recrutadora de tecnologia. Avalia aderência à vaga, adapta o currículo, treina entrevistas e organiza cada candidatura.

Fluence
Yay Software (Yannick Huchard) · Escrita · Voz e linguagem · ProdutividadeO Fluence é um app de Android que lê em voz alta PDF, EPUB, arquivos do Word e artigos da web, acompanha a frase falada e responde perguntas sobre o texto sem sair do celular.