
Helicone
Helicone, Inc. · Programação
Helicone é uma plataforma de observabilidade de LLM de código aberto e um gateway de IA. Troque uma URL base para registrar cada prompt, medir o gasto e rotear mais de 100 modelos.
Sobre Helicone
About
O que é o Helicone
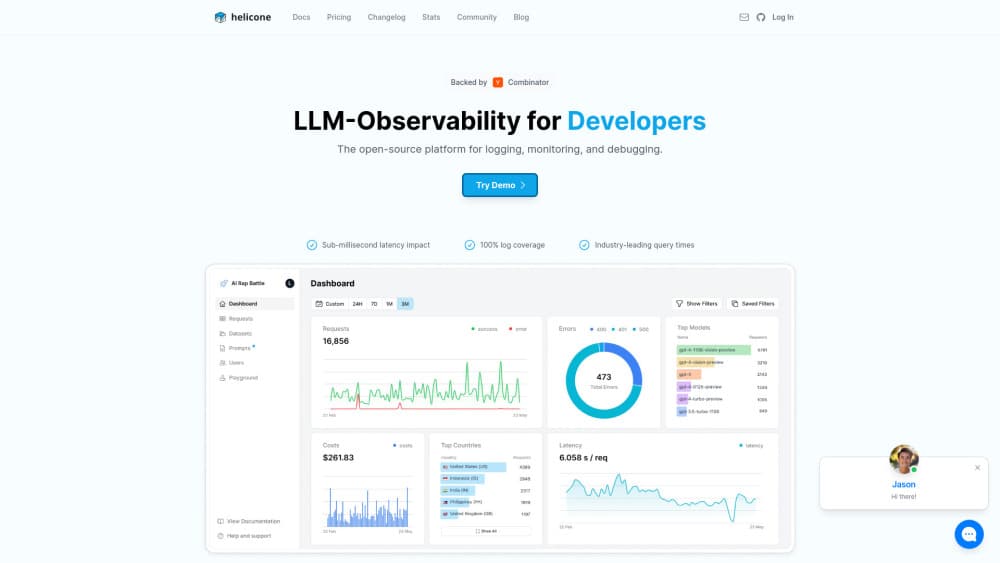
O Helicone fica entre o seu aplicativo e o provedor do modelo. Você aponta o SDK da OpenAI para o endereço do gateway, ou acrescenta a URL do proxy às chamadas que já faz, e cada requisição aparece num painel com o prompt, a resposta, os tokens, o custo e a latência.
Com isso você responde perguntas que surgem uma semana depois do lançamento. Por que o chat de um cliente custa 40 centavos. Qual prompt quebrou a saída em JSON. Se a lentidão vem do seu servidor ou do provedor. Os registros de requisições continuam pesquisáveis e você pode agrupá-los por usuário, sessão ou qualquer propriedade própria.
O projeto é de código aberto sob licença Apache 2.0 e tem um caminho auto-hospedado para equipes que não querem enviar prompts a terceiros. Dois limites definem para quem ele serve. Você precisa de acesso ao código que chama o modelo, porque a instalação consiste em trocar uma URL base e adicionar um cabeçalho. A parte de avaliação é mais enxuta do que a de plataformas dedicadas, então quem roda experimentos em escala costuma manter uma segunda ferramenta.
Primeiros passos
- Crie a conta gratuita e gere uma chave de API nas configurações.
- Aponte seu cliente OpenAI para o gateway do Helicone, ou envie as chamadas atuais pela URL do proxy com um cabeçalho Helicone-Auth.
- Faça uma requisição e abra a aba de requisições; o registro aparece em segundos.
- Marque as chamadas com propriedades próprias como ID de usuário ou plano, para separar o gasto depois.
- Configure um alerta de custo ou de erro e convide o resto da equipe.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Helicone.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Equipes de engenharia com recursos de LLM em produção
- Desenvolvedores independentes e startups pequenas
- Equipes de plataforma e DevOps
- Equipes com regras de dados
Tarefas
- Depurar uma resposta ruim
- Acompanhar o gasto
- Trocar de provedor
- Comparar prompts
- Auditar o uso
Cenários
- Um chatbot que ficou caro depois do lançamento
- Um protótipo que precisa testar três modelos nesta semana
- Um ambiente regulado
Principais recursos
Integração em uma linha
A instalação é uma troca de URL base mais uma chave de API, então um cliente OpenAI, Anthropic, Azure ou LiteLLM existente mantém o formato do código. Não há nada para instalar no servidor nem agente para executar, e por isso as equipes veem registros na mesma tarde em que se cadastram. O caminho do proxy atende qualquer linguagem que consiga enviar uma requisição HTTP.
Registros de requisições e traces
Cada entrada guarda o prompt completo, a resposta do modelo, os tokens, a latência e o custo calculado. Você filtra por modelo, status, intervalo de tempo ou propriedade própria e depois abre uma requisição para ver onde o tempo foi gasto. O registro de prompts nesse nível transforma uma reclamação vaga numa linha de texto concreta que dá para editar.
Gateway de IA com cache e alternativas
O gateway de IA é um endpoint compatível com OpenAI que cobre mais de 100 modelos da OpenAI, Anthropic, Google, Vertex, Groq e outros provedores. Ele acrescenta cache de respostas, limites de requisição por chave e alternativas automáticas quando um provedor falha, e os créditos são cobrados pelo preço do provedor, sem margem. Você também pode usar suas próprias chaves se preferir separar a cobrança.
Análise de usuários e sessões
As propriedades próprias deixam você colar numa requisição um ID de usuário, um plano, o nome de um recurso ou qualquer outra etiqueta. As sessões agrupam então uma conversa de vários turnos numa única visão, e você vê o custo e a duração de uma jornada real. Para uma equipe de suporte, é a diferença entre «o bot está lento» e «esta conta dispara uma chamada de ferramenta de 12 segundos toda vez».
Playground e gestão de prompts
O playground roda prompts contra vários modelos lado a lado e mostra os ajustes de raciocínio nos modelos que os expõem. Os prompts podem ser salvos, versionados e reutilizados a partir do código, e as saídas podem receber nota para julgar uma mudança por resultado, não por intuição. É o jeito rápido de testar um modelo mais barato antes de mandar tráfego real para ele.
Alertas, relatórios e HQL
Os alertas disparam com limites de custo, taxa de erro ou latência, e os relatórios agendados enviam um resumo por e-mail ou Slack. O HQL, a linguagem de consulta embutida, resolve o que os filtros do painel não expressam, como custo por usuário nos últimos 30 dias. Os resultados saem por exportação ou pela API para o seu data warehouse.
Código aberto e auto-hospedagem
O código é público sob Apache 2.0, com milhares de estrelas no GitHub e um ritmo constante de versões. Você roda a pilha inteira na sua nuvem com Docker, o que pesa quando os prompts carregam dados de clientes que o jurídico não deixa sair. A versão hospedada e a auto-hospedada compartilham o mesmo painel e a mesma API.
Prós e contras
Prós
- Uma troca de URL base já liga o registro, sem reescrever o SDK nem montar um projeto de migração.
- O gateway cobre mais de 100 modelos pelo preço do provedor, sem margem, com cache e alternativas na mesma chave.
- Código aberto sob Apache 2.0, com um caminho auto-hospedado para equipes sujeitas a regras de dados.
- O plano gratuito serve de verdade: 10.000 requisições por mês, 1 GB de armazenamento e nenhum cartão.
- Custo, latência e erros ficam numa tela por requisição, por usuário e por sessão, e você larga a planilha.
Contras
- Foi feito para desenvolvedores. Sem acesso ao código que chama o modelo, o painel não tem o que mostrar.
- Os recursos de avaliação e de conjuntos de dados são mais magros do que em plataformas dedicadas, então um acompanhamento sério de experimentos pede uma segunda ferramenta.
- O Pro começa em US$ 79/mês e a cobrança por uso de requisições e armazenamento torna a fatura difícil de prever quando o tráfego cresce.
- O plano gratuito guarda registros por 7 dias e 1 GB, então qualquer histórico de longo prazo exige um plano pago.
Perguntas frequentes
Ele registra e analisa as chamadas que seu aplicativo faz aos provedores de LLM. Você recebe registros de requisições com prompts, respostas, tokens, custo e latência, além de um gateway que roteia essas chamadas para mais de 100 modelos.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Helicone.
Alternativas a Helicone

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.