

Hopscotch AI
Hopscotch Labs · Programação · Produtividade · Negócios
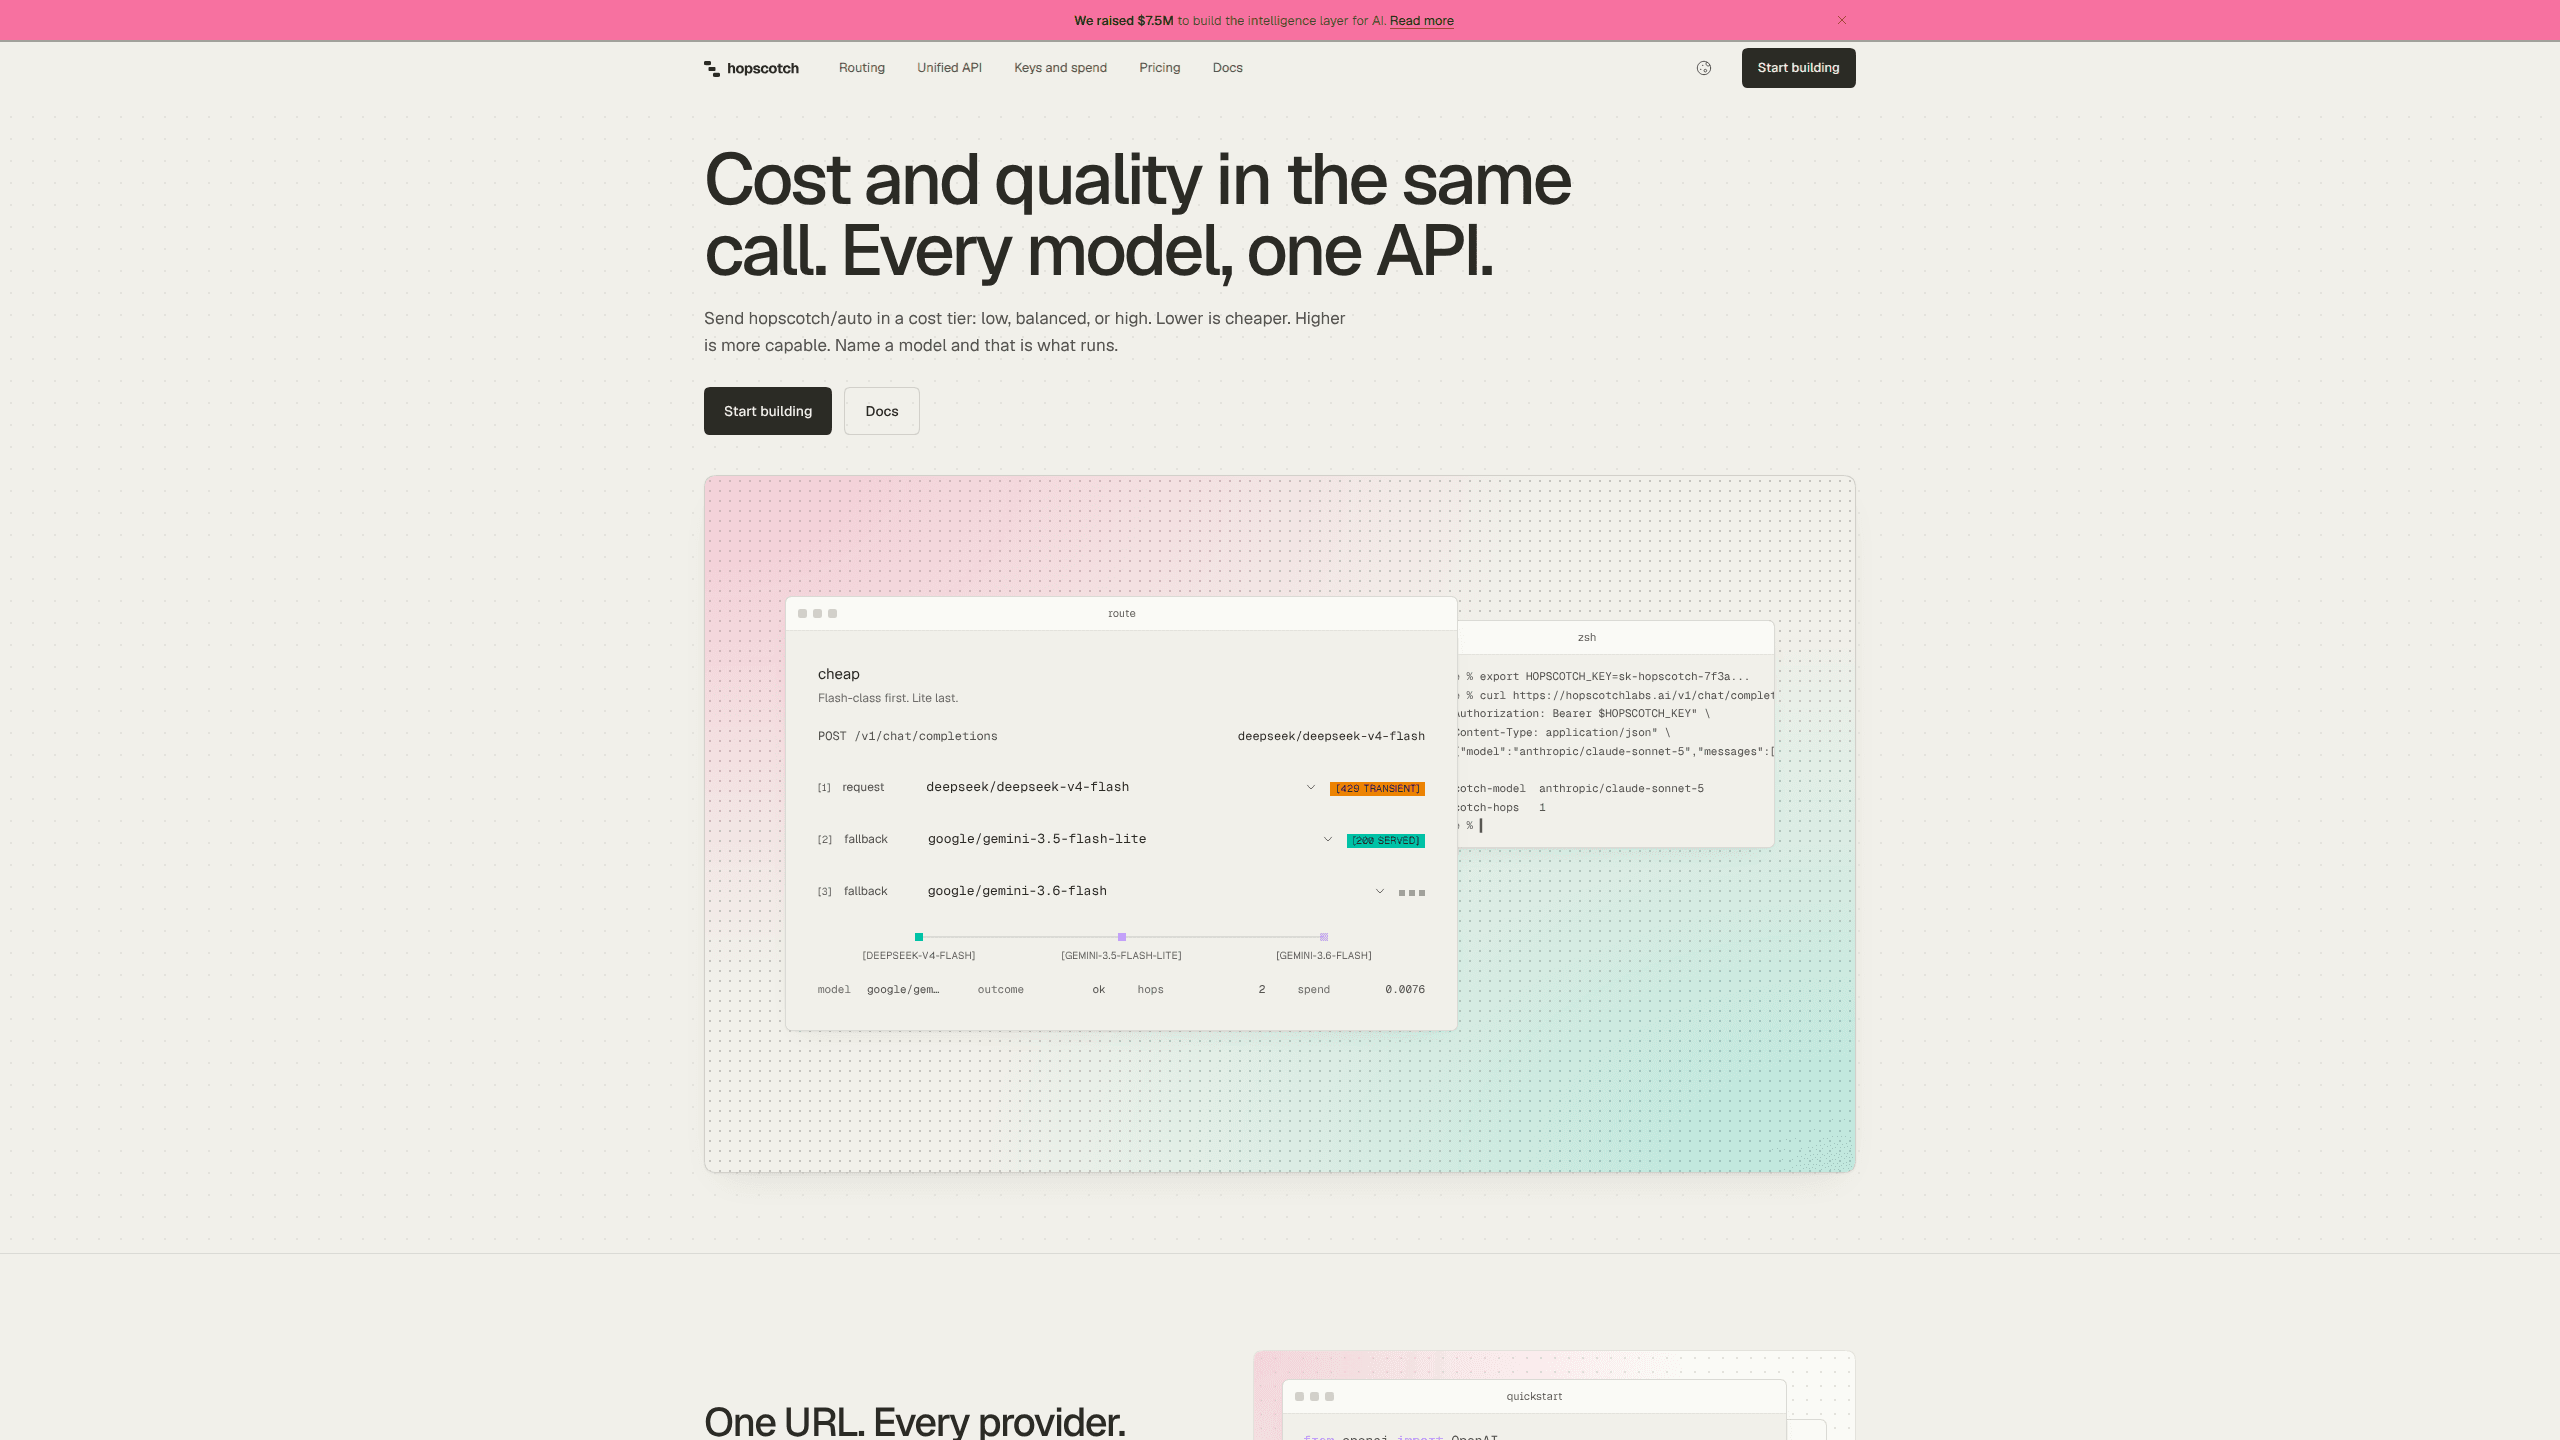
O Hopscotch AI é um roteador LLM compatível com OpenAI. Uma chave chega a mais de 500 modelos pelo preço de tabela, sem margem sobre token, com limites de gasto e registro de custo por requisição.
Sobre Hopscotch AI
About
O que é o Hopscotch AI
O Hopscotch AI é um gateway da Hopscotch Labs que fica entre o seu código e os provedores de modelo. Você mantém o SDK da OpenAI, troca a URL base por api.hopscotchlabs.ai e envia um identificador como anthropic/claude-sonnet-5-5. A Hopscotch fica com as contas dos provedores e desconta cada requisição de um saldo pré-pago.
O produto ataca o trabalho de contabilidade e de confiabilidade que aparece quando uma aplicação conversa com mais de um modelo. Cinco painéis de provedor, cinco faturas e cinco rotações de chave viram um saldo, um log de atividade e um lugar só para definir limites. Você paga a tarifa publicada de cada provedor, e a Hopscotch não acrescenta nada enquanto essa taxa estiver em 0%.
Três limites importam antes do cadastro. O crédito é pré-pago, então um workspace com saldo zerado recusa requisições. Recursos que rodam nos servidores do provedor, como busca na web, áudio e ferramentas hospedadas, não passam pelo gateway. Embeddings ainda não são servidos. Se o seu projeto depende de algum deles, você continua precisando de uma chave direta do provedor.
Primeiros passos
- Crie uma conta em platform.hopscotchlabs.ai e confirme o e-mail.
- Compre crédito na tela de cobrança. O mínimo é 5 dólares, e a recarga automática repõe o saldo quando ele cai abaixo do valor que você escolher.
- Gere uma chave de API na tela de chaves. Ela aparece uma vez só e fica guardada como hash, então copie antes de sair.
- Aponte seu cliente OpenAI para https://api.hopscotchlabs.ai/v1 e use a chave da Hopscotch. Nada mais no código muda.
- Faça uma requisição com um identificador que traga o provedor na frente e confira no log de atividade os tokens, o custo e a latência.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Hopscotch AI.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores independentes
- Times de produto que trabalham com vários modelos
- Gestores de engenharia com orçamento para defender
Tarefas
- Testar o mesmo prompt em modelos diferentes
- Unificar integrações de provedor
- Colocar teto em um agente autônomo
- Manter uma demo no ar durante uma queda
Cenários
- Lançar o primeiro recurso com LLM e pouco orçamento
- Entregar uma chave a um freelancer sem entregar a conta
- Conferir quanto um recurso custou na semana passada
Principais recursos
Uma chave para mais de 500 modelos
Os identificadores seguem o formato provedor/modelo, então openai/gpt-6.1-sol e anthropic/claude-sonnet-5-5 chegam pela mesma API multimodelo e saem do mesmo saldo. Um nome solto, sem provedor, é recusado em vez de adivinhado. O catálogo é vivo: os modelos entram e saem no ritmo de cada provedor, não de uma lista que a Hopscotch mantém à mão.
URL base compatível com OpenAI
Três ajustes mudam: URL base, chave de API e nome do modelo. O código do SDK da OpenAI para chat completions continua rodando, e o gateway também atende o formato Responses, o endpoint antigo de completions e o protocolo Messages da Anthropic para os SDKs dela. Streaming, chamadas de ferramenta, saídas estruturadas, imagens de entrada e tokens de raciocínio passam sempre que o modelo escolhido suporta.
Limites de gasto em três níveis
Você põe teto em uma chave, em uma pessoa ou no workspace inteiro, e define quanto a conta pode gastar por minuto, 50 dólares por padrão. Requisições acima de um limite são recusadas. O dono também congela todo o gasto com um interruptor, o que ajuda quando um agente entra em loop e você prefere pará-lo a depurá-lo às três da manhã.
Perfis de roteamento com reservas ordenadas
Um perfil de roteamento nomeia o modelo principal e as reservas na ordem que você quiser. A Hopscotch tenta de novo, desce a lista e, nas requisições de chat, faz uma última tentativa em um provedor de reserva. O fallback de modelos nunca troca por um nome que você não escolheu.
Chaves próprias de provedor
Usar chaves próprias é um recurso do plano Growth em diante. Você adiciona uma credencial da OpenAI ou da Anthropic que já paga e as requisições desse provedor correm na sua conta, com a fatura chegando direto do provedor. A Hopscotch não cobra essas chamadas e mantém limites e registros. Se a sua chave falhar, ela não troca em silêncio para a compartilhada.
Custo por requisição e log de atividade
Cada requisição entra no log com modelo, provedor, tokens, custo, velocidade e resultado. Seu código consulta os mesmos números pelo endpoint de uso, então um painel de custos dispensa um segundo pipeline. Requisições com falha não são cobradas.
Guardrails e retenção zero de dados
Os guardrails são aplicados por chave e cobrem teto de gasto, regra de retenção e checagens do prompt antes de o modelo ver a requisição. Retenção zero é o padrão para prompts e respostas, e o log guarda apenas os metadados em volta.
Prós e contras
Prós
- O preço por token é o de tabela de cada provedor, e a taxa da plataforma está em 0% hoje.
- Existem limites por chave, por colega e por workspace, com teto padrão de 50 dólares por minuto na conta.
- Migrar é trocar a URL base e o nome do modelo, então o código atual do SDK da OpenAI segue rodando.
- O fallback de modelos fica em um perfil de roteamento em vez de ser escrito dentro da lógica da aplicação.
- Prompts e respostas não são armazenados por padrão, e requisições com falha não são cobradas.
Contras
- O crédito é pré-pago, então todo workspace novo precisa de recarga antes da primeira requisição.
- Recursos hospedados no provedor, como busca na web, áudio e ferramentas, não atravessam o gateway.
- Embeddings ainda não são servidos, então um pipeline de recuperação continua precisando de integração direta.
- Os passes com desconto são oferta limitada aos primeiros 1.000 usuários, e cada assento tem teto de uso a cada 5 horas e a cada semana.
Perguntas frequentes
Não. Você paga a tarifa de tabela do provedor por token, e a taxa da plataforma está em 0%, então 100 dólares compram 100 dólares de crédito utilizável.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Hopscotch AI.
Alternativas a Hopscotch AI

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.