

HunyuanVideo-Avatar
Tencent Hunyuan · Imagem · Vídeo
HunyuanVideo-Avatar é o modelo aberto da Tencent que vira uma imagem e um áudio em um vídeo falado ou cantado, com controle de emoção e várias pessoas na cena.
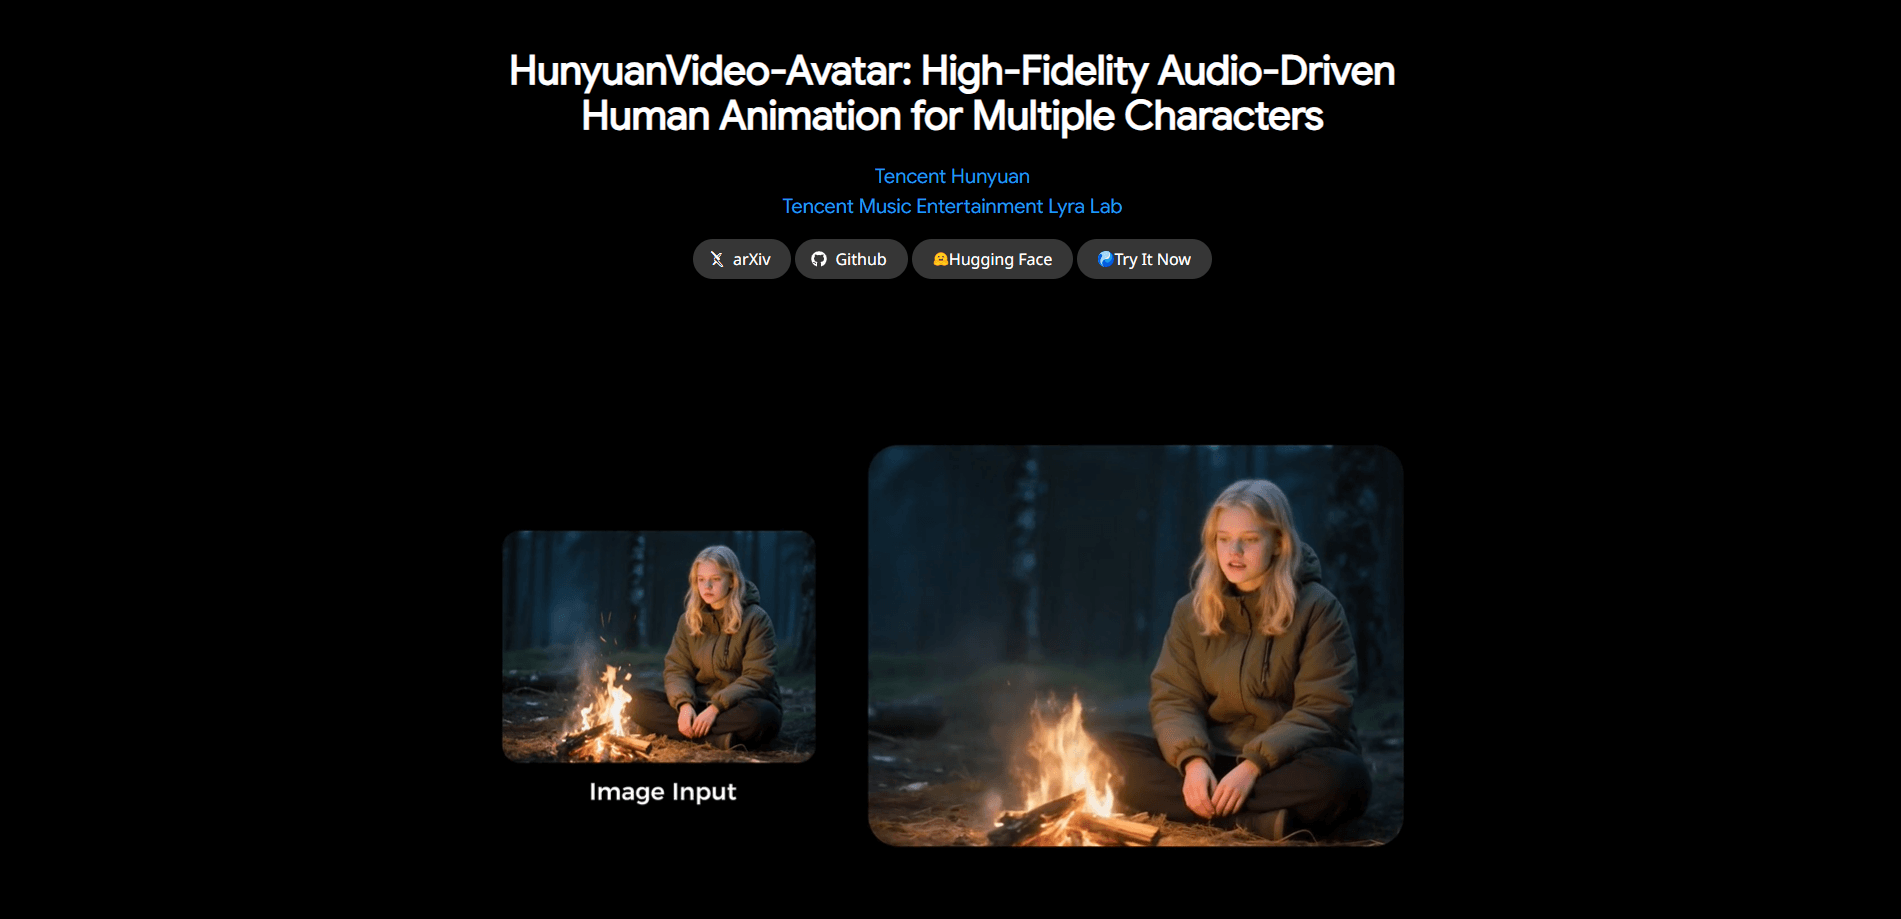
Sobre HunyuanVideo-Avatar
What Is HunyuanVideo-Avatar
HunyuanVideo-Avatar é um modelo aberto de animação humana guiada por áudio, feito pela Tencent Hunyuan junto com a equipe MuseV do Lyra Lab da Tencent Music e lançado em maio de 2025. Você entrega um único retrato e uma faixa de áudio, e ele devolve um vídeo em que o rosto se move, os lábios acompanham a fala e o personagem mantém a mesma identidade do primeiro ao último quadro.
Quase toda ferramenta de sincronia labial para na boca. Esta move o quadro inteiro, de cabeça e ombros até o corpo todo, e ainda lê a emoção de uma imagem de referência, então o mesmo clipe pode sair alegre ou sério. Também dá conta de várias pessoas em uma cena, cada uma presa à sua própria faixa de áudio, que é justamente onde os modelos anteriores misturavam os rostos. A saída chega a 720p, e o laboratório oficial limita o envio a cerca de 14 segundos de áudio.
Não é um site de um clique para qualquer um. O modelo vem como código e pesos que você baixa e roda sozinho, então, para usá-lo direto, precisa de uma GPU NVIDIA e de um ambiente Python em ordem. Há uma prévia hospedada no site da Hunyuan, da Tencent, mas os recursos mais fundos com vários personagens vivem na versão aberta. Os direitos e o consentimento de qualquer rosto ou voz que você anima são seus, não do modelo.
Getting Started
- Acesse o repositório oficial no GitHub e clone-o, depois monte um ambiente Python 3.10 com uma GPU NVIDIA compatível com CUDA.
- Instale as dependências de PyTorch e FlashAttention que o README lista e baixe os pesos pré-treinados.
- Escolha um retrato nítido e de frente como imagem do personagem, e prepare um áudio limpo de fala ou canto.
- Rode o script de inferência e escolha o modo de uma ou várias GPUs conforme sua máquina e sua memória.
- Revise o vídeo renderizado, ajuste a resolução ou o enquadramento se precisar e exporte o resultado.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de HunyuanVideo-Avatar.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Criadores de vídeo curto
- Desenvolvedores e pesquisadores
- Times de e-commerce e transmissão ao vivo
- Artistas de desenho e 3D
Tarefas
- Transformar um retrato em vídeo falado
- Produzir um clipe cantado
- Controlar a emoção
- Animar uma cena com duas pessoas
- Construir um pipeline próprio
Cenários
- Renovar vídeos de produto rápido
- Fazer um corte em outro idioma
- Transformar um podcast em vídeo
- Prototipar um conceito de avatar
Principais recursos
One Image Plus Audio
O truque de fundo é fácil de dizer e difícil de fazer: você entrega um único retrato e uma faixa de áudio, e o modelo devolve um vídeo em que o personagem fala ou canta com os lábios no tempo certo e um movimento de corpo natural. Ele aceita imagens de tamanhos e resoluções variados, então tanto um recorte fechado quanto um plano de corpo inteiro servem como entrada. Esse é o recurso que economiza um dia de gravação, porque uma foto parada substitui uma atuação filmada.
Emotion-Controllable Expression
Um módulo de emoção por áudio lê os sinais emocionais e os leva ao rosto do personagem, então a expressão segue o clima do áudio em vez de ficar chapada. Uma imagem de referência orienta essa emoção, o que significa que a mesma fala pode soar alegre ou séria conforme o que você entrega. Para quem já viu um avatar rígido ler um roteiro, esta é a parte que faz o resultado parecer vivo.
Multi-Character Dialogue
O modo com vários personagens deixa mais de uma pessoa dividir a cena, cada uma movida pelo próprio áudio, algo que os modelos anteriores tinham dificuldade de manter separado. Um adaptador de áudio sensível ao rosto isola cada face para que a voz de um personagem não vaze na boca do outro. Isso vira um podcast de dois apresentadores ou uma entrevista de vai e volta em um só vídeo, em vez de dois clipes que você alinha à mão. É a razão mais forte para escolher este modelo em vez de uma ferramenta simples de troca de rosto.
Multi-Style and Multi-Scale Characters
O modelo funciona igual em rostos fotorrealistas, desenhos, renderizações 3D e personagens antropomórficos, então um mascote estilizado recebe o mesmo tratamento de lábios e movimento que um apresentador real. Ele também gera em enquadramentos de retrato, meio corpo e corpo inteiro, o que importa quando uma cabeça falante não basta. Menos concessões na entrada significam que você mantém o estilo do seu projeto em vez de se adaptar à ferramenta.
High-Dynamic Video Output
Os clipes gerados carregam movimento tanto no primeiro plano quanto no fundo, não só um rosto colado em uma imagem parada. O personagem se move, a cena muda e o resultado se sustenta até 720p. O preço é o peso: a geração de alta dinâmica é o que deixa o modelo faminto por memória de GPU, então as cenas mais cheias pedem a melhor placa que você tiver.
Open Code and Weights
O código de inferência e os pesos do modelo são publicados abertamente, com licença de uso pessoal e comercial segundo os termos da Tencent. Você pode rodar tudo no seu próprio hardware, ver como funciona e ajustar com os seus dados. Essa abertura é o grande atrativo para times que não querem mandar rostos e vozes a um serviço de terceiros, e é por isso que o modelo se espalhou rápido pela comunidade de pesquisa.
Prós e contras
Prós
- Com uma foto e um áudio basta, então uma imagem parada substitui uma atuação filmada.
- O módulo de emoção por áudio dá ao personagem um clima que segue o som, não uma expressão fixa.
- O suporte a vários personagens mantém cada falante no próprio áudio, o que evita costurar clipes à mão.
- O modelo roda com rostos fotorrealistas, desenhos, 3D e animais, então seu estilo de arte se mantém.
- O código e os pesos abertos deixam os times rodá-lo localmente e ajustá-lo em vez de alugar um serviço fechado.
Contras
- Rodá-lo por conta própria exige uma GPU NVIDIA, e a melhor qualidade recomenda uma placa de 96GB, o que deixa de fora quase qualquer máquina de consumo.
- O laboratório hospedado limita o áudio a uns 14 segundos e é lento para trabalho ao vivo, então clipes longos pedem a montagem local.
- As renderizações são lentas em hardware modesto, então prazos curtos em trabalhos grandes não são realistas sem placas potentes.
- Não há uma API pública anunciada para a versão aberta, então os desenvolvedores têm que construir eles mesmos a camada de serviço.
Perguntas frequentes
HunyuanVideo-Avatar é um modelo aberto da Tencent para animação humana guiada por áudio. Ele pega uma imagem de retrato e um áudio e produz um vídeo em que o personagem fala ou canta com movimento labial e expressão no tempo certo, e consegue lidar com mais de um personagem em uma cena. Vem da Tencent Hunyuan e da equipe MuseV do Lyra Lab da Tencent Music, e saiu em maio de 2025.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a HunyuanVideo-Avatar.
Alternativas a HunyuanVideo-Avatar

X Ray Interpreter
X-ray Interpreter · ImagemO X Ray Interpreter é uma ferramenta de radiologia com IA baseada na web que transforma raios X, tomografias, ressonâncias, ultrassonografias e imagens PET em laudos em linguagem simples. Você envia um exame, recebe uma interpretação preliminar dos raios X em instantes e depois faz perguntas de acompanhamento se algo precisar de explicação. Ele funciona como segunda opinião e como apoio de aprendizado, não como diagnóstico médico.

Aieasypic
AIEasyPic · ImagemO AIEasyPic é um gerador de imagens com IA que transforma prompts de texto simples em obras finalizadas em segundos. Você também pode treinar modelos personalizados com suas próprias fotos, trocar rostos em imagens existentes e criar clipes de vídeo curtos a partir de texto, tudo pelo navegador. Ele serve tanto para criadores casuais que querem imagens rápidas quanto para hobistas que desejam montar um modelo pessoal sem tocar em código.

Chargen
Chargen · ImagemO Chargen é um gerador de personagens com IA e um conjunto de ferramentas de criação de mundos feito para Dungeons & Dragons e outros RPGs de mesa. Ele transforma uma ideia de uma linha em um retrato de personagem pintado, cria NPCs, monstros, mapas e encontros na mesma sessão, e mantém os detalhes de cada criatura à mão. A parte de arte para RPG de mesa funciona com um sistema de créditos chamado Gold, enquanto os geradores de texto seguem gratuitos para todos.