
Kyutai TTS
Kyutai · Voz e linguagem
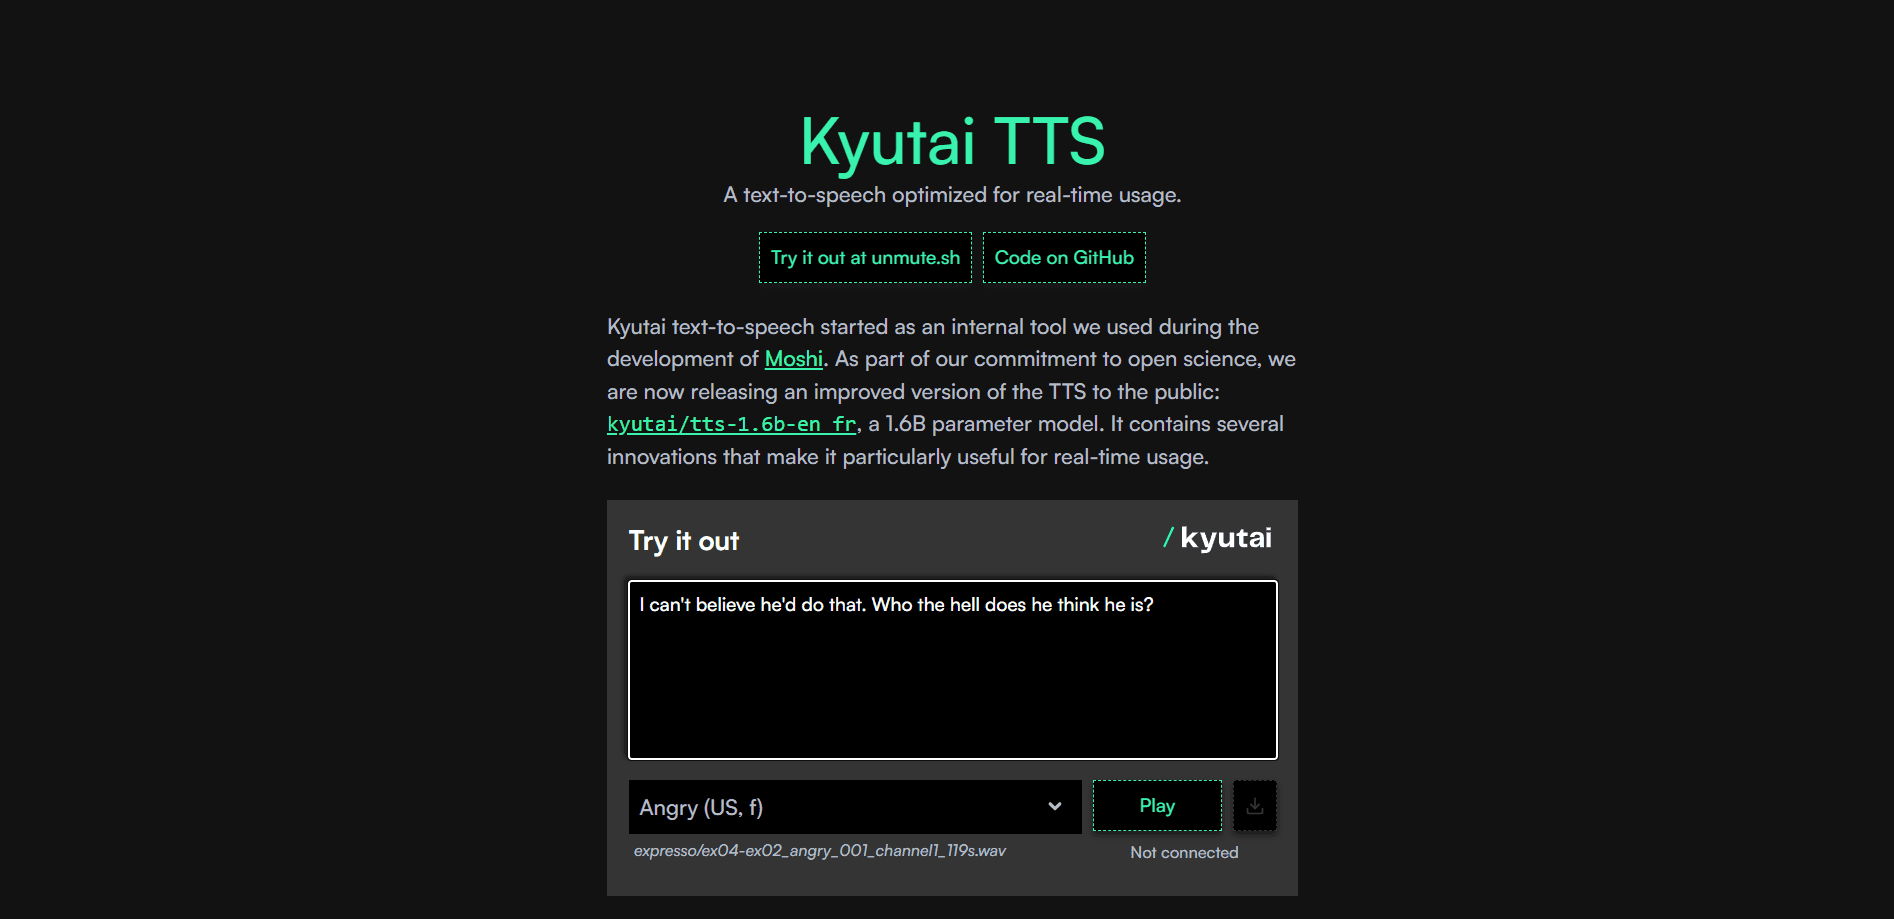
O Kyutai TTS é um modelo de texto para fala em streaming e de código aberto que começa a gerar áudio antes de ter o texto completo, o que mantém a latência baixa em assistentes de voz e apps em tempo real.
Sobre Kyutai TTS
About
O que é o Kyutai TTS
O Kyutai TTS é um modelo de texto para fala feito para streaming. Ele lê texto em voz alta, mas não espera você terminar de digitar. Começa a falar assim que tem as primeiras palavras, e isso o separa dos motores offline que precisam da frase inteira antes de emitir som.
A Kyutai é um laboratório francês de ciência aberta financiado pelo grupo Iliad, pelo grupo CMA CM e pela Schmidt Sciences. O laboratório criou o Kyutai TTS 1.6B, um dos vários modelos de áudio da Kyutai, para o próprio trabalho com o Moshi, um sistema de diálogo por voz, e depois liberou os pesos ao público. Essa versão mira a síntese de voz de baixa latência, algo que a maioria dos motores só faz depois de ler todo o texto. Quem procura ferramentas de voz pode montar um assistente que fala, gerar narração ou adicionar fala a um app sem pagar por caractere.
O ponto importante é como ele alcança essa velocidade. Foi treinado com 2,5 milhões de horas de áudio público e rende melhor em uma GPU, então não é um serviço na nuvem pronto para usar com um preço mensal claro. Você baixa os pesos, prepara um ambiente e executa por conta própria. Existem duas versões: o modelo em streaming de 1.6B que abordamos aqui e o mais recente Pocket TTS, um modelo menor feito para máquinas com CPU.
Como começar
- Crie uma conta grátis no Hugging Face e aceite a licença do modelo na página do Kyutai TTS.
- Instale o pacote moshi do Python com pip, ou o crate moshi-server se for servir em produção.
- Carregue o checkpoint e o codec de áudio Mimi em Python, depois aponte o modelo para um texto de entrada.
- Gere áudio em blocos para tocar em streaming, ou rode sobre um arquivo para uma saída offline.
- Escolha uma voz pronta do repositório tts-voices ou use seu próprio embedding de voz.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Kyutai TTS.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que criam assistentes de voz
- Pesquisadores e estudantes
- Criadores com orçamento apertado
Tarefas
- Respostas faladas em tempo real
- Clonagem de voz para uma identidade fixa
- Geração de narração em lote
Cenários
- Alimentar um agente de voz conversacional
- Adicionar acessibilidade a um app
- Prototipar um produto multilíngue
Principais recursos
Saída em streaming que supera o TTS offline
O Kyutai TTS começa a falar assim que recebe as primeiras palavras de um texto. Os motores offline esperam o texto completo, o que soma segundos de atraso. Em um assistente de voz, essa diferença separa uma conversa fluida de uma pausa estranha.
Baseado em delayed streams modeling
O modelo nasce da pesquisa da Kyutai sobre delayed streams modeling, um método para tarefas em streaming que vão entre texto e fala. Ele usa a mesma arquitetura multistream do Moshi, então os fluxos de texto e áudio se alinham e a geração sai estável e rápida.
Clonagem de voz por embeddings
Você dá ao modelo uma voz específica ao passar um embedding já calculado do repositório tts-voices. A Kyutai escolheu esse caminho em vez da clonagem livre por um motivo. Ela diz que a marca d'água sai fácil em modelos abertos, então limitar a clonagem a embeddings guardados é o caminho mais seguro.
Processamento em lote para alto volume
O modelo agrupa requisições em vez de atender uma voz por vez. A Kyutai relata cerca de 75x de áudio gerado por unidade de computação, e treinou com destilação de CFG para não precisar dobrar o lote ao guiar a saída.
Fala em inglês e francês
O modelo de 1.6B cobre inglês e francês de fábrica. É uma faixa estreita diante de alguns motores comerciais, mas basta para produtos bilíngues e mantém o modelo pequeno o suficiente para auto-hospedar.
Várias formas de implantação
Você pode rodar o modelo de três maneiras. A versão de PyTorch serve para pesquisa e testes, o servidor em Rust aguenta tráfego de produção por websockets e uma versão quantizada roda em máquinas de consumo.
Prós e contras
Prós
- Pesos abertos e grátis com licença permissiva, então não há cobrança por caractere.
- O design em streaming mantém a latência baixa o bastante para conversa ao vivo.
- Processa bem em lote em uma única GPU, o que reduz o custo de atender muitos usuários de uma vez.
- Apoiado por um artigo publicado, um notebook do Colab e um repositório de vozes, então você não parte do zero.
Contras
- Não há API hospedada, então você tem que montar e manter o servidor sozinho.
- Uma GPU é recomendada, o que descarta hospedagem barata para uma carga em tempo real.
- Só aceita inglês e francês, então outros idiomas pedem outro modelo.
- A clonagem de voz se limita a embeddings já calculados, o que bloqueia imitações livres.
Perguntas frequentes
Sim. Os pesos do modelo saem sob CC-BY 4.0, então dá para baixar e rodar sem custo. O que você paga é o hardware onde ele roda.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Kyutai TTS.
Alternativas a Kyutai TTS

Foley
Hanamori Labs, LLC · Voz e linguagem · Produtividade · Assistente de IAFoley é uma lista de tarefas por voz que transforma uma frase falada em tarefa arquivada, com projeto, data e hora já preenchidos, e depois ajuda você a organizar o dia com o que já está anotado.

HireKey
HireKey · Voz e linguagem · Produtividade · AprendizadoHireKey é um copiloto de busca de emprego com IA criado por uma recrutadora de tecnologia. Avalia aderência à vaga, adapta o currículo, treina entrevistas e organiza cada candidatura.

Fluence
Yay Software (Yannick Huchard) · Escrita · Voz e linguagem · ProdutividadeO Fluence é um app de Android que lê em voz alta PDF, EPUB, arquivos do Word e artigos da web, acompanha a frase falada e responde perguntas sobre o texto sem sair do celular.