
LangWatch
LangWatch B.V. · Programação · Marketing
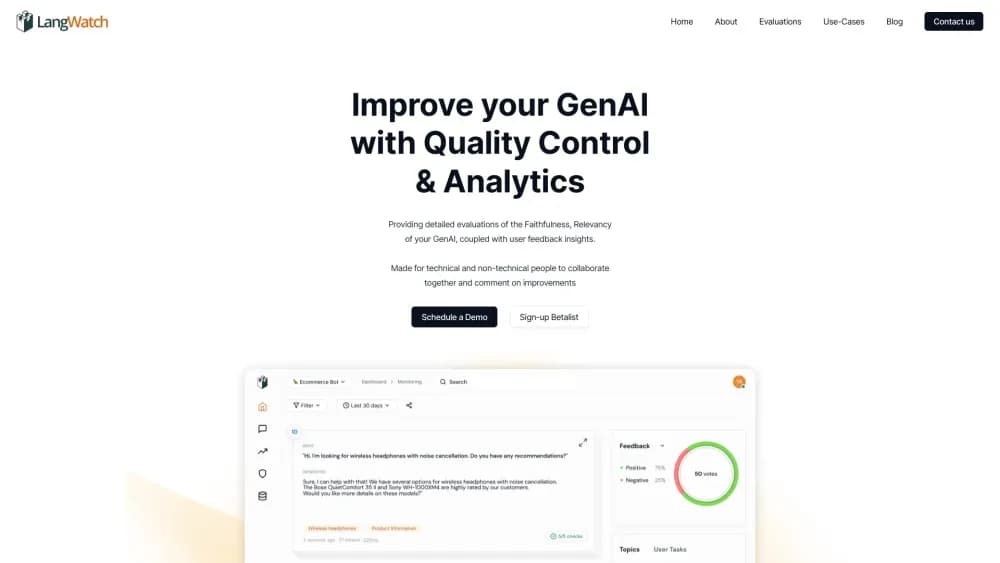
LangWatch é uma plataforma de observabilidade de LLM de código aberto para rastrear, testar e avaliar agentes de IA, com gateway de IA e gestão de prompts no mesmo lugar.
Sobre LangWatch
What Is LangWatch
LangWatch é uma plataforma de LLMOps de código aberto mantida pela LangWatch B.V., empresa sediada em Amsterdã. Ela cobre quatro frentes que costumam ficar em ferramentas separadas: rastreamento de LLM, testes de agentes de IA, avaliação de LLM e gestão de prompts. Por cima disso existe um gateway de IA, então cada chamada de modelo pode passar por um único endpoint com orçamento definido.
O projeto abriu o código em setembro de 2023 e o núcleo continua sob licença Apache 2.0. Você roda a plataforma na sua própria infraestrutura com Docker ou Helm, e o LangWatch Cloud usa o mesmo código. Recursos enterprise, como governança de IA com várias fontes e detecção de anomalias, ficam em uma pasta com licença separada e exigem plano pago.
O buraco que ele tapa é a falta de visibilidade. Quando um agente chega à produção, uma resposta ruim quase nunca vem com explicação. Você precisa saber qual chamada de ferramenta falhou, qual busca voltou vazia e quanto custou a conversa. O LangWatch grava cada etapa como um traço e deixa você reproduzir o caminho. A ressalva: é uma ferramenta para quem desenvolve. Alguém do time precisa ler traços e escrever testes, e não existe um caminho sem código para um product manager trabalhando sozinho.
Primeiros passos
- Crie um projeto em app.langwatch.ai. O plano Developer não pede cartão.
- Conecte sua aplicação com o SDK de Python ou TypeScript, ou aponte um exportador OpenTelemetry para o endpoint de ingestão. LangChain, LangGraph, CrewAI, Mastra e Pydantic AI enviam traços sem reescrever nada.
- Rode o agente uma vez e abra a visão de traços para conferir spans, tokens, latência e a conversa inteira.
- Adicione um avaliador ou um cenário com usuário simulado e bloqueie o merge pela nota dentro do CI.
- Leve os prompts para o gerenciador quando quiser versionamento e testes A/B fora do código.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de LangWatch.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de IA colocando um agente em produção
- Times de plataforma em empresas de porte médio
- Gestores de engenharia de olho no gasto com IA
Tarefas
- Investigar uma resposta errada
- Testar regressões antes de um deploy
- Comparar versões de prompt
- Auditar o uso de assistentes de código
Cenários
- Um agente falha em um segmento de clientes
- Um provedor sobe os preços da noite para o dia
- Um lançamento regulado exige self-hosting
Principais recursos
Rastreamento de LLM em qualquer framework
Cada chamada de LLM, uso de ferramenta, busca e avaliação vira um span dentro de um traço, com spans aninhados e um grafo de execução para o agente. A contagem de tokens e o custo saem automáticos por provedor, prompt e modelo. Os traços se agrupam em sessões por thread, então você lê a conversa inteira em vez de uma requisição isolada. Texto, imagem e áudio também são capturados, o que pesa quando o agente lida com prints ou áudios.
Testes de agentes com usuários simulados
Os testes de agentes de IA começam com um cenário escrito, e um LLM faz o papel de usuário gerando mensagens realistas a partir dele. A execução cobre diálogo de vários turnos em vez de um prompt único. Um agente juiz pontua cada turno e pode marcar aprovação ou reprovação em qualquer ponto. A verificação de chamadas de ferramenta confere se a ferramenta certa entrou na hora certa ao longo da conversa. Há um visualizador para repetir a execução passo a passo e pausar no meio para anotar. Testes de voz rodam com ElevenLabs, OpenAI Realtime, Twilio, Pipecat e Gemini Live, com tempo até o primeiro byte, latência p50 e p95, além de ruído de fundo e interrupções injetadas. Ataques adversariais usam escalada Crescendo e detecção de recusa para achar pontos fracos antes de um usuário achar.
Avaliação de LLM em experimentos e em produção
Os avaliadores embutidos cobrem métricas RAGAS, alucinação, toxicidade, detecção de PII e pontuação com LLM como juiz. Você roda experimentos offline pelo SDK ou por um assistente sem código na interface, depois compara execuções por qualidade, custo e latência. Monitores de produção pontuam o tráfego real e avisam quando a qualidade cai. A pontuação funciona na thread inteira e também em uma mensagem isolada, o que atende bots de suporte e agentes de vários passos. Datasets podem sair de traços reais, ser gerados com IA ou receber imagens, e uma caixa de anotações concentra a revisão humana. Um avaliador próprio pode ser definido uma vez e compartilhado entre projetos, e os mesmos controles rodam embutidos como guardrails.
Gateway de IA com orçamento por time
Um único endpoint fala as APIs da OpenAI e da Anthropic, e roteia para OpenAI, Anthropic, Google, Bedrock, Mistral ou qualquer outro provedor com as suas chaves. Cada chamador recebe uma chave virtual com orçamento próprio, definido por pessoa, time ou cliente final. A empresa fala em 11 microssegundos de sobrecarga. Toda requisição que passa por ali cai como traço no mesmo projeto, então o tráfego do gateway e o do SDK ficam juntos.
Gestão de prompts com versionamento
Prompts são objetos estruturados com mensagens, entradas e configuração, editáveis pelo código, pela interface ou pela API. O modelo Liquid adiciona variáveis e lógica. A sincronização com o GitHub deixa o time revisar uma mudança de prompt como qualquer pull request, e tags marcam as versões de staging e produção. Um playground compara variantes entre modelos, e os testes A/B mostram qualidade, custo e latência por versão. Webhooks e Slack avisam quando um prompt muda.
Acompanhamento de assistentes de código e governança de IA
Um comando, npx langwatch claude, leva Claude Code, Codex, Copilot, Gemini CLI e opencode para o mesmo padrão de observação. As sessões mostram tokens, custo e uso de cache por engenheiro e por repositório, o que responde onde o gasto com IA realmente vai. A parte de governança de IA acrescenta um inventário de cada ferramenta e provedor em uso, regras de anomalia sobre a atividade e um log de auditoria para revisões de segurança.
Prós e contras
Prós
- Núcleo de código aberto: a plataforma Apache 2.0 roda no seu próprio ClickHouse com Docker ou Helm, então os traços não precisam sair da sua rede.
- Quatro ferramentas em uma conta: rastreamento, testes, avaliação e prompts dividem os mesmos traços, o que acaba com o copiar e colar entre fornecedores.
- Cobertura ampla de frameworks: LangChain, LangGraph, CrewAI, Mastra, Pydantic AI, o SDK da Vercel AI e OpenTelemetry enviam traços sem reescrever o agente.
- Plano gratuito que serve: 50 mil eventos por mês, dois usuários e 14 dias de retenção sem custo e sem cartão, o bastante para um protótipo.
- O gateway mantém o controle: chaves de provedor e orçamentos por pessoa ficam na sua conta, e cada chamada roteada já sai rastreada.
Contras
- Ferramenta para devs em primeiro lugar: não existe caminho de arrastar e soltar para montar um agente, e a configuração de avaliações pede Python ou TypeScript.
- A cobrança por uso precisa de atenção: o Growth inclui 200 mil eventos e depois cobra €5 por 100 mil, então um agente com muitas ferramentas e buscas consome eventos bem mais rápido que um chatbot simples.
- Self-hosting traz trabalho de operação: ClickHouse e a plataforma ficam sob sua responsabilidade, e as atualizações também, a menos que você pague suporte Enterprise.
- Governança e SSO ficam no Enterprise: SSO próprio, RBAC, logs de auditoria e mascaramento de dados não aparecem no Growth, o que deixa times regulados de fora até negociarem.
Perguntas frequentes
LangWatch é uma plataforma de código aberto para observar, testar e avaliar aplicações LLM. Ela registra traços de agentes, executa conversas simuladas, pontua a qualidade das respostas e gerencia versões de prompts em um único painel.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a LangWatch.
Alternativas a LangWatch

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.