
LFM2
Liquid AI · Outros
O LFM2 é uma família de modelos de linguagem pequenos da Liquid AI feita para rodar no próprio aparelho. Os checkpoints de 350M, 700M e 1.2B rodam rápido em qualquer CPU.
Sobre LFM2
What Is LFM2
O LFM2 é a segunda geração dos modelos fundacionais da Liquid AI, lançada em julho de 2025. A empresa nasceu do laboratório CSAIL do MIT e cria modelos que trocam tamanho bruto por velocidade e eficiência de memória. O LFM2 vem em três checkpoints densos: 350M, 700M e 1.2B de parâmetros. Cada um é pequeno o bastante para rodar em um celular, um notebook ou o sistema de um carro sem um data center por trás.
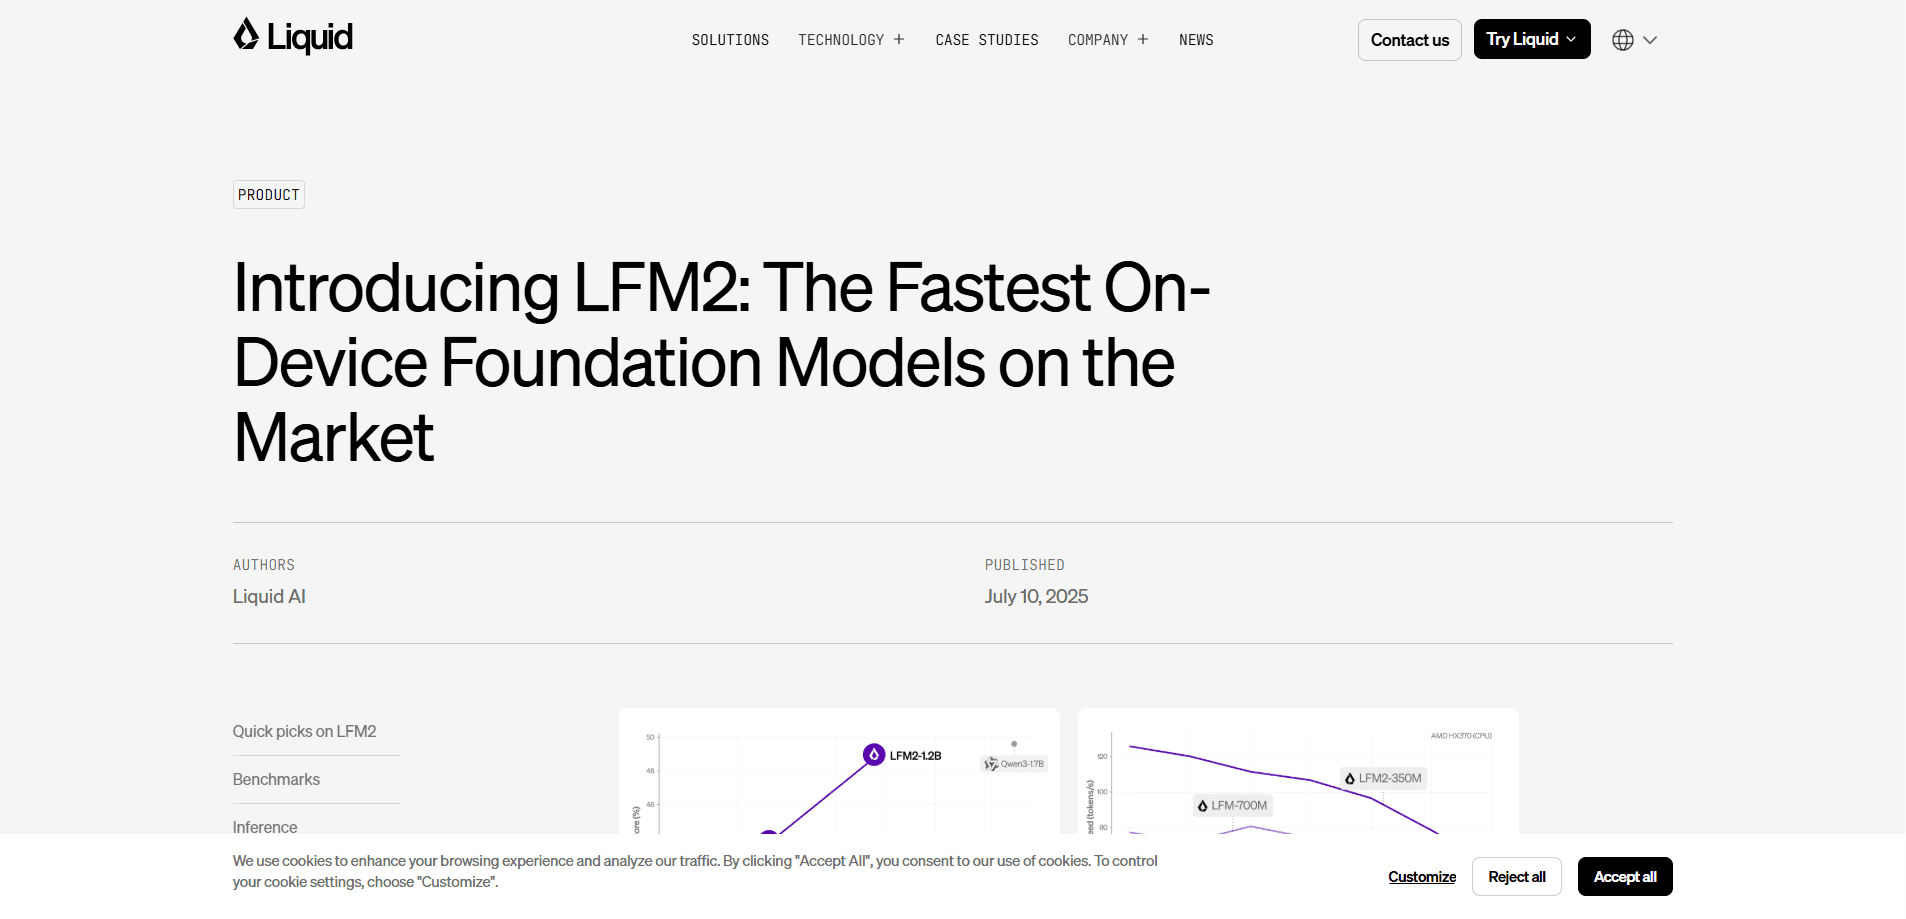
A proposta é simples. Modelos na nuvem são poderosos, mas lentos e caros de manter em escala, além de mandar seus dados para fora do aparelho. O LFM2 quer manter a IA útil em casa, onde as respostas voltam em milissegundos e nada sai da máquina. Segundo a Liquid AI, os modelos fazem decode e prefill duas vezes mais rápido que o Qwen3 numa CPU, e o pipeline de treinamento é 3 vezes mais eficiente que o da primeira geração LFM.
O detalhe é que modelo pequeno tem pouco conhecimento. A Liquid AI recomenda ajustar o LFM2 para tarefas fechadas, como extração de dados, RAG ou chat de vários turnos, e avisa que ele não serve para trabalho pesado de conhecimento, como raciocínio profundo ou programação complexa. Trate o LFM2 como uma peça rápida e privada, não como um assistente que sabe tudo.
Getting Started
- Escolha um checkpoint no Hugging Face que caiba no seu hardware, do 350M para aparelhos minúsculos ao 1.2B para um notebook ou uma GPU avulsa
- Baixe os pesos ou use um formato quantizado como GGUF para o llama.cpp se quiser uma pegada ainda menor
- Rode em local com um framework compatível, como llama.cpp, ExecuTorch ou as ferramentas padrão do Transformers
- Ajuste o modelo com um framework como o TRL sobre seus próprios dados se um checkpoint geral não cobrir sua tarefa, e depois leve essa versão ao aparelho
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de LFM2.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores de apps que criam recursos locais
- Equipes com restrição de privacidade
- Hobbistas e curiosos
- Startups abaixo de US$ 10 milhões de receita
Tarefas
- Fluxos agênticos
- Extração de dados
- Geração aumentada por recuperação
- Chat de vários turnos
- Apoio à escrita criativa
Cenários
- Um app de celular precisa responder sem conexão
- Um usuário de notebook quer escrever em local
- Um fabricante leva IA a um aparelho apertado
- Uma equipe regulada precisa manter os dados em casa
- Um desenvolvedor prototipa um agente no sistema do carro
Principais recursos
Arquitetura híbrida de convolução e atenção
O LFM2 mistura convoluções curtas com atenção de consultas agrupadas em vez de se apoiar só na atenção. Cada modelo empilha 16 blocos: 10 de convolução de curto alcance com portão duplo e 6 de atenção de consultas agrupadas. O desenho captura padrões locais a baixo custo e recorre à atenção só onde ela rende, o que mantém baixas a latência e a memória no hardware que de fato vai dentro de celulares e notebooks.
Velocidade em CPUs comuns
A grande promessa é a vazão, não a precisão bruta. Segundo a Liquid AI, o LFM2 faz decode e prefill duas vezes mais rápido que o Qwen3 numa CPU, e o modelo pequeno de 700M segue mais rápido que um Qwen 0.6B tanto no llama.cpp quanto no ExecuTorch mesmo carregando mais parâmetros. Essa diferença pesa num celular ou num notebook fino, onde a CPU é o único chip com que dá para contar.
Quatro tamanhos para aparelhos diferentes
A família cobre 350M, 700M, 1.2B e 2.6B de parâmetros, então você casa o modelo com o aparelho. A versão de 350M entra em wearables e alvos embarcados apertados, enquanto o checkpoint de 1.2B roda num notebook ou numa GPU avulsa e compete com modelos que carregam muito mais parâmetros. Como é uma família pensada para o limite, uma única arquitetura em vários tamanhos deixa você subir ou descer um recurso sem reescrevê-lo.
Benchmark LFM2 competitivo em escala pequena
Segundo a Liquid AI, o LFM2-1.2B rende à altura do Qwen3-1.7B, um modelo com 47% mais parâmetros, e suas notas ficam perto de modelos muitas vezes maiores. O checkpoint de 700M supera o Gemma 3 1B IT, e o de 350M briga de igual para igual com o Qwen3-0.6B e o Llama 3.2 1B Instruct. Nos testes de vários turnos da própria empresa, os juízes preferiram o modelo de 1.2B em relação ao Llama 3.2 1B Instruct e ao Gemma 3 1B IT.
Pesos abertos e licença flexível
A Liquid AI publica os pesos no Hugging Face sob uma licença aberta baseada na Apache 2.0. O uso acadêmico e de pesquisa é grátis, e empresas com menos de US$ 10 milhões de receita podem usar os modelos comercialmente sem pagar nada. Acima desse limite, você fala com a Liquid AI para uma licença comercial, o que mantém os termos simples para equipes pequenas e deixa espaço para acordos com empresas grandes.
Compatibilidade ampla de ferramentas
O LFM2 exporta para os frameworks que os desenvolvedores já usam. Roda no llama.cpp para inferência local, no PyTorch via ExecuTorch para celular e com as ferramentas padrão do Transformers para treinar. O ajuste com TRL é um caminho suportado, e as versões GGUF facilitam colocar os modelos em apps de inferência que você já tem.
Contexto de 32K e treinamento multilíngue
Cada checkpoint lida com uma janela de contexto de 32.768 tokens, o suficiente para documentos longos e chats extensos. O treinamento usou 10 trilhões de tokens divididos em cerca de 75% de inglês, 20% multilíngue e 5% de código, com foco extra em japonês, árabe, coreano, espanhol, francês e alemão. Isso faz do LFM2 uma opção razoável para apps que atendem mais de um idioma.
Prós e contras
Prós
- Roda rápido nas CPUs que já estão dentro de celulares, notebooks e carros, então você não precisa de GPU nem de serviço na nuvem
- Os checkpoints pequenos mantêm baixa a memória, algo que encaixa em wearables e outros alvos embarcados apertados
- Suas notas igualam ou batem modelos maiores como o Qwen3-1.7B e o Gemma 3 1B IT com uma fração do tamanho
- Pesos abertos e licença comercial gratuita para empresas abaixo de US$ 10 milhões de receita barateiam o começo
- Funciona com ferramentas conhecidas como llama.cpp, ExecuTorch e TRL, então adotá-lo não exige reescrever nada
Contras
- Modelos pequenos carregam menos conhecimento de mundo, então raciocínio profundo ou programação complexa ficam fora do terreno deles
- A Liquid AI recomenda ajuste para casos fechados, o que adiciona trabalho antes de você ver os melhores resultados
- A licença comercial exige um acordo pago quando sua empresa passa de US$ 10 milhões de receita, então escalar tem um custo
- Já existem checkpoints LFM2.5 mais novos e variantes maiores, então os três tamanhos originais não são mais a opção mais recente
Perguntas frequentes
O LFM2 é feito para IA no dispositivo, onde um modelo pequeno roda em local em vez de na nuvem. Os usos típicos incluem fluxos agênticos, extração de dados, geração aumentada por recuperação, chat de vários turnos e apoio à escrita criativa. A Liquid AI orienta os desenvolvedores para tarefas fechadas e bem definidas, não para raciocínio de uso geral.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a LFM2.
Alternativas a LFM2
BinkBink
BinkBink · OutrosO BinkBink é uma plataforma de jogos online gratuita e um criador de jogos com IA que deixa qualquer pessoa transformar uma breve descrição em texto em um jogo de navegador jogável. Você pode entrar em centenas de jogos feitos pela comunidade. Ou descreve a sua própria ideia, joga em segundos e compartilha com amigos. Quer criar seu próprio jogo? Não precisa programar. Sem configurar motor, sem download, sem complicação.

Audiogen
Audiogen Inc. · OutrosO Audiogen é um gerador de música com IA criado pela Audiogen Inc., uma equipe de pesquisa pequena que passou cerca de 2,5 anos treinando o próprio modelo de música generativa e desenhando uma interface web em volta dele. Em vez de uma simples caixa de texto, essa ferramenta de música com IA transforma a linha do tempo em uma Estação de Trabalho de Áudio Generativo, ou GAW, voltada para iniciantes, na qual o inpainting, a extensão, a remixagem e a edição de faixas funcionam mais como pintar em uma tela. O produto ainda está em beta, então o acesso passa por uma lista de espera ou por um convite. Os planos pagos ainda não foram publicados.

Aiml API
AIMLAPI OÜ · OutrosA Aiml API é uma API unificada de modelos de IA que coloca mais de 1000 modelos da OpenAI, Google, Anthropic e outros por trás de um único endpoint e uma única fatura. Você escreve código contra um só esquema compatível com OpenAI e depois alterna entre modelos de chat, imagem, vídeo e áudio mudando uma string de modelo. Ela serve para desenvolvedores e equipes pequenas que querem acesso multimodelo sem administrar uma dúzia de contas de fornecedor separadas, e elimina a dor de cabeça comum de faturamento que vem com testar vários fornecedores. Uma chave cobre tudo.