
Liquid Inference
Architect Financial Technologies Inc. · Programação · Produtividade
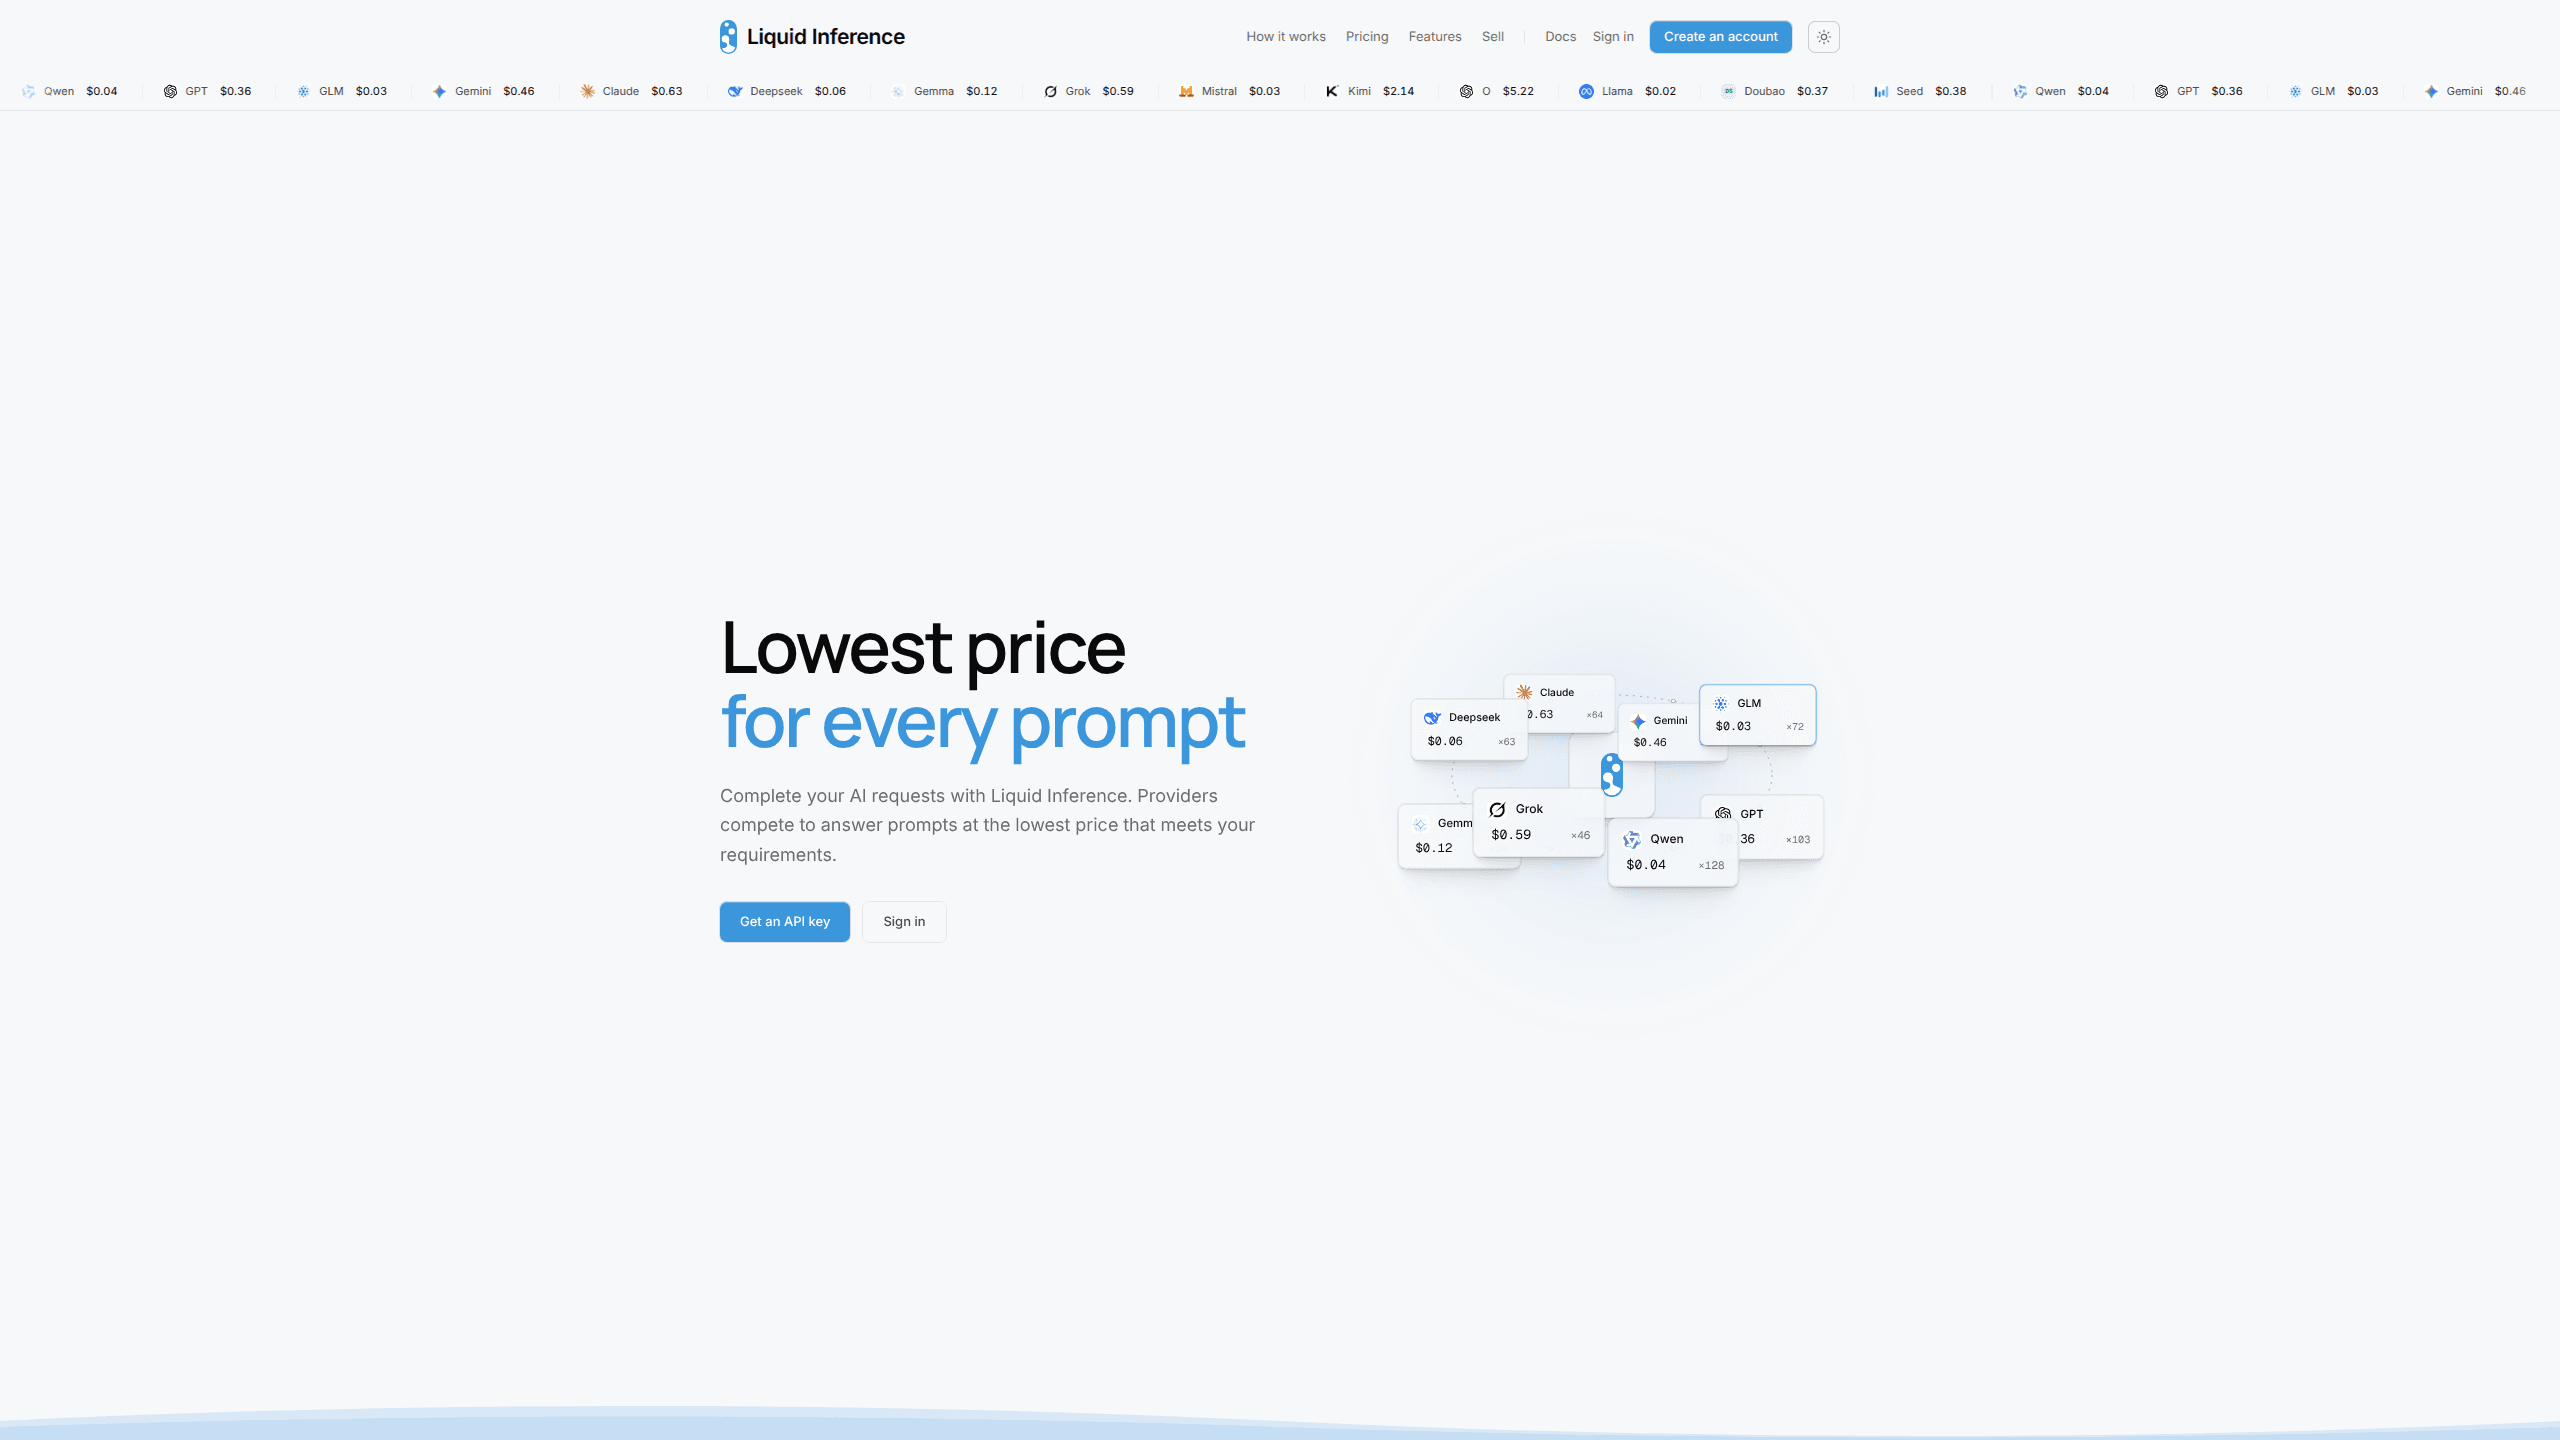
Liquid Inference é um mercado de inferência de IA da Architect que leiloa cada requisição e a envia ao provedor mais barato que atenda às suas regras.
Sobre Liquid Inference
About
O que é o Liquid Inference
Liquid Inference é um roteador de LLM que opera como um mercado. Cada provedor publica uma oferta com preço por token para os modelos que atende, e a sua requisição vai para a oferta mais barata que cumpre as suas condições. Dá para usar pelo chat no navegador ou pela API de inferência, que aceita o formato da OpenAI e o da Anthropic. Também atua como roteador de modelos: você escolhe o nome e o mercado decide quem atende.
O problema que ele ataca está na conta, não no modelo. Quase todo time paga a tabela de um provedor fechado mesmo quando vários vendors servem o mesmo modelo aberto. Aqui o teto de preço é fixado antes do primeiro token, o valor que sobra volta para o saldo e cada job gera um recibo com o provedor vencedor e a cobrança final.
Vale conhecer os limites antes de migrar uma carga de trabalho. O mercado abriu em outubro de 2026, então o número de vendedores e os modelos listados ainda mudam. A qualidade varia conforme quem ganha, e por isso as regras incluem latência, throughput e região. Existe ainda um piso por token que, em modelos muito baratos, pesa mais do que os 5% anunciados.
Como começar
- Crie uma conta em liquidinference.ai. O cadastro abre um workspace com saldo, chaves de API e recibos, além de um crédito inicial para testar sem cartão.
- Gere uma chave na página de chaves. O segredo aparece uma única vez, então copie antes de fechar o painel.
- Aponte seu cliente da OpenAI ou da Anthropic para a URL base do mercado e troque a chave. Os nomes de modelo precisam ser os que a plataforma lista.
- Se quiser, acrescente um objeto
exchangeao corpo da requisição para definir teto de gasto, prazo até o primeiro token, política de retenção ou lista de provedores permitidos. - Leia o campo
exchangeda resposta ou abra o recibo para ver qual provedor ganhou e quanto custou o job.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Liquid Inference.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que rodam agentes de código
- Startups com volume imprevisível
- Engenheiros de plataforma que precisam de comprovação
- Donos de GPU com capacidade ociosa
Tarefas
- Processos em lote com limite de gasto
- Comparar modelos com o mesmo prompt
- Pipelines de RAG e busca
- Comprar imagens, fala ou transcrições
Cenários
- Um loop de agente entra em repetição e a conta sobe
- Um provedor cai no meio de uma rodada longa
- Um time procura a API de LLM mais barata para uma ferramenta interna e não consegue testar cada vendedor
Principais recursos
Um leilão em cada requisição
Cada requisição entra em um livro de ofertas ao vivo. A plataforma descarta as que violam seus limites, ordena o resto por custo estimado mais a espera prevista e entrega o job à melhor. O preço é travado antes da geração, então o pior cenário aparece antes da fatura.
Regras de compra sob seu controle
Um objeto exchange opcional carrega as condições. Você define teto em dólares, tempo máximo até o primeiro token, throughput mínimo, regiões aprovadas, retenção zero e listas de provedores ou modelos autorizados. Só concorrem as ofertas que atendem a tudo, e a política vira campo da requisição em vez de chamado para o suporte.
Troca de provedor antes do primeiro token
Se o vencedor falha antes de escrever qualquer saída, a plataforma move o job para a oferta seguinte. Depois que a saída começa, não há troca, então uma resposta nunca mistura dois modelos. Essa diferença importa em agentes com streaming, onde uma mudança no meio do fluxo quebraria chamadas de ferramenta já enviadas.
Recibos e dados de mercado públicos
Todo job liquidado tem um recibo com vencedor, teto, consumo e taxa. Quem tem conta também vê o livro de ordens ao vivo, as cotações por provedor e as operações fechadas. É possível consultar esses dados pela API antes de enviar a requisição, útil para saber se um modelo está sendo negociado acima do preço habitual.
Roteador automático e roteamento por eixo
Com liquid.auto, a plataforma escolhe o modelo pela nota publicada e pela cobrança estimada dentro do seu teto, com variantes premium, balanced e economy. Outra opção é usar um sufixo no nome do modelo para ordenar por mais inteligente, mais rápido ou mais barato. Nos dois casos o leilão continua por baixo, então o preço vem de vendedores que competem.
Funciona com seu stack atual
Os endpoints formam uma API compatível com OpenAI para Chat Completions e Responses, além de uma rota Anthropic Messages. Os SDKs oficiais funcionam depois da troca da URL base. Há guias para Claude Code, Codex, Cursor, Cline, Open WebUI, n8n, Dify, LangChain e muitas outras ferramentas. A CLI do Liquid sobe um agente de código no terminal com a mesma chave.
Um lado vendedor para donos de GPU
Provedores registram deployments, definem preço por modelo e cotam durante uma sessão. A plataforma distribui jobs, mede o consumo e liquida os pagamentos. Quem tem GPUs paradas consegue monetizá-las sem construir cobrança própria, e quem já vende em outro lugar pode listar o mesmo deployment aqui como segunda praça.
Prós e contras
Prós
- O teto é travado antes da geração, então um prompt com limite de saída enorme não vira conta surpresa.
- Você mantém seu SDK e seu cliente. Na maioria dos casos a migração é URL base e chave, não reescrita.
- As regras de compra cobrem latência, região e retenção de dados, o que torna o mercado viável para cargas com exigências de compliance.
- Recibos e livro público registram quanto custou cada job e quem atendeu.
- O lado vendedor dá aos donos de GPU uma forma de ocupar capacidade ociosa sem montar cobrança própria.
Contras
- O mercado é novo. Abriu em outubro de 2026 e tem menos vendedores que roteadores já consolidados, com cobertura de modelos que pode mudar sem aviso.
- O piso de US$ 0,01 por milhão de tokens pesa em ofertas baratas e gratuitas. Em um modelo econômico, a taxa efetiva pode chegar perto da metade do que o provedor cobra.
- A qualidade depende de quem ganha. O leilão otimiza preço e desempenho declarado, não a qualidade de uma resposta específica, e nota alta não garante resultado melhor.
- A requisição não pode trocar de provedor depois que a saída começa. Se o vendedor piora no meio do fluxo, sobra uma resposta parcial e uma nova tentativa.
Perguntas frequentes
Liquid Inference é um mercado de inferência de LLM da Architect Financial Technologies. Provedores publicam preços para os modelos que atendem e cada requisição vai para a oferta mais barata que cumpre as regras de custo, velocidade, região e dados do comprador. Funciona pela web, por API e por CLI.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Liquid Inference.
Alternativas a Liquid Inference

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.