
LiteLLM
BerriAI · Programação · Outros
O LiteLLM é um gateway de IA e uma biblioteca Python de código aberto que chama mais de 100 LLMs com uma única interface no formato OpenAI, com roteamento, controle de gastos e barreiras de segurança.
Sobre LiteLLM
What Is LiteLLM
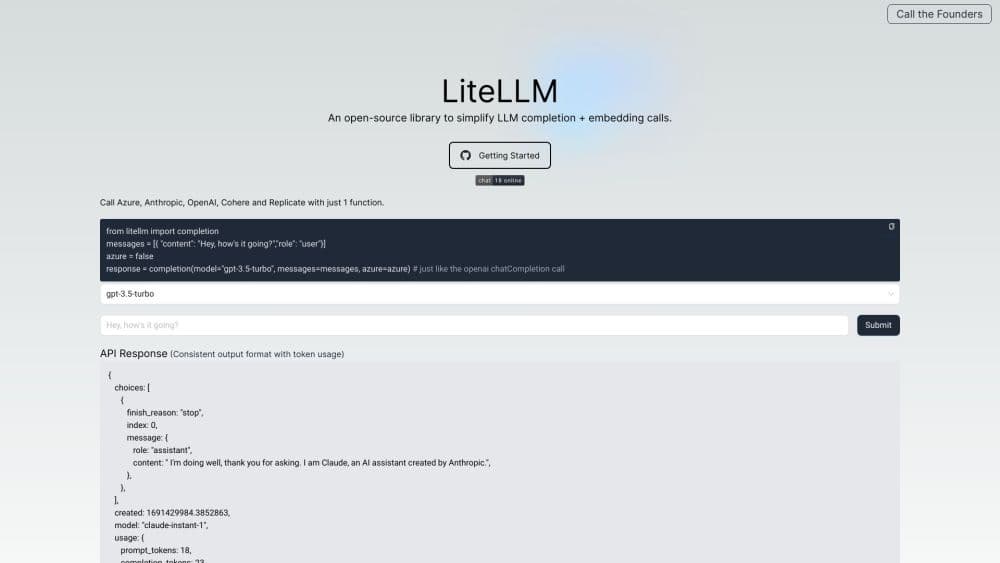
O LiteLLM é uma ferramenta da BerriAI que dá aos desenvolvedores uma única interface para chamar modelos da OpenAI, Anthropic, Gemini, Bedrock, Azure, Ollama e dezenas de outros provedores. Em vez de aprender um SDK, um padrão de autenticação e um formato de resposta diferentes para cada fornecedor, você escreve uma chamada e troca o nome do modelo quando quer mudar de backend.
O problema que ele resolve é a dependência de um único provedor. Equipes que constroem sobre uma plataforma só costumam descobrir que trocar de modelo significa reescrever construtores de requisição, tratamento de erros e lógica de streaming em todo o código. O LiteLLM coloca uma camada de tradução por baixo do seu código, de modo que a lógica de negócio continua igual enquanto o modelo por trás muda em um arquivo de configuração.
Há duas formas de usar o LiteLLM e, juntas, elas cobrem quase todas as necessidades. O SDK de Python entra em um aplicativo existente como um pacote, enquanto o gateway (servidor proxy) roda como serviço auto-hospedado que centraliza chaves virtuais, orçamentos e logs para uma equipe inteira. O preço dessa comodidade é que o gateway acrescenta infraestrutura para manter, e a versão de código aberto espera que você mesmo a hospede e atualize.
Getting Started
- Instale o pacote com
uv add litellmoupip install litellme defina as chaves de API dos seus provedores como variáveis de ambiente. - Para o caminho do SDK, importe
completione chame com um nome de modelo comoopenai/gpt-4oouanthropic/claude-sonnet-4, passando sua lista de mensagens. - Para o caminho do gateway, rode
litellm --model gpt-4oou implante a imagem Docker e depois aponte qualquer cliente OpenAI para a URL base local. - Adicione uma configuração de Router quando quiser tentativas e fallbacks entre vários deploys, e conecte Postgres e Redis se rodar mais de uma instância do gateway.
- Acompanhe o uso pelo painel de administração ou por um callback, e defina orçamentos por chave, usuário ou equipe conforme o tráfego cresce.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de LiteLLM.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de backend
- Equipes de plataforma e de ML
- Gerentes de produto que fazem testes
Tarefas
- Acesso unificado a modelos
- Controle de custos
- Tolerância a falhas e balanceamento de carga
- Observabilidade
Cenários
- Uma startup que começou com um provedor e quer adicionar modelos mais baratos sem mexer na lógica de negócio.
- Uma empresa que roda um gateway auto-hospedado para manter o tráfego de modelos e as chaves dentro da própria infraestrutura.
- Uma sessão de prototipagem em que um único script testa o mesmo prompt com cinco modelos diferentes.
Principais recursos
API unificada para mais de 100 provedores
Uma única interface cobre OpenAI, Anthropic, Gemini, Bedrock, Azure, Vertex AI, Ollama, vLLM e muitos outros. Todas as respostas chegam no formato chat completions da OpenAI, então o código que lê choices[0].message.content continua funcionando depois que você troca de provedor.
Compatibilidade direta com a OpenAI
Projetos que já usam o SDK da OpenAI podem apontar o cliente para um gateway do LiteLLM mudando a URL base e a chave. Não é preciso mexer no código das requisições, o que faz disso uma forma de baixo risco de adicionar suporte a vários modelos em um aplicativo em produção.
Servidor proxy e gateway de LLM
O gateway auto-hospedado funciona como ponto de controle central para uma equipe. Ele gerencia chaves virtuais, registra o gasto por chave, usuário, equipe e organização, aplica limites de RPM e TPM e vem com um painel de administração para o dia a dia.
Router com tentativas e fallbacks
O módulo Router coordena vários deploys do mesmo modelo. Ele repete chamadas que falharam, recorre a um deploy saudável quando um provedor cai e distribui a carga entre backends para que um endpoint lento não trave o aplicativo inteiro.
Controle de gastos e orçamentos
O LiteLLM calcula o custo de cada chamada e o registra na chave ou no projeto que a fez. As equipes podem definir orçamentos mensais e limites de taxa e depois revisar o gasto sem construir o próprio sistema de medição.
Observabilidade e barreiras de segurança
Uma única linha de callback envia logs, contagens de tokens e traces para Langfuse, MLflow, Helicone e outras ferramentas. As barreiras de segurança permitem filtrar ou bloquear entradas e saídas inseguras, e a conversão de erros mantém as exceções de cada provedor em tipos conhecidos da OpenAI.
Prós e contras
Prós
- Uma interface no formato OpenAI elimina a necessidade de aprender um SDK diferente para cada provedor de modelos.
- As trocas de modelo acontecem na configuração, o que reduz o risco de um switch de provedor quebrar o código em produção.
- O núcleo de código aberto é gratuito sob licença MIT e pode rodar totalmente auto-hospedado.
- As tentativas e fallbacks do Router melhoram a disponibilidade quando um provedor tem uma queda.
- O controle de gastos e os orçamentos dão às equipes visibilidade sobre um gasto que muitas vezes passa despercebido.
Contras
- O gateway é mais um serviço para implantar, monitorar e atualizar, e isso acrescenta trabalho operacional para equipes pequenas.
- Rodá-lo em várias instâncias exige Postgres e Redis, então um deploy sério carrega necessidades reais de infraestrutura.
- Recursos como SSO, SCIM, logs de auditoria e deploy em rede isolada ficam atrás do plano Enterprise pago.
- As particularidades de provedores novos podem chegar depois dos SDKs oficiais, então endpoints pouco usados às vezes exigem configuração extra.
Perguntas frequentes
O LiteLLM permite que um aplicativo chame muitos provedores de LLM diferentes por uma única interface no formato OpenAI. Os desenvolvedores usam para não reescrever código a cada troca de modelo e para centralizar chaves, orçamentos e logs atrás de um gateway auto-hospedado.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a LiteLLM.
Alternativas a LiteLLM

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.