
LlamaIndex
LlamaIndex, Inc. · Marketing · Outros
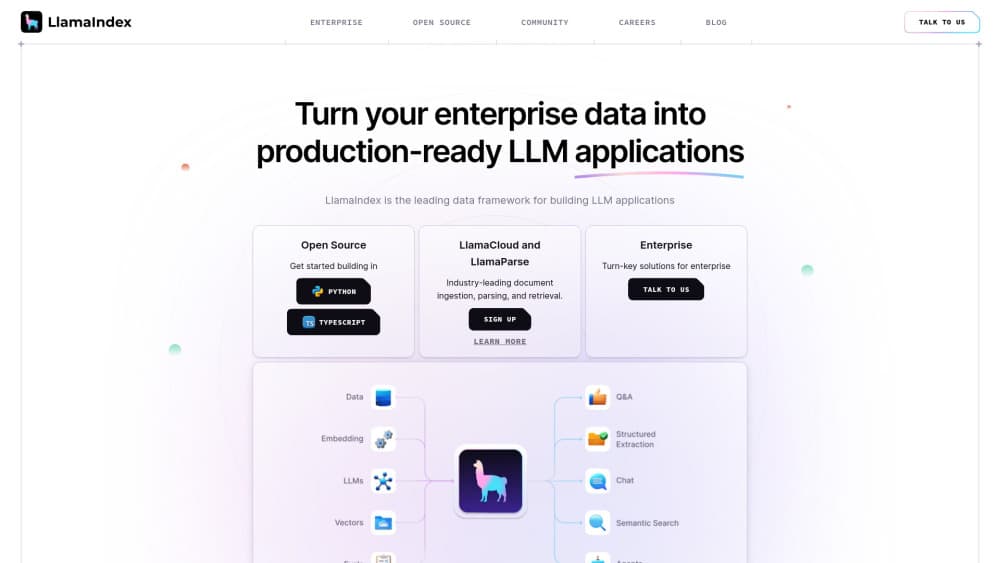
LlamaIndex é um framework de dados de código aberto para apps RAG e agentes de IA. Você carrega seus arquivos, cria índices e entrega contexto limpo ao modelo que já usa.
Sobre LlamaIndex
About
O que é o LlamaIndex
LlamaIndex é uma biblioteca de código que fica entre os seus documentos e um modelo de linguagem. O projeto nasceu no fim de 2022 como GPT Index, adotou o nome atual em 2023 e hoje é mantido pela LlamaIndex, Inc., em São Francisco. A licença é MIT, então você pode ler o código, criar um fork e embarcar tudo em um produto comercial sem pedir autorização.
O problema que ele resolve é chato e permanente. O modelo conhece a web pública, não os seus contratos, tickets de suporte ou cadernos de laboratório. O LlamaIndex entrega o encanamento para carregar esses arquivos, dividi-los em nós, guardá-los em um índice vetorial ou em um índice de palavras-chave e trazer de volta os trechos certos quando chega uma pergunta. Esse padrão é RAG, e esta biblioteca é um dos dois nomes que quase todo time compara ao começar.
A empresa vende também o LlamaParse e o LlamaCloud, um serviço hospedado de processamento de documentos, extração e indexação. A divisão importa: o framework não custa nada, enquanto as peças que transformam um PDF escaneado em texto aproveitável são comerciais, medidas em créditos e fechadas.
O limite principal é que se trata de uma ferramenta para quem programa. Não existe tela de arrastar e soltar para a parte open source. Você escreve Python ou TypeScript, configura as próprias chaves e investiga a recuperação quando as respostas saem erradas.
Como começar
- Instale o pacote base com
pip install llama-index-coree depois o do provedor do seu modelo, comollama-index-llms-openai. - Guarde a chave de API em uma variável de ambiente, ou aponte Settings.llm para um modelo local se preferir.
- Carregue arquivos com o SimpleDirectoryReader ou com um conector do LlamaHub para Notion, Slack, S3 ou banco de dados.
- Monte um índice persistente, quase sempre vetorial, e salve em disco para não repetir a vetorização a cada execução.
- Envolva o motor de consulta em um Workflow quando surgirem ramificações, novas tentativas ou um segundo agente, e publique como serviço.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de LlamaIndex.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores Python montando o primeiro app RAG
- Engenheiros de IA responsáveis por uma busca documental
- Times de dados atolados em papel escaneado
Tarefas
- Responder perguntas sobre documentação interna
- Processar notas fiscais, contratos e relatórios
- Construir agentes de IA com várias etapas
- Testar estratégias de recuperação
Cenários
- Um piloto de base de conhecimento dentro da empresa
- Revisão de literatura e patentes
- Um produto recém-criado sem verba de infraestrutura
Principais recursos
Conectores para fontes de dados reais
O LlamaHub reúne centenas de carregadores e pacotes para pastas de rede, Notion, Slack, Google Drive, bancos SQL e rastreamento de sites. Todos devolvem o mesmo objeto Document com metadados anexados, então filtrar por data ou autor funciona igual, venha o texto de onde vier. Essa padronização poupa você de escrever um adaptador para cada origem.
Vários tipos de índice e busca híbrida
Você não fica preso a um formato de recuperação. O índice vetorial cuida das correspondências semânticas, o índice de palavras-chave pega nomes e códigos exatos, e os índices de resumo respondem perguntas que pedem um documento inteiro e não um parágrafo. Combine com um roteador ou com um recuperador que junta os dois resultados e acrescente um reranker por cima. Quase todo time chega à busca híbrida depois da primeira leva de respostas ruins.
Workflows com agentes
Os Workflows substituíram as cadeias rígidas de antes. Cada etapa assina eventos, repassa resultados tipados e pode repetir, ramificar ou aguardar a aprovação de uma pessoa. Como é Python assíncrono comum, você envia a saída parcial ao usuário e deixa o resto rodando. Quando o fluxo sai do notebook, vira um microserviço.
Processamento de documentos com o LlamaParse
O LlamaParse foi feito para os arquivos que quebram os carregadores normais: páginas escaneadas, tabelas densas, gráficos e escrita à mão. Ele devolve Markdown, texto puro, JSON por página ou XLSX, e declara suporte a mais de 130 tipos de arquivo e 80 idiomas. O modo de análise é escolhido por trabalho, então um PDF digital limpo vai pelo caminho barato e um escaneamento ruim pelo caminho agêntico, mais lento.
Plataforma LlamaCloud
O LlamaCloud coloca análise, extração, classificação, divisão e indexação atrás de uma conta e uma chave de API. No console web você testa um arquivo, salva uma configuração e depois chama essa mesma configuração pelo código. Os créditos cobrem cada ação e o reprocessamento em cache não gasta nada, o que ajuda na hora de ajustar um prompt ou um esquema.
Avaliação e rastreamento
A biblioteca traz módulos para pontuar fidelidade e relevância das respostas contra as suas próprias perguntas de teste, além de integração com ferramentas de rastreamento como Arize Phoenix e LangSmith. Assim você tem um número para defender quando alguém pergunta se a mudança de prompt melhorou o produto. Sem esse ciclo, ajustar a recuperação é chute.
Prós e contras
Prós
- A recuperação está no centro do projeto, então um pipeline RAG funcional exige bem menos código de cola do que um framework de agentes de uso geral.
- O núcleo tem licença MIT e não cobra por assento, e nada impede você de hospedar toda a pilha por conta própria.
- Provedores de modelo e de banco vetorial são trocáveis, o que evita ficar preso ao preço de um único fornecedor.
- O LlamaParse lê tabelas, gráficos e digitalizações que a extração simples de texto transforma em lixo.
- Os Workflows oferecem ramificações, novas tentativas e revisão humana sem sair da biblioteca.
Contras
- Tudo é código. Um time que esperava um construtor visual vai precisar de alguém que programe desde o primeiro dia.
- As versões saem rápido e as APIs mudam de nome, então tutoriais de um ano atrás costumam falhar na importação.
- O LlamaCloud é cobrado em créditos, e 1.000 créditos equivalem a US$ 1,25, o que torna o gasto mensal difícil de prever antes de testar arquivos reais.
- O melhor processamento de documentos é a parte paga e fechada, então uma instalação totalmente aberta lida pior com PDFs.
Perguntas frequentes
O framework é gratuito e tem licença MIT, incluindo os Workflows e as integrações do LlamaHub. Você continua pagando os tokens ao provedor do modelo, e o uso do LlamaCloud ou do LlamaParse é cobrado à parte.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a LlamaIndex.
Alternativas a LlamaIndex

Tractionwave
TractionWave · Imagem · MarketingO TractionWave cria mapas de calor de atenção com IA para anúncios estáticos. Você envia um PNG ou JPG e recebe a atenção prevista, pontos quentes ranqueados e ajustes antes de gastar verba.

OpenSEO - AI Visibility
EveryApp · Programação · Marketing · NegóciosOpenSEO é uma plataforma de SEO de código aberto para pesquisa de palavras-chave, backlinks, monitoramento de posições, auditoria do site e visibilidade em IA, com cobrança por uso e acesso MCP para agentes.

Plugins Radar
Plugins Radar · Marketing · NegóciosO Plugins Radar mostra em que posição seu plugin do ChatGPT aparece no diretório e no chat, quais rivais estão à frente e o que mudou, com checagem de hora em hora.