
MemoryCustodian
Zekun Wang (waittim) · Programação
MemoryCustodian é uma ferramenta gratuita e de código aberto que dá aos agentes de código uma memória de projeto duradoura. Ela guarda decisões, restrições e ideias descartadas como arquivos Markdown simples dentro do seu repositório e então envia ao agente apenas as partes relevantes para a tarefa por meio de um manifesto. O resultado: menos enchimento nos prompts e um trabalho mais consistente entre sessões, agentes e colegas de equipe. Foi feita para a gestão de contexto de agentes de código IA, não para registros de chat.
Sobre MemoryCustodian
O que é o MemoryCustodian
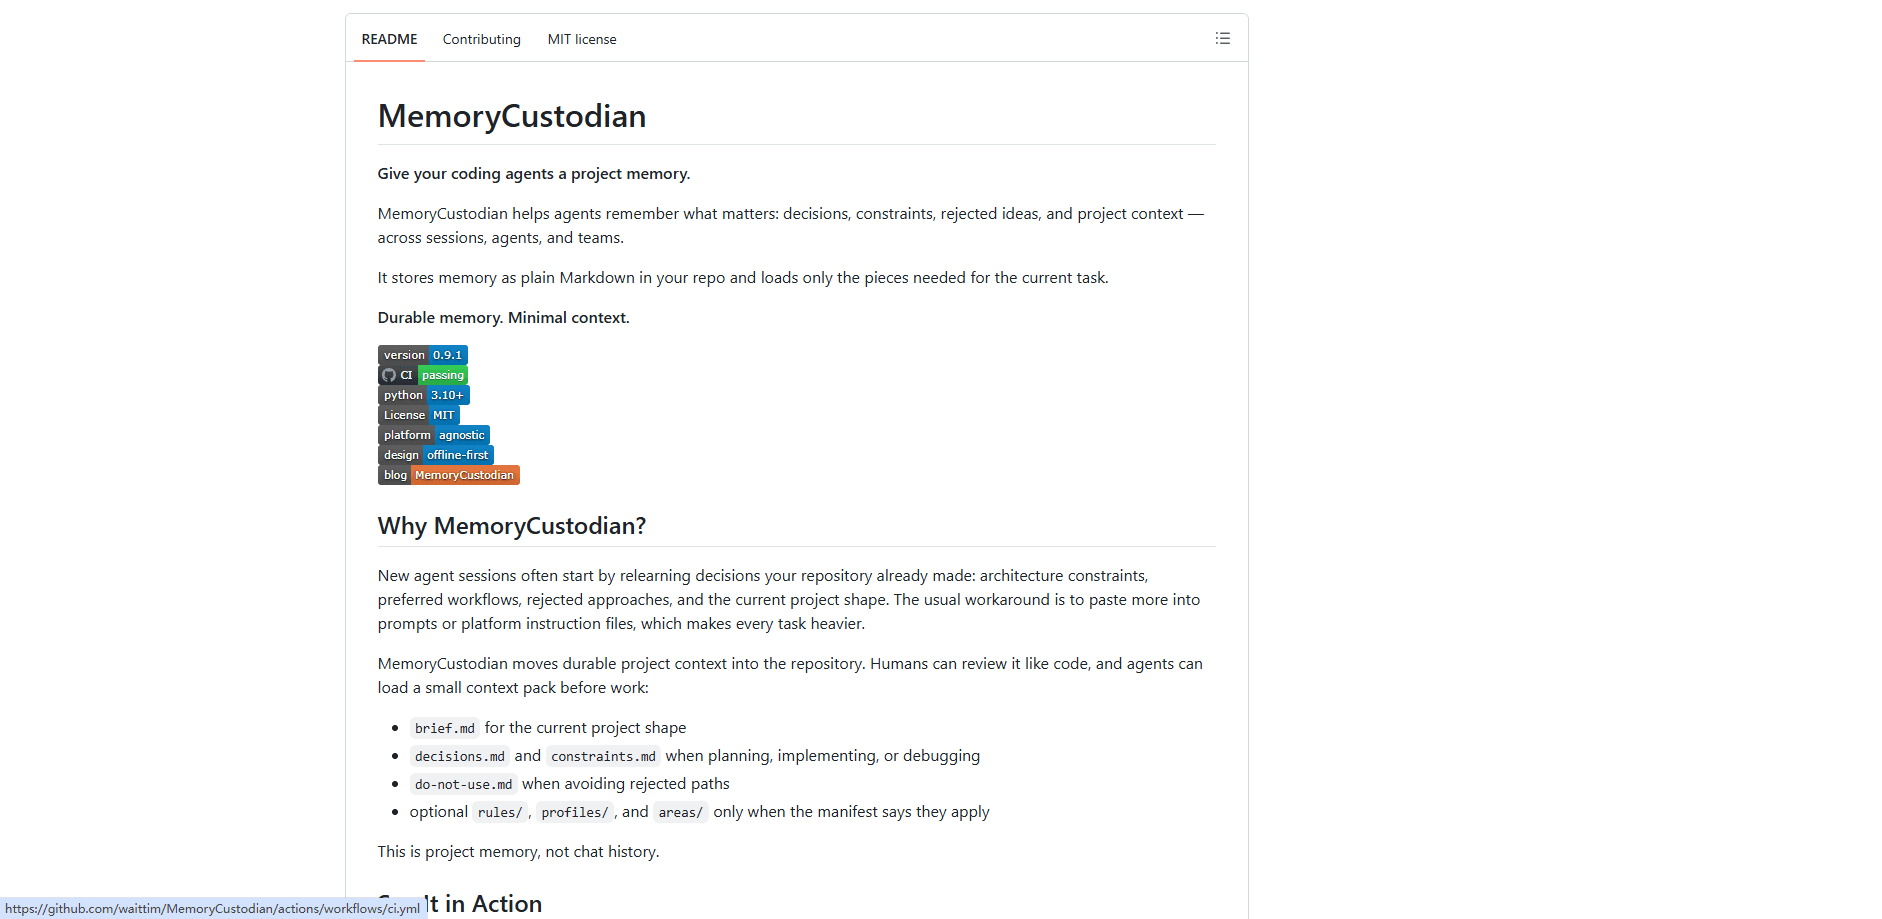
O MemoryCustodian é uma ferramenta de memória para agentes de código IA feita para quem trabalha com Codex, Claude Code, Gemini ou qualquer agente baseado em shell. Também serve a equipes que compartilham um mesmo repositório entre vários hosts de agentes e querem uma única fonte de verdade. O problema que ele ataca é específico: cada nova sessão de agente tende a reaprender decisões que seu repositório já tomou. Restrições de arquitetura, fluxos de trabalho preferidos, abordagens descartadas e o formato atual do projeto voltam a ser colados nos prompts, e isso faz cada tarefa pesar mais que a anterior. E por que isso acontece? Porque a memória vive no chat, e o chat é apagado.
A solução é mover o contexto de projeto duradouro para o próprio repositório. O MemoryCustodian mantém esse contexto em Markdown simples dentro de docs/memory/, então as pessoas podem revisá-lo e compará-lo como código. Antes de uma tarefa, o agente lê um pacote de contexto pequeno e limitado em vez de todo o histórico. Isso é o roteamento de contexto do agente na prática. Ele mantém o uso de tokens baixo e impede que o agente invente regras que você nunca acordou.
Não é histórico de chat. É memória de projeto. Essa distinção importa, porque significa que a memória sobrevive a uma conversa apagada, a uma troca de modelo ou à chegada de um novo colega ao repositório. O principal trade-off é que você precisa escrever os arquivos iniciais à mão. Um brief fraco é sinalizado pelos comandos integrados de status e verificação.
Como começar
- Peça ao seu agente de código para instalar a skill MemoryCustodian a partir do repositório dela no GitHub e depois inicializá-la.
- Ou rode a CLI direto:
memory-custodian init --project-root /path/to/project --agent all(troqueallporcodex,claudeougeminipara mirar um único host). - Revise os arquivos gerados em
docs/memory/, principalmente obrief.md, e preencha os TODOs a partir da documentação autorizada do seu projeto. - Registre memória duradoura enquanto trabalha com
memory-custodian add, marcando cada entrada com um assunto e uma evidência. - Rode
memory-custodian statusememory-custodian checkpara confirmar que o protocolo está saudável antes de depender dele.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de MemoryCustodian.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que usam agentes de código todo dia
- Equipes pequenas que compartilham um repositório
- Quem alterna entre Codex, Claude Code e Gemini
Tarefas
- Preservar decisões de arquitetura
- Acompanhar abordagens descartadas
- Integrar uma sessão de agente nova
Cenários
- Retomar um repositório depois de um longo intervalo
- Revisar um pull request
- Rodar agentes em CI
Principais recursos
Memória Markdown nativa do repositório
O MemoryCustodian guarda toda a memória do projeto como Markdown simples em docs/memory/. Isso quer dizer que ela é revisável, comparável, confirmável e reversível com segurança, igual ao seu código-fonte, que é exatamente o ponto quando a memória codifica decisões reais de engenharia. Nada fica preso em um banco de dados proprietário, e os colegas podem revisar as mudanças de memória nos mesmos pull requests que o código.
Roteamento de contexto baseado em manifesto
Em vez de enfiar todo o histórico em cada prompt, a ferramenta lê primeiro o manifest.md, depois o brief.md e, em seguida, só os arquivos que o manifesto indica para a sua tarefa. O roteamento usa entradas explícitas de tarefa e escopo, sem adivinhação semântica nem ranking por LLM. O roteamento de contexto do agente fica determinístico e previsível. Você recebe um pacote de contexto limitado que combina com o trabalho em questão.
Tipos de tarefa canônicos
A CLI traz um conjunto fixo de categorias de tarefa: general, planning, implementation, artifact, preferences, history e maintenance. Chamar read --task implementation puxa a memória relevante para escrever código, enquanto outras tarefas carregam uma fatia diferente conforme o escopo que você passa. Uma flag --strict-routing falha fechado diante de um escopo incompleto ou ambíguo, em vez de adivinhar.
Escritas de memória conservadoras
A memória ativa é respaldada por evidência. As entradas recebem IDs estáveis como MC-DEC-... e MC-SUBJ-..., e cada escrita precisa de confirmação do usuário ou de uma fonte do projeto para valer como real. As observações não confirmadas do agente ficam como candidatas no inbox.md até que uma pessoa as avalize, o que mantém as regras fantasmas fora da sua memória de trabalho e longe do seu código.
Esquecimento, verificações e manutenção
O esquecimento é com prévia primeiro e com escopo: o memory-custodian forget imprime um Plan ID que você precisa confirmar antes de qualquer coisa ser apagada. Esse passo de prévia importa porque os arquivos de memória são compartilhados, então uma exclusão ruim pode afetar o agente de todos de uma vez. Comandos de manutenção como o compact mantêm os arquivos dentro do orçamento e arquivam as entradas mais antigas quando você pede. Há verificações separadas de roteamento, atualidade, privacidade, segurança e conflitos, incluindo a revisão ciente de merges do Git contra uma branch base.
CLI em Python sem dependências
A ferramenta inteira roda na biblioteca padrão do Python. Nenhuma dependência de terceiros em tempo de execução. Funciona offline e não precisa de pipeline RAG nem banco de dados vetorial, o que evita a latência dos embeddings e as recuperações alucinadas. A instalação é um único pip install editável ou um script wrapper incluído.
Prós e contras
Prós
- Grátis e de código aberto sob a licença MIT, sem nível pago nem limites de uso.
- Funciona offline, com zero dependências de terceiros em tempo de execução e sem banco de dados vetorial.
- A memória vive no seu repositório como Markdown comparável, então é revisável e reversível com segurança.
- Um único conjunto de memória serve a Codex, Claude Code, Gemini e agentes genéricos de shell.
- As escritas com evidência e os IDs estáveis reduzem regras fantasmas e sobrescritas acidentais.
- Leve em recursos: sem servidor, sem banco de dados, só arquivos Markdown no seu repositório.
Contras
- É uma ferramenta de desenvolvedor voltada a agentes de código, então usuários não técnicos vão achar a CLI e os conceitos do protocolo pesados.
- Obter valor depende de curar o `brief.md` inicial; uma configuração sem curadoria é sinalizada e a qualidade do roteamento piora.
- A recordação da memória é determinística e baseada em regras, então ela não vai resumir por você conversas bagunçadas.
Perguntas frequentes
Ele dá aos agentes de código IA uma memória de projeto duradoura. Guarda decisões, restrições e abordagens descartadas no seu repositório e carrega só as partes relevantes para a tarefa. Assim os agentes param de reaprender o mesmo contexto a cada sessão.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a MemoryCustodian.
Alternativas a MemoryCustodian
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.