
Mercury
Inception Labs · Voz e linguagem · Programação
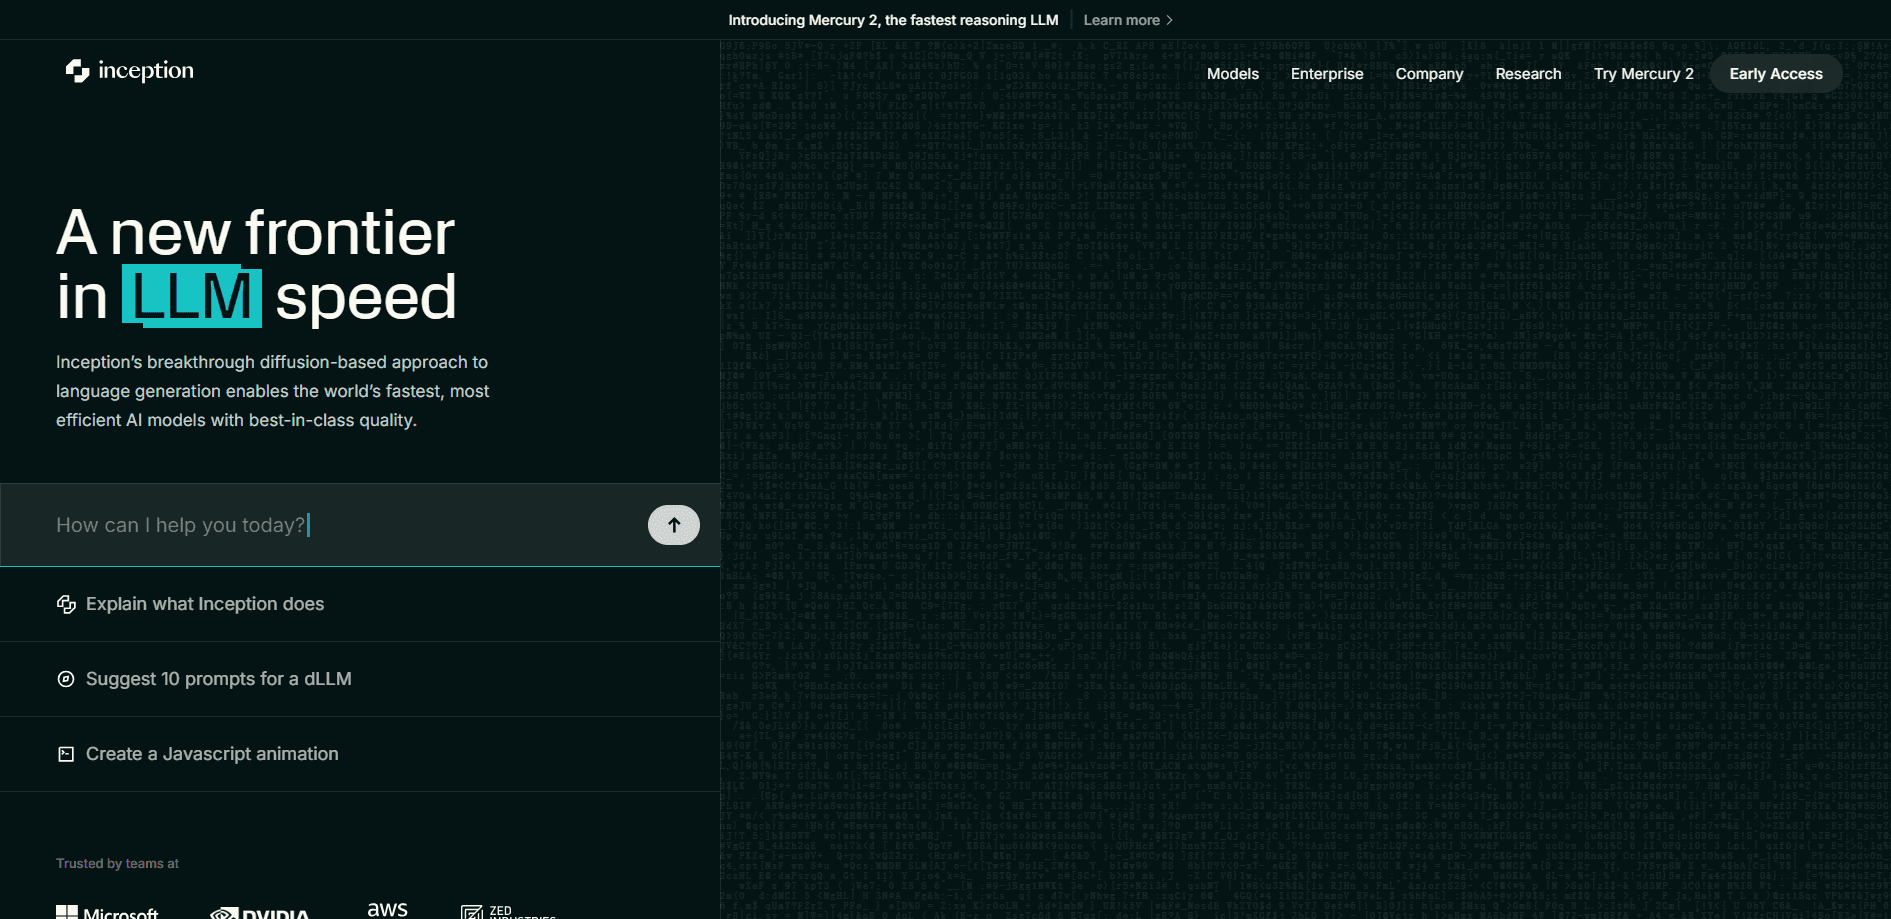
O Mercury é uma família de modelos de linguagem grandes de difusão da Inception Labs que gera texto em paralelo em vez de palavra por palavra. A versão atual, Mercury 2.5, roda a 1.107 tokens por segundo com uma janela de contexto de 260K. O preço fica em US$ 0,20 por milhão de tokens de entrada e US$ 0,75 por milhão de tokens de saída. Como modelo de geração de texto, ele mira desenvolvedores que precisam de resultados rápidos e baratos para busca, voz e programação. Esse modelo de IA de baixa latência é alugado por meio de uma API em vez de rodar na sua própria máquina, então o preço dos modelos de IA é pago conforme o uso.
Sobre Mercury
O que é o Mercury
O Mercury é a linha de modelos carro-chefe da Inception Labs, uma empresa fundada por pesquisadores de Stanford, UCLA, Cornell, Google DeepMind, Meta AI, Microsoft AI e OpenAI. Seu traço definidor está na arquitetura por baixo. Quase todo LLM comercial gera um token por vez, da esquerda para a direita. O Mercury usa difusão, a mesma ideia ampla por trás dos geradores de imagem, para produzir muitos tokens de uma vez e depois refiná-los. É daí que vem a velocidade. A empresa afirma que essa abordagem entrega uma taxa de processamento de 5 a 7 vezes maior e até 70% menos custo que modelos padrão de qualidade semelhante.
O trade-off que vale entender desde o início: o Mercury é um modelo de texto e raciocínio servido por uma API, não um aplicativo que você instala. Você não conversa com ele em um site como faria com o ChatGPT. Você o chama do seu próprio software, pagando por token. A Inception o direciona a equipes que já têm um produto e precisam que a camada do modelo pareça instantânea.
A velocidade é a manchete, mas o controle é o argumento de venda mais discreto. Como a difusão deixa o modelo ajustar os tokens como um grupo, a Inception diz que ele consegue seguir esquemas JSON estritos e regras semânticas de forma mais confiável que modelos autorregressivos, e oferece raciocínio ajustável e chamadas de ferramentas em paralelo. Se o seu pipeline encadeia dezenas de chamadas ao modelo por solicitação de usuário, essa combinação importa mais do que as pontuações brutas de benchmark. Pense nisso. Um agente de busca pode planejar, reescrever, reordenar e resumir antes mesmo de responder.
Como começar
- Crie uma conta na plataforma da Inception Labs e obtenha uma chave de API no console.
- Escolha um modelo Mercury no painel e confira as tarifas atuais por token antes de construir.
- Envie uma primeira solicitação com o endpoint de chat completions, usando o nome de modelo que aparece na sua conta.
- Teste o modo JSON alinhado a esquemas se o seu app precisa de saída estruturada, e ative o raciocínio ajustável só onde ele ajuda.
- Conecte a chave no seu ambiente de produção e monitore a latência e o gasto conforme o tráfego cresce.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Mercury.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de backend e de ML
- Equipes de startups com orçamento apertado
- Criadores de voz e suporte
Tarefas
- Pipelines de busca e RAG
- Autocompletar e refatorar código
- Extração de dados estruturados
Cenários
- Adicionar um assistente ágil a um app existente sem reconstruir sua infraestrutura em torno da latência.
- Prototipar um recurso de IA com pouco orçamento e depois escalá-lo conforme o uso cresce.
- Rodar trabalhos em lote de alto volume onde o custo por tarefa pesa mais do que extrair o último ponto de qualidade.
Principais recursos
Geração de tokens em paralelo
O Mercury escreve tokens em paralelo em vez de um por um, o motivo central de ser várias vezes mais rápido que modelos convencionais. A Inception relata um tempo até o primeiro token abaixo de 300 ms e 1.107 tokens por segundo em GPUs NVIDIA amplamente disponíveis. Essa diferença soa técnica até você usar. Para um usuário, é a distância entre um assistente que parece instantâneo e outro que o faz esperar enquanto um indicador gira, justamente o tipo de pequena demora que afasta as pessoas de um produto sem que se perceba.
Janela de contexto longa de 260K
O modelo Mercury 2.5 aceita até 260.000 tokens de contexto em uma única solicitação. Isso basta para conter documentos longos, arquivos de código grandes ou um histórico de conversa extenso sem picá-lo em pedaços. Contexto longo mais alta velocidade são uma dupla incomum, já que a maioria dos modelos rápidos mantém janelas modestas, e equipes que trabalham com bases de código grandes ou relatórios longos costumam sentir essa falta na hora. Vantagem enorme para arquivos grandes.
Raciocínio ajustável
Você pode regular quanto raciocínio interno o modelo faz por solicitação. Aumente para problemas difíceis que precisam de pensamento passo a passo; reduza para consultas simples onde o raciocínio extra só adiciona latência e custo. Esse controle é raro em modelos hospedados, onde o raciocínio costuma estar ligado ou desligado. Ótimo.
Saída JSON alinhada a esquemas
O Mercury pode limitar sua saída para corresponder a um esquema JSON que você definir. A difusão o deixa corrigir tokens como um grupo, o que segundo a Inception torna a saída estruturada mais confiável. Menos respostas quebradas. Os desenvolvedores têm menos saída malformada para limpar quando alimentam os resultados no próximo passo de um pipeline, o tipo de corte pequeno que se acumula rápido quando um fluxo de trabalho roda milhares de vezes por dia em produção.
Chamadas de ferramentas em paralelo
O modelo pode disparar várias chamadas de ferramenta ou função ao mesmo tempo em vez de esperar cada uma terminar. Em um agente que consulta um calendário, interroga um banco de dados e busca na web, esse paralelismo corta segundos reais da resposta. Combina com os fluxos de várias etapas para os quais o Mercury é vendido, e quem já viu um agente penar por cinco chamadas sequenciais sabe o quanto essa espera soma em uma única conversa. Grande trunfo para agentes.
Arquitetura de difusão
O Mercury é um LLM de difusão, ou dLLM. A Inception o descreve como um dos maiores modelos de linguagem de difusão treinados até hoje. A arquitetura também abre caminho para misturar texto com áudio, imagens e vídeo em uma só estrutura. O produto enviado hoje é primeiro texto.
Prós e contras
Prós
- Taxa de processamento de 1.107 tokens por segundo e latência até o primeiro token abaixo de 300 ms, rápida até para os padrões dos modelos de fronteira.
- Preço de US$ 0,20 por milhão de tokens de entrada e US$ 0,75 por milhão de saída, bem abaixo da maioria dos modelos comparáveis.
- Janela de contexto de 260K que dá conta de documentos longos e bases de código sem dividi-los.
- JSON alinhado a esquemas e raciocínio ajustável que dão aos desenvolvedores controle mais fino sobre a saída.
Contras
- Só API: não há app de desktop nem app móvel, então usuários casuais não podem simplesmente abrir o Mercury e conversar.
- A qualidade é apresentada como comparável a modelos de fronteira otimizados em custo, não ao nível mais alto absoluto, então as tarefas de raciocínio mais difíceis ainda podem favorecer modelos maiores.
- A adoção ainda é recente, o que significa menos exemplos da comunidade e integrações de terceiros do que nos ecossistemas de LLM dominantes.
- As tarifas e os nomes dos modelos mudam rápido, então vale conferir o preço atual antes de se comprometer.
Perguntas frequentes
Há um nível gratuito para testá-lo pela plataforma da Inception Labs, mas o modelo em si é cobrado por token em produção. No lançamento, o Mercury 2.5 foi oferecido com 80% de desconto, o que dava US$ 0,04 por milhão de tokens de entrada e US$ 0,15 por milhão de saída.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Mercury.
Alternativas a Mercury
Prosp
Prosp · Escrita · Voz e linguagem · MarketingO Prosp é uma ferramenta de abordagem no LinkedIn com IA, feita para agências e equipes de vendas, e escreve a mensagem e a nota de voz com a sua própria voz para cada prospect, para que eles realmente respondam. Você conecta suas contas, encontra leads e deixa a IA redigir e enviar mensagens personalizadas em escala, tudo em uma única caixa de entrada. É feita para quem faz abordagem em volume. Essa é toda a proposta. Cada toque ainda precisa parecer humano.

Wordly AI Translation
Wordly · Voz e linguagem · ProdutividadeO Wordly AI Translation é uma plataforma de tradução e legendagem com IA em tempo real feita para reuniões, conferências e eventos. Ele entrega tradução ao vivo, legendas, transcrições e resumos em mais de 60 idiomas, e os participantes entram escaneando um QR code ou abrindo um link em vez de usar fones dedicados. A plataforma funciona com Zoom, Microsoft Teams, Google Meet e Webex, e foi pensada para organizações que querem acesso multilíngue sem contratar intérpretes humanos para cada sessão. Simples assim.
Musicful
Musicful AI · Voz e linguagem · VídeoO Musicful é um gerador de música com IA e um criador de videoclipes com IA que transforma texto em música em minutos. Você entrega um texto, um conjunto de letras ou uma melodia cantarolada e ele devolve uma faixa pronta com vocais e instrumentos. Também funciona como gerador de músicas com IA, produz videoclipes a partir das músicas que você cria e oferece uma ferramenta de cover com IA mais uma API para desenvolvedores. A plataforma roda no navegador e em um app para Android, então você pode começar uma música no computador e continuar no celular.