
Middleware Observability Platform
Middleware · Programação
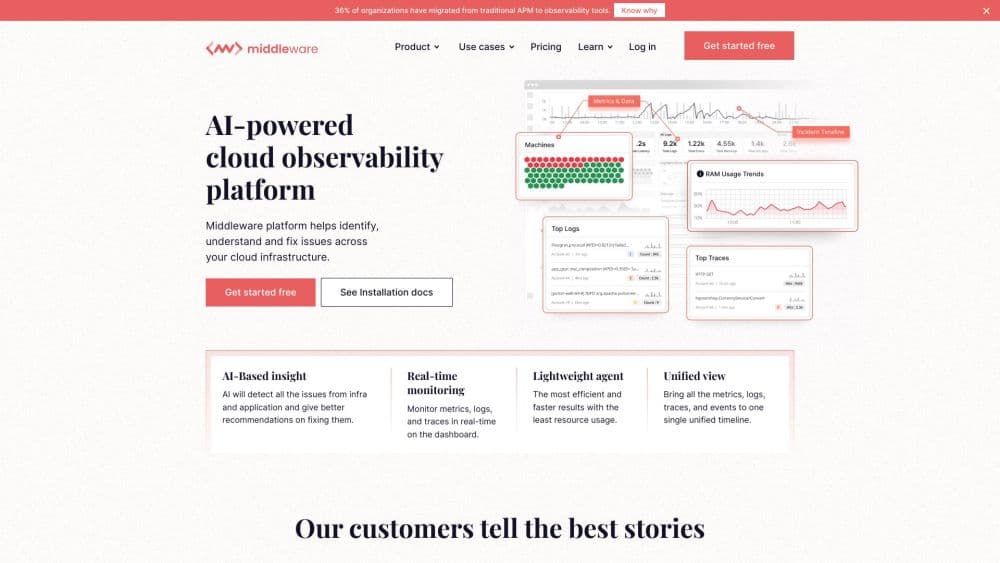
Middleware é uma plataforma de observabilidade em nuvem que junta logs, métricas, traces e sessões de usuários reais numa só linha do tempo e usa um agente de IA para achar a causa de um incidente e sugerir a correção.
Sobre Middleware Observability Platform
About
O que é o Middleware
Middleware Observability Platform é um serviço de monitoramento feito para times que rodam aplicações em Kubernetes, máquinas virtuais e bancos gerenciados. Em vez de comprar uma ferramenta de métricas, outra de logs e outra de monitoramento de aplicações, você instala um agente e vê tudo na mesma tela. Essa linha do tempo única pesa na hora do aperto: uma chamada lenta de API, um log de erro e a reprodução de uma sessão aparecem lado a lado, ligados pelo mesmo contexto de requisição.
A empresa por trás é a Middleware, fundada em 2022 por engenheiros que passaram por Netflix, DigitalOcean, Google e Cisco. A coleta sai de agentes instalados nos servidores, SDKs por linguagem e integrações com terceiros, e a plataforma fala OpenTelemetry, então coletores e agentes que você já tem podem alimentá-la sem migração. A cobrança é por consumo, e o argumento de venda é o custo total, não um catálogo gigante para departamento de compras.
Vale conhecer os limites logo de cara. É um serviço hospedado, ou seja, os dados saem da sua rede a menos que você pague a opção de trazer a própria nuvem. Processos de compliance mais profundos e retenções longas ficam no contrato personalizado. O agente de IA chegou depois do monitoramento básico, e um time com controle de mudanças rígido vai querer revisar o recurso de pull request automático antes de ligar.
Primeiros passos
- Crie a conta em app.middleware.io e entre com Google, GitHub, e-mail, Okta SSO ou Microsoft Entra ID.
- Abra a página de instalação e copie os valores MW_API_KEY e MW_TARGET do seu projeto.
- Escolha seu ambiente: um DaemonSet do Kubernetes, um agente para Linux, um SDK de Java, Python, Node.js ou outra linguagem, ou uma integração com AWS, Azure, Prometheus ou Datadog.
- Faça o deploy do agente e confirme que os dados chegam ao painel em poucos minutos.
- Monte visões e alertas em cima dos sinais que importam pro seu time e ligue a detecção do OpsAI para pegar anomalias que ficaram fora das regras.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Middleware Observability Platform.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Times de DevOps e SRE
- Startups com orçamento apertado
- Desenvolvedores que mexem com recursos de LLM
Tarefas
- Descobrir a causa de um endpoint lento
- Manter um cluster de Kubernetes saudável
- Acompanhar consultas no banco
- Checar se uma API responde de fora
Cenários
- Um incidente em produção às duas da manhã
- Pico de tráfego na semana de lançamento
- Revisão mensal de custos
Principais recursos
Agente OpsAI de detecção e correção
O OpsAI vigia ao mesmo tempo aplicações, infraestrutura, bancos, contêineres, logs e projetos de LLM e cruza o que encontra entre esses sinais. O valor vem depois do alerta: ele aponta uma causa provável e propõe uma correção, e ainda pode abrir um pull request com a mudança. A detecção de erros sai de graça e a análise de causa raiz é cobrada por token, então dá para manter os alertas ligados mesmo sem querer o passo de IA em todo incidente.
Monitoramento de performance de aplicações
O módulo de APM grava spans em tempo real e segue uma requisição do endpoint da API até os bancos que ela toca. A profilagem contínua mostra qual função queima CPU, o que responde a uma pergunta diferente da de um trace lento: o trace diz onde o tempo foi embora, o perfil diz qual código gastou esse tempo. Mapas de tráfego e visões de dependência ajudam quando você precisa explicar uma queda para quem não é da engenharia.
Monitoramento de logs com QueryGenie
Os logs entram de qualquer fonte JSON, então você não precisa reformatar a saída antes de enviar. Dá para buscar por atributo, com correspondência aproximada ou com expressão regular, e pausar a visão ao vivo durante um deploy. O QueryGenie transforma um pedido em linguagem natural em consulta, e isso ajuda quem não escreve consulta estruturada todo dia. Mascaramento de dados sensíveis e extração de atributos próprios acontecem antes de guardar, detalhe que importa quando os logs levam dados de cliente.
Monitoramento de infraestrutura e Kubernetes
A instrumentação automática cobre servidores, clusters de Kubernetes, nós Linux e serviços de nuvem sem um script por máquina. Você vê a saúde do cluster, CRDs e políticas de rede numa única visão, com detalhe no nível do ECS para cargas em contêiner. Relacionar um pico de CPU com a latência que ele causou é o fluxo para o qual o produto nasceu, e é a parte que os times notam primeiro.
Monitoramento de usuários reais e replay de sessões
O monitoramento de usuários reais captura o que quem visita seu site ou app móvel vive e liga um carregamento lento do front ao trace do backend que o causou. O replay de sessões deixa você assistir à sessão ao lado dos dados de rede, sem pedir que alguém descreva o que viu. Os controles de privacidade anonimizam campos e limitam o que é capturado, e isso deixa o recurso utilizável em produtos que guardam dados pessoais.
Testes sintéticos e de navegador
Os testes sintéticos disparam requisições HTTP, UDP, DNS e WebSocket de várias localidades em agenda fixa, com detalhe completo de requisição e resposta. Os testes de navegador gravam um percurso de usuário, como entrar e pagar, e rodam em vários navegadores e perfis de aparelho. Juntos, cobrem o buraco que o monitoramento no servidor não enxerga: se o serviço é alcançável e utilizável de fora.
Observabilidade de bancos de dados e de LLM
O monitoramento de bancos desce ao detalhe de cada consulta em MySQL, PostgreSQL, MongoDB, Cassandra e Aurora, e acompanha CPU, memória, disco e vazão junto das consultas. O módulo de LLM mede latência, consumo de tokens, custo, qualidade da resposta e erros em prompts, agentes e fluxos de várias etapas, e liga uma chamada de IA cara ou falha ao trace e à sessão que a originaram.
Prós e contras
Prós
- Um agente e uma tela para logs, métricas, traces, infraestrutura, monitoramento de usuários reais, testes sintéticos e dados de LLM, o que evita trocar de ferramenta no meio de um incidente.
- A coleta baseada em OpenTelemetry permite que os seus coletores, agentes do Datadog e configurações do Prometheus alimentem a plataforma sem desmontar o que já funciona.
- O preço por consumo começa numa camada gratuita com 100 GB de dados e usuários ilimitados, então a fatura cresce com a telemetria e não com o quadro de gente.
- O pipeline de dados deixa descartar fontes de log barulhentas antes de armazenar, o que segura ao mesmo tempo o gasto e os resultados de busca.
- A detecção de erros do OpsAI é gratuita e as mudanças de código sugeridas passam por um pull request, então o revisor continua no comando.
Contras
- É uma plataforma hospedada, então os dados saem da sua rede a menos que você pague a opção de trazer a própria nuvem em um contrato personalizado.
- A camada gratuita guarda 14 dias e o plano por consumo vem com 30 dias por padrão, janela curta para quem precisa olhar um ano para trás depois de uma auditoria.
- Correção automática e sugestões de código trazem risco real em ambientes regulados, e muita gente vai deixá-las desligadas no começo.
- A observabilidade de LLM é mais nova que o APM e os logs, então espere menos integrações profundas do que as dos concorrentes mais antigos.
Perguntas frequentes
O Middleware monitora infraestrutura, contêineres, Kubernetes, traces de aplicação, logs, bancos de dados, sessões de usuários reais, testes sintéticos e aplicações de LLM. Tudo cai numa só linha do tempo amarrada pelo contexto da requisição, e assim você sai da reclamação de um usuário até a consulta exata que causou o problema.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Middleware Observability Platform.
Alternativas a Middleware Observability Platform
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.