
AI Secured
Mindgard Ltd · Detecção de IA
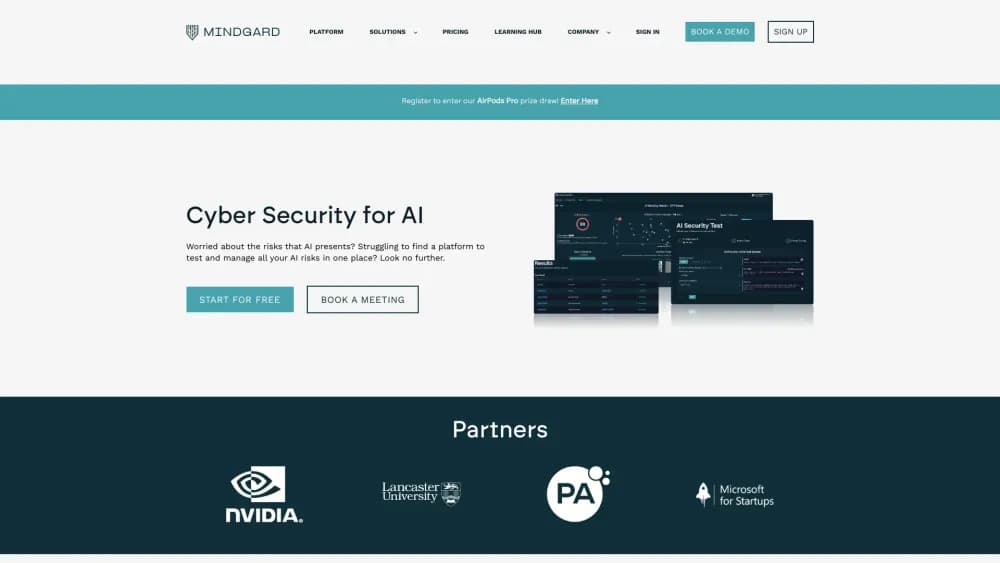
O Mindgard é uma plataforma de segurança para IA que faz red teaming automatizado. Testa LLMs, agentes e modelos multimodais, prova quais falhas são exploráveis e mapeia os achados para OWASP e MITRE ATLAS.
Sobre AI Secured
What Is Mindgard
O Mindgard é uma plataforma de testes de segurança para sistemas de IA. A equipe saiu da Universidade de Lancaster em 2022 e hoje trabalha de Londres e Boston. Você aponta a plataforma para um modelo, um aplicativo ou um agente, e ela ataca esse sistema como faria um atacante decidido. Primeiro mapeia o que o sistema alcança, depois procura controles frouxos e encadeia prompts e chamadas de ferramentas até algo ceder.
O produto fica na camada de teste, não na de filtragem. Guardrails e firewalls bloqueiam tráfego em tempo de execução. O Mindgard caça justamente o tráfego que escapa desses controles e entrega ao time um caminho de reprodução, uma nota de impacto e uma correção sugerida. A ordem importa. Muitos times já têm um scanner que devolve uma parede de avisos. O que falta é a prova de que um aviso específico leva a algo que vale corrigir antes do lançamento.
Dois limites moldam a experiência. O preço é por orçamento, sem cadastro autoatendido nem plano gratuito, então o primeiro contato passa por uma conversa com vendas. A plataforma também exige um endpoint acessível que fale JSON sobre HTTP. É o normal em ferramentas DAST para IA, que julgam comportamento enviando requisições reais em vez de ler código. Se o seu modelo só roda dentro de um app de desktop ou de um notebook privado, conte com mais trabalho de montagem pelo SDK de Python.
Getting Started
- Peça uma demo ou um teste em mindgard.ai e combine o escopo: quais sistemas entram, em quais ambientes e com que frequência os testes rodam.
- Conecte o alvo. Um endpoint de inferência ou a API de um aplicativo basta. O console web, a CLI, o SDK de Python e a extensão do Burp Suite chegam ao mesmo projeto.
- Rode um teste de linha de base e leia os resultados por caminho de ataque, não por contagem bruta de achados. Cada entrada lista os passos dados, a evidência de resposta e o item de framework correspondente.
- Corrija o que é explorável, reteste para confirmar que o ajuste segura e ligue esse mesmo teste ao CI/CD para que a próxima atualização do modelo seja verificada sem reunião.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de AI Secured.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Times de AppSec com recursos de LLM em produção
- Engenheiros de ML que colocam no ar agentes que chamam ferramentas
- Responsáveis por conformidade e risco diante do EU AI Act ou de uma revisão do NIST AI RMF
- Pentesters e consultorias
Tarefas
- Fazer red teaming de um chatbot ou copiloto antes do lançamento
- Testar regressões depois de trocar de modelo
- Investigar uma falha suspeita
- Montar evidência para auditoria
Cenários
- Um agente de suporte que pode emitir reembolsos
- Um assistente de recuperação sobre documentos internos
- Um lançamento regulado em que a papelada chega antes do recurso
Principais recursos
Reconhecimento nativo para agentes
Antes de disparar um único payload, o Mindgard perfilha o sistema: qual modelo responde, a quais ferramentas e APIs o agente chega e como os guardrails reagem a uma entrada estranha. Esse perfil decide para onde vão os ataques. Fica mais perto de como uma pessoa delimita um alvo do que de como um scanner percorre uma lista, e costuma revelar caminhos de maior impacto com menos requisições.
Caminhos de ataque adaptativos
A biblioteca cobre jailbreaks, injeção de prompt, extração de dados e evasão de guardrails, mas a plataforma não para em prompts de um turno. Ela encadeia etapas e reage ao que o sistema devolve, que é como um atacante real sai de uma pergunta inofensiva para uma ação com consequências. Os ataques são mapeados para entradas do MITRE ATLAS enquanto rodam. A cobertura começa nos testes de segurança de LLM e se estende a modelos de visão, áudio e multimodal.
Evidência reproduzível
Cada achado inclui os prompts usados, as respostas recebidas e o caminho que ligou os dois. Um engenheiro consegue repetir a sequência, e um gestor consegue ler a nota de impacto sem decifrar um score de risco. É aqui que um relatório útil se separa de um monte de alertas.
Orientação de correção e retestes
Cada achado vem com controles sugeridos, do pré-processamento de entrada ao filtro de saída e a permissões de ferramenta mais apertadas. Você aplica a correção, repete o mesmo caminho de ataque e recebe um passe limpo ou uma variante nova que ainda passa. Esse ciclo é o ponto: a plataforma foi feita para testes repetidos, não para um relatório único.
CI/CD, CLI, SDK e Burp Suite
Uma GitHub Action baixa a CLI atual em cada execução do fluxo, então técnicas novas chegam sem ninguém editar um arquivo de configuração. O SDK de Python cobre modelos que não podem expor um endpoint de rede, e a extensão do Burp Suite coloca os testes de IA dentro de um fluxo que pentesters já usam. O acesso REST cobre pipelines próprios.
Mapeamento de frameworks e relatórios
Os resultados são mapeados para o OWASP Top 10 para LLMs, MITRE ATLAS, NIST AI RMF e obrigações do EU AI Act, e os relatórios podem ser enviados a um SIEM ou a um sistema de tickets. Para times que precisam mostrar a um regulador ou a um cliente o que foi testado, o mapeamento economiza uma etapa de tradução. Ele não decide se uma lacuna é material para o seu negócio.
Proteção em tempo de execução depois do teste
O teste encontra a lacuna; a proteção em tempo de execução vigia as tentativas de usá-la. O Mindgard oferece detecção e resposta para tráfego de IA em produção, então a mesma plataforma que provou a existência de uma falha pode sinalizar tentativas de exploração depois. Times que querem apenas testes antes do lançamento podem pular essa camada.
Prós e contras
Prós
- Os achados vêm com passos de reprodução e evidência de resposta, o que acelera a triagem e o aceite em comparação com discutir um score de severidade.
- O reconhecimento roda antes dos ataques, então os resultados refletem o sistema real, com ferramentas e guardrails, e não um endpoint de modelo isolado.
- A CLI, o SDK de Python, a GitHub Action e a extensão do Burp Suite encaixam nos fluxos de segurança e engenharia que já existem, em vez de exigir um novo.
- O mapeamento de frameworks cobre as quatro referências que auditores mais pedem: OWASP LLM Top 10, MITRE ATLAS, NIST AI RMF e EU AI Act.
- A credibilidade em pesquisa é real. A empresa divulgou mais de 150 vulnerabilidades de IA e mantém um time com doutores em segurança de IA, o que aparece no desenho dos ataques.
Contras
- Não há tabela de preços pública, plano gratuito nem cadastro autoatendido. Avaliar exige uma call de vendas, e orçar exige uma proposta com escopo definido.
- Um endpoint JSON acessível é requisito para o caminho mais simples. Modelos presos dentro de um app precisam de trabalho de SDK antes do teste começar.
- Números de cobertura, como milhares de cenários de ataque, são afirmações do fornecedor. Nenhum benchmark independente confirma isso, então trate os totais como marketing até a sua própria execução sustentar a promessa.
- Os resultados ainda pedem um revisor experiente. A plataforma prova a explorabilidade, mas julgar o impacto de negócio para os seus dados e usuários continua com o seu time.
Perguntas frequentes
O Mindgard testa sistemas de IA em busca de falhas de segurança. Mapeia um modelo ou agente, lança ataques contra ele, valida quais fraquezas são realmente exploráveis e entrega ao time a evidência e a orientação de correção. Times de segurança usam antes do lançamento e de novo depois de cada mudança de modelo ou de configuração.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a AI Secured.
Alternativas a AI Secured
Isgen AI
Isgen · Detecção de IAO Isgen AI é um detector de IA baseado na web que pontua um texto conforme a probabilidade de ele ter sido escrito por uma máquina e mostra quais orações e frases elevam essa pontuação. Foi feito para professores, editores, estudantes e redatores. A pergunta é simples: este rascunho saiu do ChatGPT, do GPT-5, do Claude, do Gemini, do DeepSeek ou de outro modelo? Você cola ou envia o conteúdo, roda uma análise e recebe uma divisão entre Humano, IA e Misto em segundos. Há ainda um editor que pontua o texto enquanto você escreve.
Humanizeai Tools
Humanizeai Tools · Escrita · Detecção de IAO Humanizeai Tools é um humanizador de IA baseado na web que reescreve textos gerados por máquina para que soem como escritos por uma pessoa, que é justamente o propósito da categoria à qual pertence. Você cola um rascunho do ChatGPT, do Claude ou do Gemini, passa pela ferramenta e ela troca as expressões e os padrões de frase que os detectores de IA marcam. Se a sua meta é fazer o texto de IA soar humano antes de publicar, essa é a categoria de ferramenta feita exatamente para isso. Serve a estudantes, blogueiros e profissionais de marketing que precisam de textos lidos com naturalidade e que passam por ferramentas como GPTZero, Copyleaks e Winston AI em uma única passada.

Hidemyai
Hidemyai · Escrita · Detecção de IAO Hidemyai é um humanizador de conteúdo com IA. Ele reescreve texto do ChatGPT, do Jasper e de ferramentas parecidas para que o resultado pareça escrito por uma pessoa. Você cola o rascunho, escolhe um tipo de documento e um tom, e o serviço devolve uma versão feita para driblar detectores como Originality.ai, Turnitin e ZeroGPT. Ele mira redatores, profissionais de marketing e estudantes que se apoiam em rascunhos de IA, mas não podem publicar um texto que soe robótico. A promessa é simples: tornar o conteúdo de IA indetectável.