
NativeMind
NativeMind · Outros
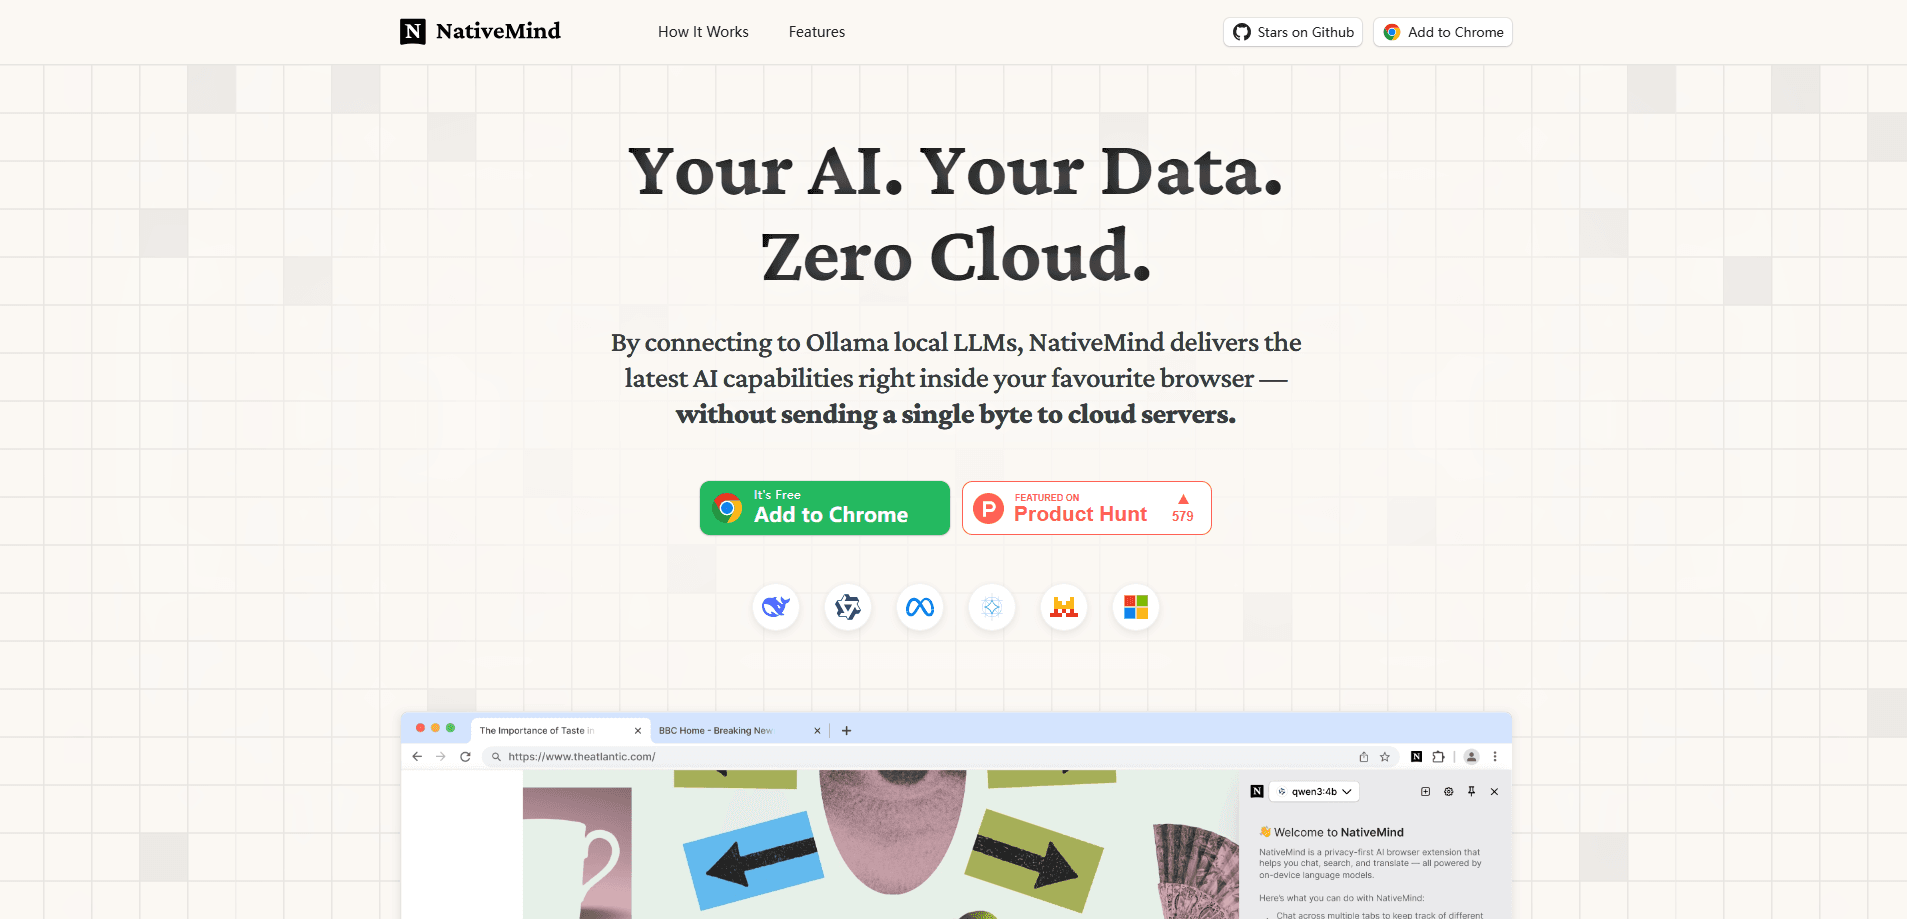
O NativeMind é uma extensão de navegador gratuita e de código aberto que roda modelos de IA no seu próprio computador com o Ollama, então seus chats, PDFs e páginas ficam privados e funcionam sem internet.
Sobre NativeMind
What Is NativeMind
O NativeMind é uma extensão que traz IA privada no navegador para o Chrome, Firefox, Brave ou Edge sem mandar seus dados para um servidor na nuvem. Ele se conecta ao Ollama, a ferramenta que muita gente já usa para rodar modelos abertos como Llama, Qwen, Gemma, Mistral e DeepSeek na própria máquina. Depois de configurar, você conversa com as páginas, resume artigos, traduz texto e trabalha com PDFs enquanto tudo fica no seu computador.
O problema que ele ataca é simples. Quase todo assistente de IA manda seus pedidos, documentos e contexto de navegação para servidores remotos, o que é chato quando você lida com contratos, laudos médicos ou código que não pode compartilhar. O NativeMind inverte isso: o modelo roda local, a extensão lê a página local e nada sai do seu dispositivo. Não tem conta, nem rastreamento, nem assinatura.
A limitação principal é que ele precisa de uma máquina com folga. Rodar modelos local consome RAM e CPU, então em notebooks antigos a coisa pode ficar lenta ou não aguentar modelos grandes. Você também precisa instalar e rodar o Ollama por conta própria para liberar toda a lista de modelos. Sem ele, a extensão ainda oferece um modelo pequeno dentro do navegador para um teste rápido, mas bem menos capaz.
Getting Started
- Instale a extensão NativeMind pela Chrome Web Store ou pela loja de extensões do Firefox, e fixe na barra de ferramentas.
- Configure o Ollama no mesmo computador e baixe pelo menos um modelo, como Llama 3 ou Qwen.
- Abra a barra lateral da extensão e escolha esse modelo na lista. O NativeMind detecta seu Ollama local sozinho.
- Comece a usar: faça uma pergunta, resuma a página atual, traduza um trecho ou envie um PDF para conversar com ele.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de NativeMind.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Profissionais atentos à privacidade
- Desenvolvedores e pesquisadores
- Leitores do dia a dia
Tarefas
- Resumir artigos e páginas longas
- Conversar com PDF sem conexão
- Traduzir páginas inteiras ou texto selecionado
- Escrever e reescrever texto
Cenários
- Trabalhar com material sensível num notebook que precisa ficar offline
- Pesquisa em várias etapas entre abas
- Usar IA dentro de um app web que você está criando
Principais recursos
Modelos no dispositivo com Ollama
O NativeMind se liga ao seu servidor Ollama local, então roda modelos abertos como Llama, Qwen, Gemma, Mistral, DeepSeek e gpt-oss direto no seu hardware. Você alterna entre eles na barra lateral conforme a velocidade ou a qualidade que precisa. Um modelo pequeno no navegador, movido a WebAssembly, dá um teste sem configuração antes de instalar o Ollama.
Conversa entre abas
Você pode adicionar abas abertas a uma conversa como contexto, então perguntas e resumos continuam entre sites em vez de começar do zero toda vez. Ajuda quando você compara fontes ou acompanha um tema ao longo de várias páginas.
Modo agente
O agente autônomo divide um pedido em etapas e usa ferramentas do dispositivo, como busca web local ou análise de arquivos, para resolver tarefas de vários passos. Tudo roda local, o que importa quando a tarefa mexe com dados privados.
Busca web local
O NativeMind procura e encontra respostas dentro do seu navegador sem chamar APIs de busca externas. Os resultados voltam pelo seu modelo local, então a consulta não passa por servidores de terceiros.
Ferramentas de escrita
Um assistente de escrita refina, reescreve, revisa e ajusta o tom onde você está digitando, e você pode fazer brainstorming sem colar seu rascunho em outro site. Ele fica integrado na página em que você está.
Ler e traduzir páginas
A extensão resume e interpreta as páginas que você lê e traduz uma página inteira ou um trecho para uma visão bilíngue lado a lado. O layout e a privacidade se mantêm intactos do começo ao fim.
API de LLM no navegador
Os desenvolvedores têm uma API leve para mandar pedidos ao modelo local a partir do próprio app web, sem SDK e sem servidor. A documentação no GitHub mostra como ligar isso.
Prós e contras
Prós
- Mantém chats, documentos e contexto de navegação no seu dispositivo, sem transmissão para a nuvem.
- É um assistente de IA de código aberto, então dá para auditar o código e não existe assinatura.
- Funciona sem internet depois de baixar um modelo, útil em aviões ou máquinas isoladas.
- Não pede conta nem cadastro para usar a extensão.
- Roda nos principais navegadores, incluindo Chrome, Firefox, Brave e Edge.
Contras
- Precisa de uma máquina com certa potência; modelos grandes ficam lentos ou comem muita memória em hardware antigo.
- A lista completa de modelos depende de você instalar e rodar o Ollama, algo que não é para usuários sem perfil técnico.
- O modelo integrado sem configuração é pequeno e limitado, então serve mais para testar.
Perguntas frequentes
É um assistente de IA privado que vive no seu navegador. Você usa para resumir páginas, conversar com PDFs e imagens, traduzir texto, reescrever o que escreve e disparar tarefas de agente em várias etapas, tudo com modelos que rodam no seu próprio dispositivo.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a NativeMind.
Alternativas a NativeMind

Odyssey 3
Odyssey · OutrosOdyssey-3 é o modelo de mundo fundacional da Odyssey. Simula física em tempo real, transforma um texto em ambiente interativo e se adapta a robôs, carros e jogos.

JarvisCore
Prescott Data · Programação · Produtividade · OutrosJarvisCore é um runtime de código aberto em Python em que agentes de IA atuam como pares numa malha, assumem tarefas de um registro compartilhado e chegam a serviços externos por um broker sem confiança.
Clef
Cloudflare · Negócios · OutrosClef é o modelo de decisão open source da Cloudflare para o Workers AI. Devolve probabilidades calibradas para perguntas tipadas em vez de texto, então o agente classifica, roteia e age rápido.