
OctoAI
OctoAI (formerly OctoML, now part of NVIDIA) · Programação
O OctoAI era uma API de inferência de IA na nuvem que servia modelos abertos como Llama, Mistral e Stable Diffusion por uma API compatível com a OpenAI. A NVIDIA comprou a empresa em 2024.
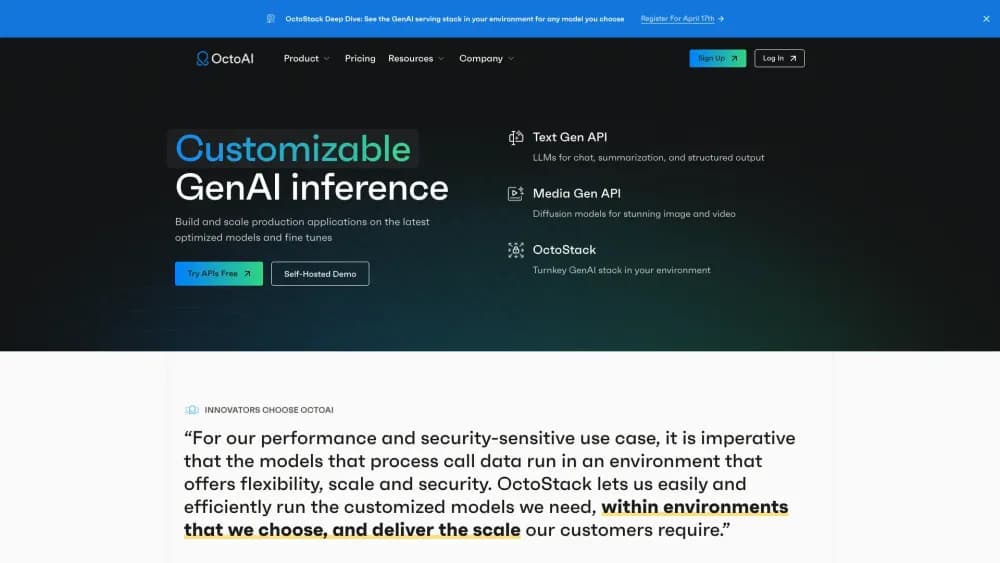
Sobre OctoAI
About
O que era o OctoAI
O OctoAI era uma empresa de Seattle que vendia acesso rápido e barato a modelos de inteligência artificial de código aberto. Bastava mandar uma requisição para a API, escolher um modelo do catálogo e receber texto ou uma imagem. O atrativo era a velocidade: a empresa ajustava cada modelo para render mais na mesma GPU, então as respostas chegavam antes e custavam menos do que num deploy comum na nuvem.
A equipe chegou lá pelo caminho dos compiladores, não dos chatbots. O OctoAI nasceu em 2019 como OctoML, uma spin-off da Universidade de Washington construída em torno do Apache TVM, um compilador aberto que reescreve um modelo para rodar bem no chip que você tiver. Esse trabalho virou depois uma hospedagem de modelos de código aberto voltada para quem desenvolve aplicativos e queria Llama ou Stable Diffusion dentro de um produto sem contratar um time de infraestrutura de aprendizado de máquina.
Esse serviço não existe mais. A NVIDIA comprou o OctoAI em setembro de 2024 e a empresa avisou os clientes de que o acesso a todos os serviços terminaria em 31 de outubro de 2024. As contas foram desativadas e a API saiu do ar. A equipe foi para o grupo de software da NVIDIA. Quem pesquisa OctoAI hoje encontra um capítulo encerrado, e a pergunta que importa é o que ocupou o lugar.
Como começar
Não há mais cadastro para fazer, porque a plataforma foi desativada. O que vem a seguir é como ela funcionava enquanto estava no ar, útil se você lê tutoriais antigos ou planeja uma migração.
- Crie uma conta na plataforma do OctoAI e gere um token de API no painel.
- Escolha um modelo do catálogo, como Llama, Mistral ou Stable Diffusion XL, ou suba um modelo que você já ajustou.
- Aponte seu código para o endpoint compatível com a OpenAI, que permitia reaproveitar quase qualquer biblioteca cliente trocando a URL base.
- Envie uma requisição e leia a resposta, seja texto gerado, uma imagem ou um JSON.
- Para um deploy privado, rode o OctoStack dentro da sua própria conta de nuvem ou nos seus servidores, e assim o tráfego não passa por infraestrutura compartilhada.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de OctoAI.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Quem desenvolve sobre modelos abertos
- Times que estão migrando do OctoAI
- Empresas de setores regulados
Tarefas
- Servir geração de texto em escala de produção
- Gerar imagens com o Stable Diffusion XL
- Hospedar um modelo ajustado
- Auditar uma dependência antiga
Cenários
- Um protótipo que dependia do OctoAI
- Uma revisão de fornecedores de inferência
- Ler um tutorial de 2024
Principais recursos
Geração de texto compatível com a OpenAI
O OctoAI servia o Llama 2 nos tamanhos 7B, 13B e 70B, além das variantes de chat, do Code Llama e do Mistral 7B. A API seguia o formato de requisição da OpenAI, então quem já usava esse padrão trocava de fornecedor mudando a URL base. Essa compatibilidade reduzia o teste de um novo provedor a algumas linhas de configuração.
API de imagens com Stable Diffusion XL
O lado de imagem rodava o Stable Diffusion XL e permitia anexar adaptadores LoRA próprios direto na chamada. Um estúdio de jogos ou um time de marketing gerava arte com o estilo da casa sem treinar um modelo base. As requisições devolviam a imagem pronta, não um número de fila para consultar depois.
Otimização independente de hardware
A vantagem da empresa vinha do Apache TVM, um compilador que converte um modelo em código ajustado para um chip específico. O OctoAI aplicava esse ajuste nos próprios servidores, então o ganho aparecia no tempo de resposta da API e não num pacote para instalar. O suporte cobria GPUs da NVIDIA, hardware da AMD, CPUs da Intel e chips Inferentia da AWS. Essa portabilidade perdeu valor quando o mercado se concentrou na NVIDIA.
OctoStack para deploy privado
O OctoStack, lançado em abril de 2024, deixava empresas rodarem a mesma pilha de inferência dentro do próprio ambiente, fosse na AWS, no Google Cloud, no Azure, na CoreWeave, na Lambda Labs ou num data center próprio. O argumento era privacidade e controle: times de saúde, finanças e governo usavam os modelos sem mandar dados para os servidores do OctoAI. A companhia afirmava utilização de GPU 4 vezes melhor e 50% menos custo operacional do que um arranjo feito à mão.
Traga seu próprio modelo
Além do catálogo, dava para hospedar uma variante ajustada do Llama 2 na plataforma e chamá-la como qualquer outro endpoint. Isso evitava construir uma camada de serving própria para um modelo personalizado, embora o ajuste ainda precisasse ser produzido e testado em outro lugar.
Preço por uso
O OctoAI cobrava por consumo, sem assinatura fixa, com nível de teste grátis, tarifa por token para texto, por imagem no SDXL e por hora de computação em endpoints personalizados. A economia maior vinha dos modelos ajustados, que segundo a empresa rodavam até 10 vezes mais rápido que um deploy sem tratamento.
Prós e contras
Prós
- A API falava o formato da OpenAI, então mover um aplicativo existente era trocar URL base e chave
- Modelos ajustados respondiam mais rápido e custavam menos por token do que um deploy bruto sobre GPU na nuvem
- Adaptadores LoRA próprios davam à geração de imagens um estilo de marca consistente sem treinar um modelo
- O OctoStack oferecia aos setores regulados uma forma de manter os dados dentro da própria conta de nuvem
- Um nível de teste grátis deixava medir latência e qualidade antes de reservar orçamento
Contras
- A plataforma inteira saiu do ar em 31 de outubro de 2024, cerca de cinco semanas depois do anúncio da compra pela NVIDIA
- Nenhum produto da NVIDIA assumiu a mesma carga de trabalho, então os clientes tiveram de refazer o aplicativo em um serviço de inferência rival
- A cobertura de modelos ficava atrás dos concorrentes mais rápidos, e lançamentos abertos novos levavam semanas ou meses para chegar
- O discurso de independência de hardware perdeu sentido conforme o mercado se concentrou em GPUs da NVIDIA, o que estreitou a razão para escolher o OctoAI
- O preço de endpoints personalizados era mais difícil de prever do que uma tarifa fixa por token, o que complicava o orçamento de times com tráfego irregular
Perguntas frequentes
A NVIDIA comprou o OctoAI em setembro de 2024 e a empresa encerrou todos os serviços comerciais em 31 de outubro de 2024. A equipe, liderada pelo CEO Luis Ceze, foi para a NVIDIA, e a API e a plataforma não recebem mais tráfego.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a OctoAI.
Alternativas a OctoAI
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.