
Ollama
Ollama · Imagem · Outros
O Ollama é um ambiente de IA local para rodar grandes modelos de linguagem na sua própria máquina. Baixa modelos abertos como Gemma 4, Qwen e gpt-oss, com opção na nuvem se o modelo não couber.
Sobre Ollama
What Is Ollama
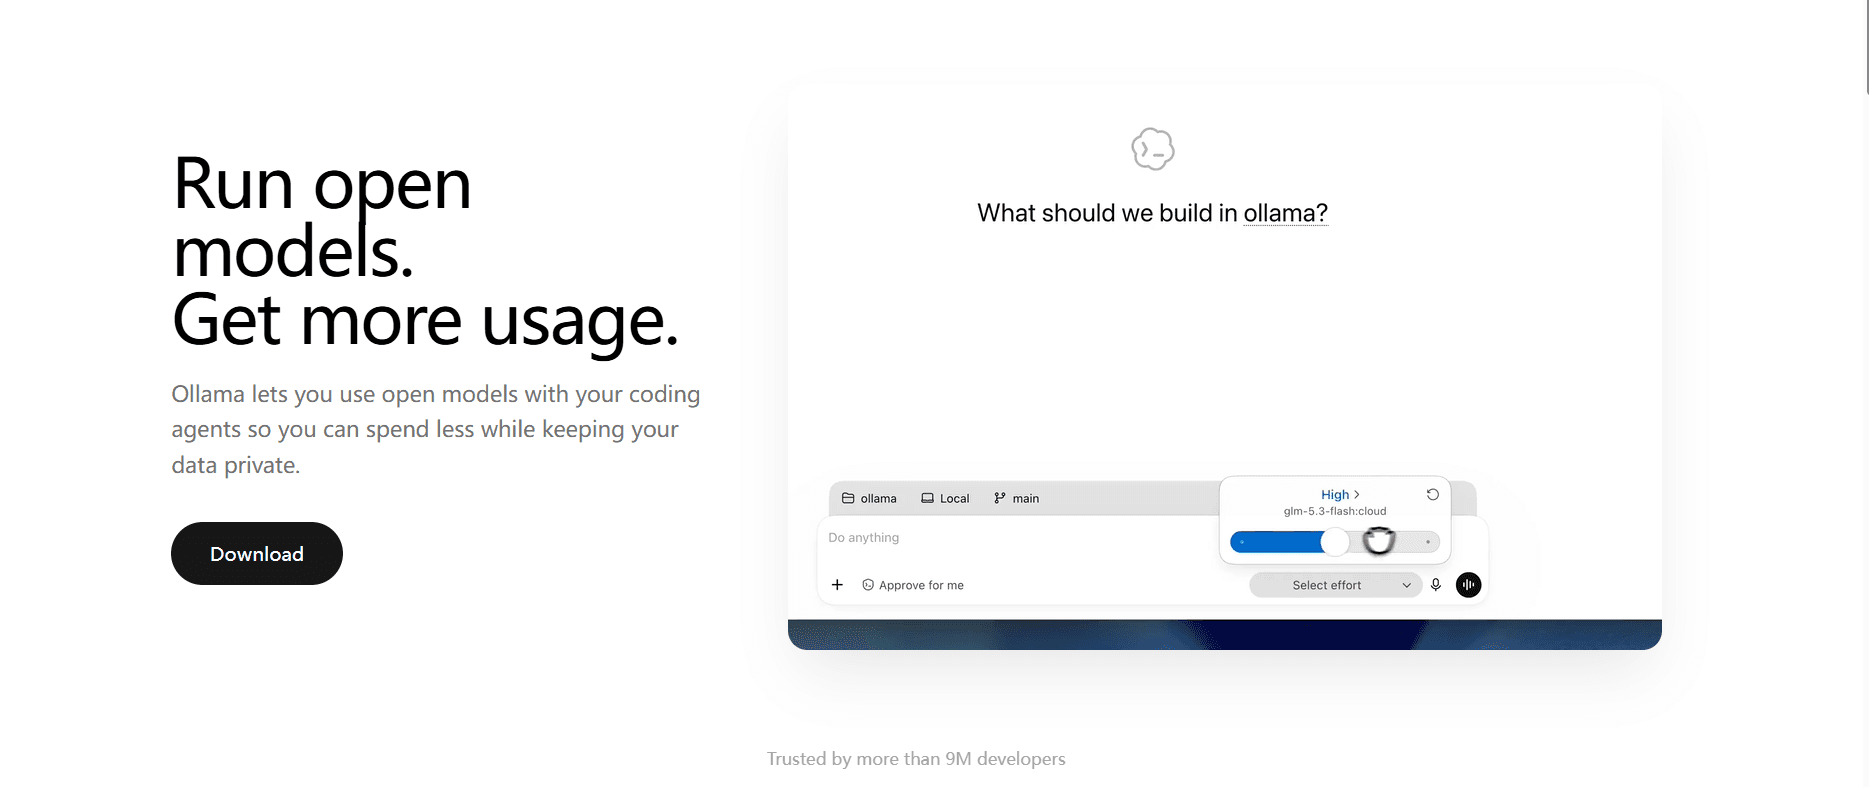
O Ollama é um ambiente de código aberto que roda grandes modelos de linguagem no seu próprio computador. Em vez de alugar um modelo por API, você baixa os pesos uma vez e conversa sem conexão. Um único comando baixa e inicia o modelo, e o aplicativo cuida da parte chata: formatos de quantização, uso de GPU ou dos chips Apple Silicon, limites de memória e o processo servidor que responde aos pedidos.
O projeto começou em julho de 2023 e cresceu rápido. Hoje passa de 9 milhões de instalações por mês e de 1 bilhão de downloads de modelos. Em 2026, a empresa levantou 88 milhões de dólares com a Benchmark, a Y Combinator e outros investidores, e adicionou uma camada na nuvem para modelos grandes demais para um notebook.
Essa camada é a principal escolha a entender. Rodar modelos localmente é sempre gratuito e ilimitado, mas o limite é o seu hardware: um modelo de 7B roda num notebook simples, enquanto um de 200B exige uma máquina com GPU de verdade. Os modelos na nuvem tiram esse teto e são cobrados por token, então o Ollama é ao mesmo tempo uma ferramenta local gratuita e um serviço pago conforme o uso, dependendo do modelo escolhido.
Getting Started
- Baixe o Ollama para macOS, Windows ou Linux, ou use a imagem oficial no Docker, e abra o aplicativo.
- Baixe um modelo com
ollama pull gemma4:e2b(o download fica em torno de 7,2 GB), ou escolha Local na configuração se não quiser criar conta. - Rode
ollama run gemma4:e2bpara conversar no terminal, ou inicie um agente de código comollama launch claude. - Para os seus aplicativos, envie pedidos à API REST local na porta 11434, ou aponte um cliente da OpenAI ou da Anthropic para os endpoints compatíveis do Ollama.
- Faça login e crie uma chave quando quiser modelos na nuvem, e deixe os pedidos pesados fora da sua máquina.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Ollama.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que testam modelos abertos sem conta na nuvem
- Usuários preocupados com privacidade
- Equipes que colocam agentes de código em produção
- Pesquisadores que comparam famílias de modelos
Tarefas
- Ter um modelo de conversa sem internet
- Levar IA para dentro de um aplicativo
- Ajustar o comportamento com um Modelfile
- Conectar agentes e editores
- Extrair dados estruturados de um modelo
Cenários
- Um notebook num avião
- Uma empresa com regras rígidas de dados
- Um protótipo rápido antes de assumir uma conta na nuvem
- Uma sessão de código com um agente local
Principais recursos
Modelos locais com um comando
A promessa central cabe numa linha: ollama pull traz os pesos e ollama run abre o chat. O Ollama cuida da quantização, do uso de memória e do servidor por trás, então você pula a dança de versões do CUDA e ambientes de Python. Os modelos vêm de uma biblioteca própria que cobre Gemma, Qwen, gpt-oss, DeepSeek, Kimi, MiniMax, GLM, Mistral e Nemotron.
Modelos na nuvem com preço por token
Nem todo modelo cabe num notebook, então o Ollama criou uma camada na nuvem que roda modelos abertos grandes no hardware dos provedores NVIDIA Cloud. Você paga por milhão de tokens, com tarifas fora de pico que cortam o preço quase pela metade fora do horário comercial dos dias úteis. Contas gratuitas recebem créditos iniciais e os planos pagos incluem uma cota mensal.
API REST e compatibilidade com a OpenAI
Cada modelo local sobe um servidor HTTP na porta 11434, então qualquer linguagem consegue conversar com ele. O Ollama também entende os formatos OpenAI Chat Completions e Responses e o formato Anthropic Messages, o que significa que ferramentas feitas para essas APIs funcionam trocando a URL base, quase sempre sem mexer no código.
Motor MLX no Apple Silicon
Nos Macs, o Ollama roda os modelos compatíveis pelo framework MLX da Apple em vez de um ambiente traduzido. A mudança trouxe grandes ganhos de velocidade em 2026, incluindo a predição de vários tokens que a empresa mediu como até 90% mais rápida em agentes de código. O uso de memória também caiu, o que importa em Macs com memória unificada, onde a RAM é o limite real.
Integrações com agentes e desktop
ollama launch claude, ollama launch codex e comandos parecidos conectam os agentes de código aos seus modelos. No desktop, o Claude e o ChatGPT (Desktop) podem ser apontados para o Ollama, o que abre modelos como Muse Glimmer e Nemotron dentro de ferramentas que você já usa.
Modelfiles e criação de modelos
Um Modelfile é uma receita curta que define um modelo próprio: pesos base, prompt de sistema, parâmetros e template. Você o monta com ollama create e a definição viaja junto com o modelo, então as instruções compartilhadas ficam iguais para toda a equipe em vez de viverem em anotações soltas.
Embeddings e saídas estruturadas
O Ollama roda modelos de embeddings como o EmbeddingGemma e devolve vetores para busca ou agrupamento. O parâmetro format aceita um esquema JSON para o modelo responder com um objeto tipado, o que transforma texto solto em dados que um programa lê sem adivinhar o formato.
Modelos de decisão
As versões mais recentes somam modelos de decisão que devolvem opções, pontuações e probabilidades em vez de prosa. Baseados na API Jev da TypeSafe, servem para tarefas como triagem de tickets ou classificação de conteúdo, e o Ollama os roda num endpoint próprio ao lado dos modelos de conversa.
Prós e contras
Prós
- Os modelos locais são gratuitos e ilimitados, sem conta, chave ou conexão de internet.
- A instalação é um único comando e a biblioteca integrada dispensa a configuração do ambiente.
- A API REST e os endpoints compatíveis com OpenAI e Anthropic deixam clientes existentes migrarem apenas trocando a URL.
- O suporte a Apple Silicon via MLX traz grandes ganhos de velocidade para quem usa Mac.
- Os modelos na nuvem permitem rodar modelos abertos grandes sem ter uma GPU.
Contras
- O desempenho local depende do seu hardware, então modelos grandes pedem VRAM de verdade e um notebook sofre com eles.
- O preço na nuvem varia conforme o modelo e a hora, o que dificulta prever a conta mensal.
- Alguns recursos avançados da nuvem, como rodar vários modelos ao mesmo tempo, são limitados no plano gratuito pelos tetos de concorrência.
- A biblioteca de modelos, embora ampla, é menor que a oferta completa do Hugging Face ou dos grandes provedores de nuvem.
Perguntas frequentes
O Ollama é um ambiente para rodar grandes modelos de linguagem abertos no seu computador ou na nuvem. Ele baixa os modelos, sobe um servidor local e oferece uma linha de comando, um aplicativo de desktop e uma API para trabalhar com eles.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Ollama.
Alternativas a Ollama

X Ray Interpreter
X-ray Interpreter · ImagemO X Ray Interpreter é uma ferramenta de radiologia com IA baseada na web que transforma raios X, tomografias, ressonâncias, ultrassonografias e imagens PET em laudos em linguagem simples. Você envia um exame, recebe uma interpretação preliminar dos raios X em instantes e depois faz perguntas de acompanhamento se algo precisar de explicação. Ele funciona como segunda opinião e como apoio de aprendizado, não como diagnóstico médico.

Aieasypic
AIEasyPic · ImagemO AIEasyPic é um gerador de imagens com IA que transforma prompts de texto simples em obras finalizadas em segundos. Você também pode treinar modelos personalizados com suas próprias fotos, trocar rostos em imagens existentes e criar clipes de vídeo curtos a partir de texto, tudo pelo navegador. Ele serve tanto para criadores casuais que querem imagens rápidas quanto para hobistas que desejam montar um modelo pessoal sem tocar em código.

Chargen
Chargen · ImagemO Chargen é um gerador de personagens com IA e um conjunto de ferramentas de criação de mundos feito para Dungeons & Dragons e outros RPGs de mesa. Ele transforma uma ideia de uma linha em um retrato de personagem pintado, cria NPCs, monstros, mapas e encontros na mesma sessão, e mantém os detalhes de cada criatura à mão. A parte de arte para RPG de mesa funciona com um sistema de créditos chamado Gold, enquanto os geradores de texto seguem gratuitos para todos.