

OpenAI WebSocket Mode for Responses API
OpenAI · Programação
O modo WebSocket da OpenAI para a API Responses é um modo de conexão persistente que permite executar fluxos de agentes longos e cheios de ferramentas sobre um único WebSocket em vez de repetidas requisições HTTP. Você abre uma conexão com o endpoint de Responses e mantém cada turno leve enviando apenas os itens de entrada novos mais um previous_response_id. Ele foi feito para laços de codificação agêntica e orquestração em que a mesma tarefa dispara dezenas de chamadas de ferramentas, e funciona com store=false em ambientes sensíveis à privacidade.
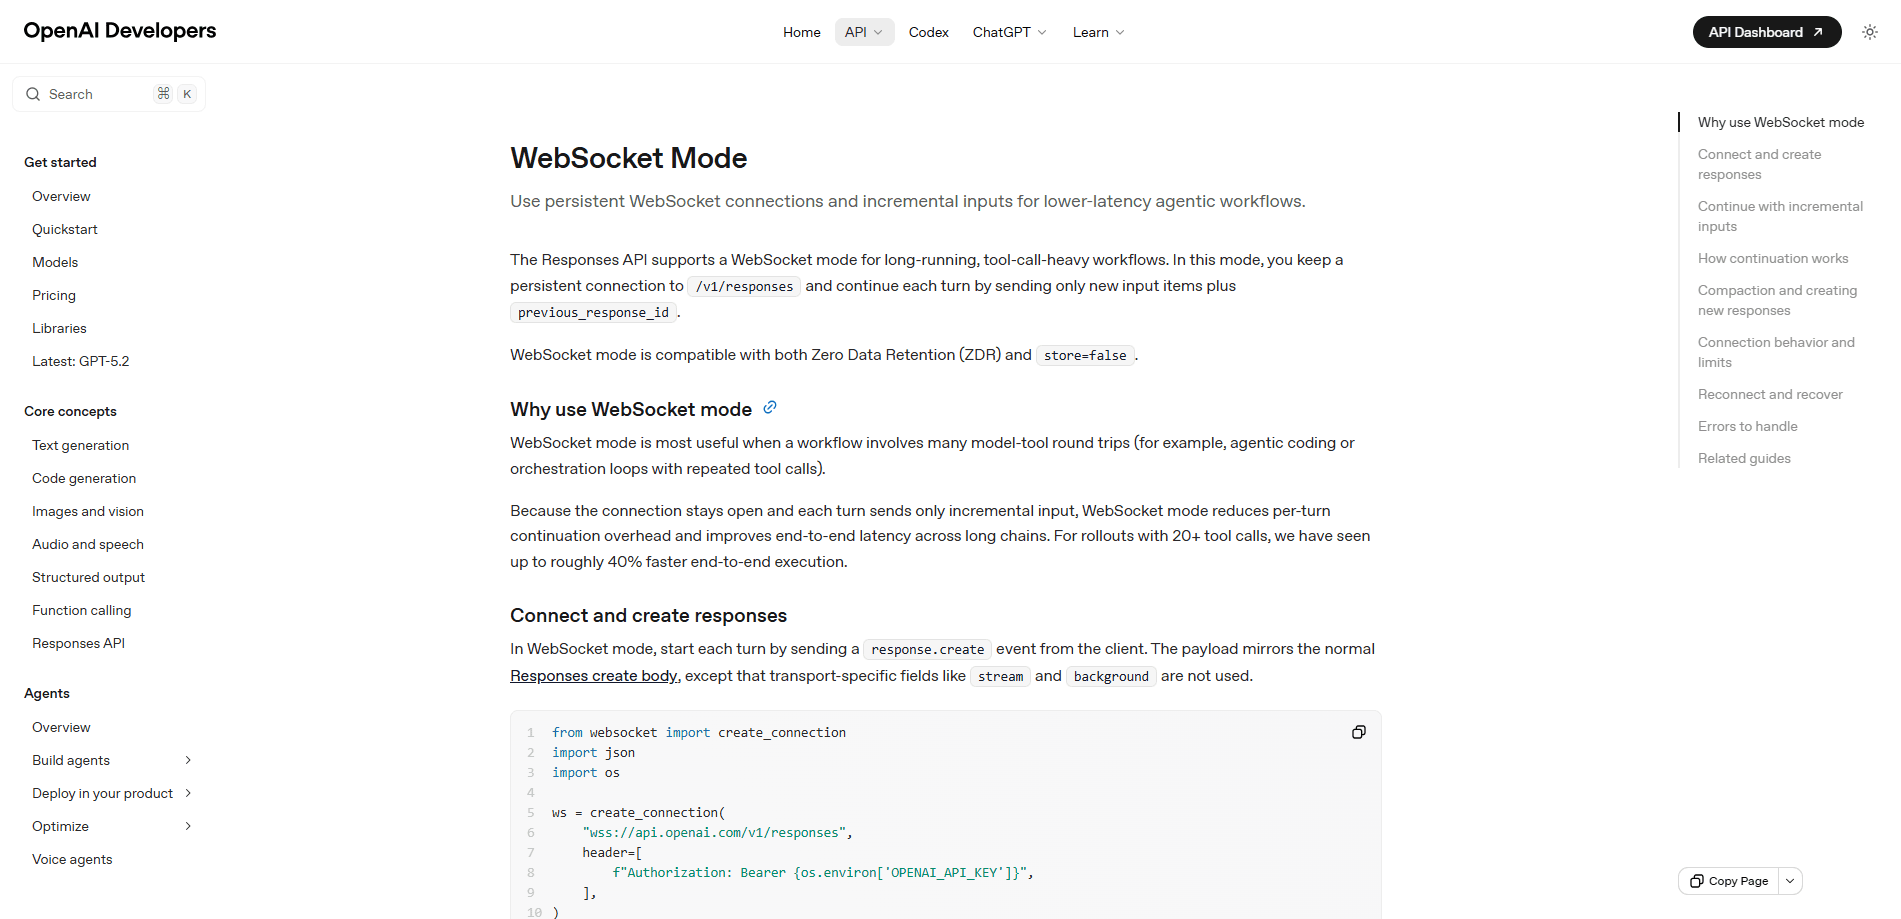
Sobre OpenAI WebSocket Mode for Responses API
O que é o modo WebSocket da OpenAI para a API Responses
O modo WebSocket da OpenAI é uma opção de transporte para a API Responses, não um produto separado. A API Responses é a primitiva com estado da OpenAI para construir apps no estilo agente, e é o endpoint em que quase todo projeto novo começa. O que muda é o cano embaixo dele. Só isso. Todo o resto sobre seus prompts e suas ferramentas continua igual.
O problema que ele resolve é o custo extra de continuação. No modo HTTP padrão, cada turno reabre uma conexão, e você reenvia o contexto que não para de crescer. Isso funciona bem para uma pergunta única. Para um agente que chama ferramentas vinte ou trinta vezes seguidas, todos esses vaivéns se acumulam. O modo WebSocket mantém a conexão aberta com o endpoint de Responses e deixa cada continuação enviar apenas o delta, encadeado por um previous_response_id. Não é nenhum foguete. É só um cano melhor.
A maior limitação é o escopo. Esse modo serve para fluxos longos e cheios de ferramentas, não para tudo. A própria orientação da OpenAI diz que requisições únicas e conversas curtas devem ficar na API Responses por HTTP padrão, onde a otimização rende pouco. A conexão também tem um limite de tempo, então você vai precisar tratar reconexões numa execução longa. Um pouco chato, mas dá para lidar.
Como começar
- Obtenha uma chave de API da OpenAI e instale um cliente WebSocket, como o pacote websocket-client para Python.
- Abra um socket para o endpoint WebSocket de Responses e passe sua chave no cabeçalho Authorization.
- Envie seu primeiro turno com um evento response.create, incluindo o modelo, as ferramentas e a entrada inicial.
- Continue a conversa enviando um novo response.create que referencie o previous_response_id do turno anterior e inclua apenas os itens de entrada novos, como function_call_output.
- Leia os eventos do servidor conforme chegam em streaming e depois feche o socket ou reconecte se atingir o limite de tempo da conexão.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de OpenAI WebSocket Mode for Responses API.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de backend e de IA que constroem agentes que precisam de laços de ferramentas de baixa latência, já que o modo mira o tráfego servidor a servidor.
- Equipes de plataforma que rodam cargas de orquestração em que o mesmo trabalho chama ferramentas dezenas de vezes por implantação.
- Desenvolvedores com restrições de privacidade que precisam de um transporte compatível com store=false e retenção zero de dados.
Tarefas
- Codificação agêntica
- Tratamento de chamadas de ferramentas
- Orquestração multiturno
Cenários
- Um agente de código que percorre análise de arquivos, geração de patches e execução de testes sobre um socket vivo.
- Um serviço de backend que coordena várias chamadas de ferramentas por requisição de usuário, onde a latência por turno importa.
- Uma equipe que quer cortar o custo extra no tráfego de agentes de alto volume sem mudar o modelo nem os prompts.
Principais recursos
Conexão persistente com o endpoint de Responses
O modo WebSocket mantém uma conexão aberta com a API Responses ao longo de muitos turnos. Você o controla com eventos response.create, e o primeiro inicia um turno novo igual a uma requisição normal. Como o socket fica aberto, você pula a configuração de conexão que a API de streaming padrão paga em cada turno. Esse custo é pequeno uma vez. Numa execução longa de agente, deixa de ser.
Entrada incremental com previous_response_id
Cada turno de continuação envia apenas os itens de entrada novos, mais um previous_response_id que liga ao turno anterior. Você não reenvia todo o contexto, e é aí que está a maior parte da economia em cadeias longas. O payload do primeiro turno espelha o corpo padrão de create, menos os campos exclusivos do transporte, como stream e background, que aqui não se aplicam. Assim a requisição continua enxuta mesmo quando a conversa cresce.
Continuação mais rápida para fluxos cheios de ferramentas
O benefício principal aparece quando um fluxo envolve muitos vaivéns entre modelo e ferramenta. Esse é o mundo dos fluxos de agentes de baixa latência, e esse transporte foi feito para eles. A orientação da OpenAI aponta para um ganho de velocidade significativo em implantações com muitas chamadas de ferramentas, com o ganho vindo do caminho de continuação e não só do primeiro token, que é justo a parte que mais desperdiça tempo quando um agente percorre as mesmas ferramentas sem parar. Nem todo fluxo sente isso. Se seu agente quase não chama ferramentas, você não vai notar muito. Se chama o tempo todo, aí está o sentido inteiro.
Funciona com store=false e retenção zero de dados
O modo WebSocket funciona com store=false e com configurações de retenção zero de dados, o que importa se você não pode deixar a OpenAI guardar o estado das respostas. O servidor mantém o estado recente da resposta na memória durante a vida da conexão, então você continua tendo continuações rápidas sem persistir os turnos entre requisições, o que de outro modo deixaria dados para trás no servidor. Para equipes em ambientes regulados ou sensíveis à privacidade, essa combinação é o motivo para escolher esse transporte.
Eventos em streaming e ordem iguais ao modelo HTTP
Os eventos do servidor e sua ordem batem com o modelo de streaming atual da Responses. Se você já trata eventos de streaming por HTTP, os formatos dos eventos parecem familiares, então você não precisa reescrever a lógica do seu cliente do zero. A diferença está no canal de entrega, não no formato da mensagem. Então por que mudar? Por velocidade, nos casos em que ela conta. Isso mantém baixo o custo da migração.
Prós e contras
Prós
- Latência de continuação menor em fluxos com muitas chamadas de ferramentas, que é justo onde o modo HTTP mais dói.
- Enviar apenas a entrada incremental reduz a transmissão repetida e o custo extra de configuração de conexão.
- Aceita store=false e retenção zero de dados, então equipes sensíveis à privacidade podem usá-lo.
- Os eventos do servidor e sua ordem batem com o modelo de streaming HTTP, então o código de cliente existente se adapta fácil.
- Um único socket aberto encaixa melhor em laços de codificação agêntica e orquestração do que requisições HTTP empilhadas.
Contras
- Só vale a pena em fluxos longos e cheios de ferramentas; conversas curtas e chamadas únicas ganham pouco.
- A conexão tem um limite de tempo, então é preciso criar lógica de reconexão para agentes de longa duração.
- O transporte dá mais código para gerenciar do que uma chamada HTTP simples, o que aumenta a complexidade do cliente.
- Você continua pagando as tarifas padrão de uso da API; o modo corta a latência, não o custo por token.
Perguntas frequentes
É um modo de transporte que mantém uma conexão WebSocket persistente com a API Responses em vez de fazer uma requisição HTTP nova a cada turno. Você envia apenas os itens de entrada novos e um previous_response_id, o que corta o custo extra por turno em execuções longas de agente. Pense nisso como ficar na linha em vez de desligar e discar de novo.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a OpenAI WebSocket Mode for Responses API.
Alternativas a OpenAI WebSocket Mode for Responses API
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.