
OpenScience
Synthetic Sciences · Programação · Produtividade
OpenScience é um ambiente de pesquisa com IA de código aberto criado pela Synthetic Sciences. Ele lê artigos, escreve e executa código, consulta bases de dados científicas e mantém as evidências de cada resultado dentro do mesmo projeto.
Sobre OpenScience
About
O que é o OpenScience
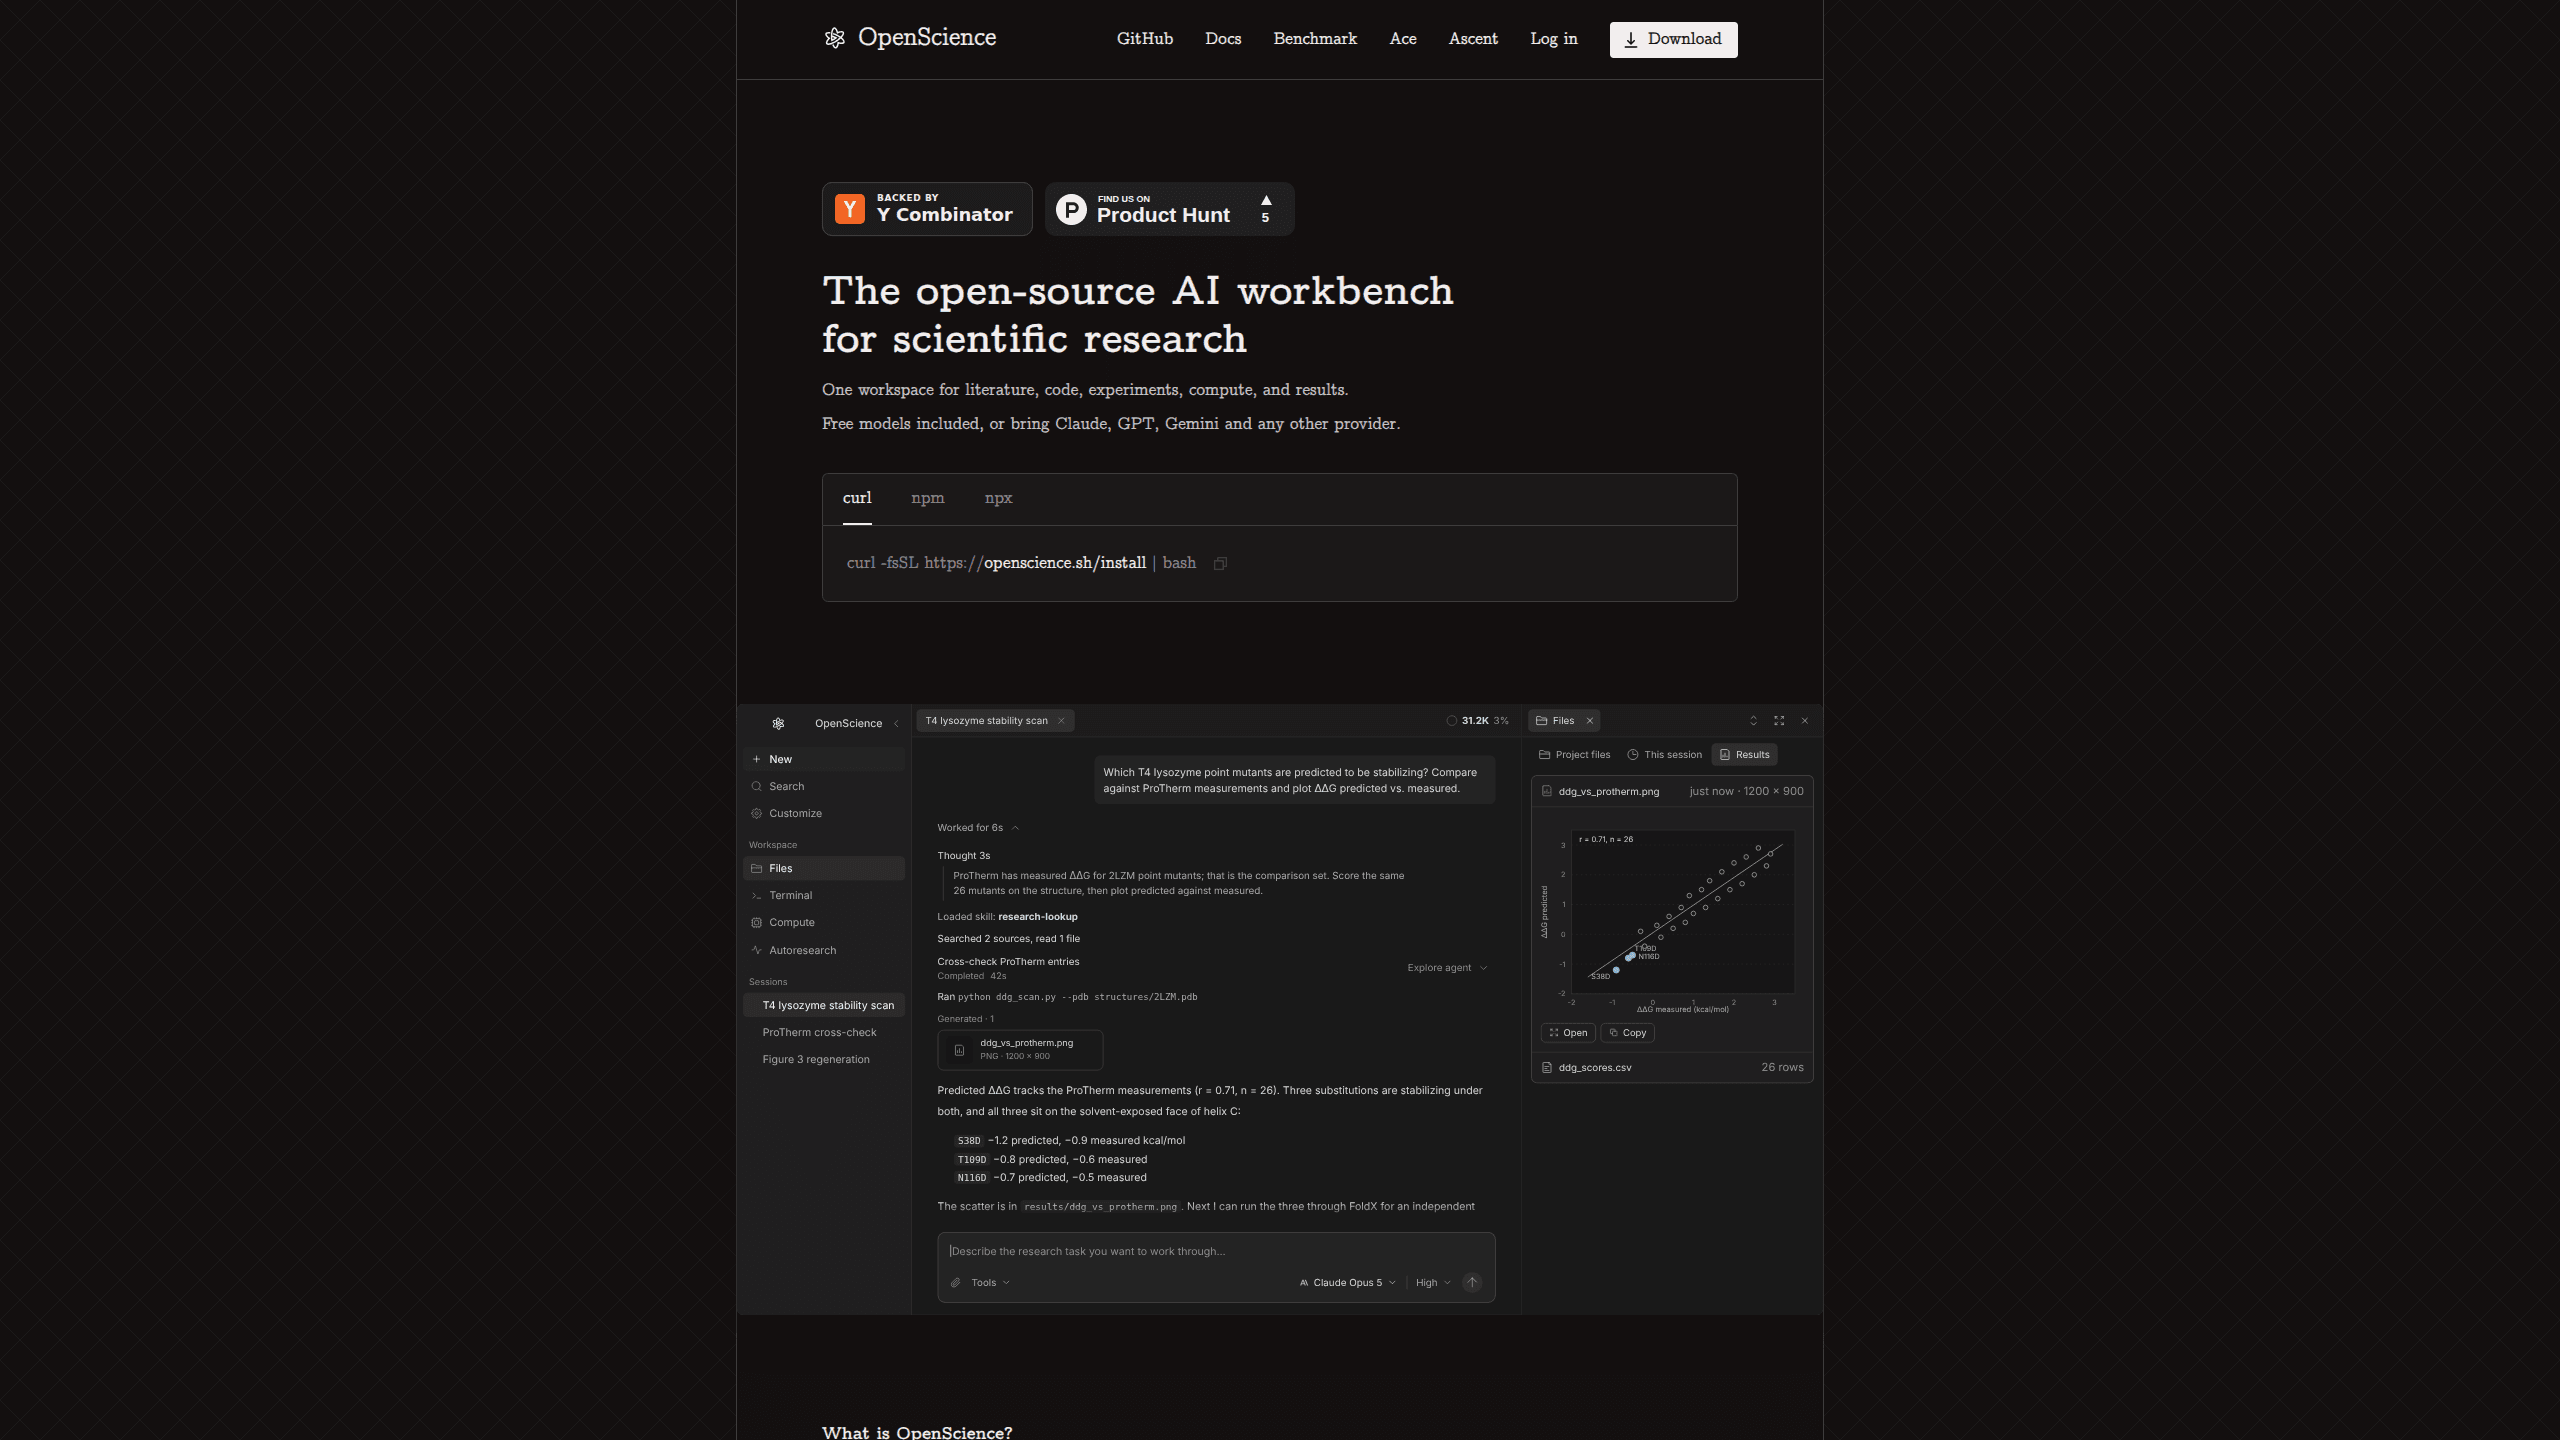
OpenScience é um espaço de trabalho em que um agente de IA conduz tarefas de pesquisa. Você descreve uma pergunta, aponta arquivos ou um conjunto de dados, e o agente consulta a literatura, escreve Python ou R, busca fontes como UniProt e PDB e redige o relatório. A Synthetic Sciences desenvolve o produto, tem apoio da Y Combinator, o apresenta como um co-cientista de IA e publica o código sob a licença Apache 2.0.
A maioria das ferramentas de IA para ciência parte de um único fornecedor de modelos e de um fluxo hospedado na nuvem. Aqui a premissa é o contrário. A análise real salta da janela de chat para o notebook, do notebook para o terminal do cluster e daí para o gerenciador de referências, e o fio que liga uma figura ao código que a gerou costuma se perder nesse caminho. O OpenScience mantém projetos, sessões, arquivos, execuções e resultados no mesmo lugar, para que um colega de laboratório reabra o trabalho meses depois e reconstrua como cada número apareceu. É a face prática da pesquisa reproduzível.
O custo de entrada está na montagem. É preciso instalar o aplicativo de desktop ou a ferramenta de linha de comando e resolver o acesso aos modelos: chave própria, assinatura do fornecedor, modelo local ou o serviço pago Ace. A documentação também pede que o usuário leia os métodos e confira os resultados antes de levar qualquer coisa para um artigo.
Primeiros passos
- Baixe o aplicativo para macOS, Windows ou Linux, ou instale a CLI com npm install -g @synsci/openscience@latest e inicie o ambiente a partir da pasta do projeto.
- Crie uma conta na Synthetic Sciences. O assistente de primeira execução pede a conta mesmo quando você pretende usar chaves próprias.
- Escolha o acesso aos modelos em Customize → Models: modelos gerenciados do Ace, uma chave de API do seu fornecedor, login do ChatGPT ou do Claude, ou um modelo local na sua máquina.
- Crie um projeto e descreva a tarefa com três informações: a entrada, a saída esperada e os limites. Anexe dados ou referencie arquivos que já estejam no projeto.
- Acompanhe a execução, confira o código rodado e as fontes usadas, e exporte o relatório ou continue na mesma sessão.
Um primeiro pedido bem escrito indica um arquivo e um destino. Peça a análise de data/measurements.csv, com checagem de valores ausentes, comparação entre os grupos de tratamento e uma figura mais uma nota de métodos salvas em results/. Assim o agente tem algo concreto contra o que conferir o próprio trabalho.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de OpenScience.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Estudantes de doutorado e pós-doutorandos
- Biólogos computacionais e químicos
- Engenheiros de pesquisa e equipes de aprendizado de máquina
Tarefas
- Revisões de literatura com fontes anexadas
- Análise de dados e estatística
- Reprodução de um resultado publicado
Cenários
- Um laboratório herda o projeto de quem já saiu
- Um grupo tem cluster mas não tem equipe de ferramentas
- Um rascunho precisa da seção de métodos
Principais recursos
Um projeto para todo o ciclo de pesquisa
Cada projeto reúne sessões, arquivos enviados, arquivos gerados e resultados salvos. A conversa guarda as respostas do agente ao lado dos comandos executados, dos arquivos lidos e das fontes citadas. Quando uma figura importa, você volta à sessão que a produziu sem procurar em notebooks antigos.
Troca de modelo a qualquer momento
O OpenScience é independente de modelo. O Ace oferece um catálogo revisado de 21 modelos da OpenAI, Anthropic, Google, xAI, Z.ai, DeepSeek, Qwen, Moonshot, MiniMax, Xiaomi, Meta e NVIDIA em rotas gerenciadas. Você também pode conectar sua chave de API, reaproveitar uma assinatura ChatGPT Plus ou Pro ou rodar um modelo aberto localmente. Trocar de rota não exige começar outro projeto.
42 bases de dados científicas como ferramentas
UniProt, PDB, ChEMBL, PubChem e arXiv vêm incluídas, junto com outras 37 fontes, e o agente as consulta como ferramentas em vez de pedir que você cole os resultados. Num trabalho estrutural, isso significa buscar uma entrada do PDB, pontuar mutantes contra valores medidos e plotar a comparação numa única passada.
371 habilidades incluídas
O cliente chega com 371 habilidades de biologia, química, física, aprendizado de máquina e escrita científica. Um núcleo curado cobre as etapas mais comuns, e todo arquivo de habilidade pode ser lido e editado, então um laboratório ajusta um protocolo às suas convenções ou acrescenta um método interno.
Computação do notebook ao cluster
O agente prepara ambientes e leva um trabalho além da máquina à sua frente. Análises pequenas rodam localmente; varreduras maiores vão para um cluster ou um host com GPU. Essa flexibilidade evita reescrever tudo quando um protótipo de notebook cresce e passa a exigir horas de processamento.
Desktop, navegador e terminal
O mesmo ambiente abre como aplicativo de desktop, no navegador depois que você inicia a CLI, ou com um único comando para pedidos pontuais. Quem vive no terminal e quem prefere uma árvore de arquivos gráfica trabalham no mesmo projeto sem exportar nada.
Prós e contras
Prós
- O código é aberto sob Apache 2.0, então um laboratório pode auditar o que o agente faz, criar um fork ou rodar tudo sem contrato com fornecedor.
- A escolha do modelo continua com você, incluindo modelos locais para dados sensíveis e assinaturas de ChatGPT ou Claude que já estão no orçamento.
- A lista de bases cobre as fontes que projetos de ciências da vida e química realmente citam, e elas funcionam como ferramentas do agente, não como consultas manuais.
- Os resultados preservam a procedência: o código gerador, as entradas e o histórico de execução ficam ligados ao artefato.
- A Synthetic Sciences publica resultados no Terminal-Bench Science, Terminal-Bench 4.0, BiomniBench-DA e no próprio OpenScience Bench, o que entrega números para conferir em vez de uma promessa vaga.
Contras
- Uma conta é exigida na primeira execução, mesmo na versão de código aberto, e o login liga o compartilhamento de traces por padrão. Dá para desativar por dispositivo, mas esse padrão merece atenção em laboratórios clínicos ou industriais.
- A instalação supõe familiaridade com o terminal. Montar a CLI, escolher a rota de modelo e gerenciar chaves dá mais trabalho do que abrir um aplicativo de chat.
- Os números dos benchmarks vêm de execuções do próprio fornecedor e vários usam testes desenhados pela empresa. A replicação independente ainda é escassa.
- O custo dos modelos é separado do software e varia conforme a rota, então uma sessão longa pode sair mais cara do que o previsto se você não acompanhar a carteira e definir um teto.
Perguntas frequentes
O OpenScience é um ambiente de pesquisa com IA de código aberto da Synthetic Sciences. Ele executa um agente que lê artigos, escreve e roda código, consulta bases de dados científicas e salva resultados com as evidências que os sustentam. Funciona como aplicativo de desktop, ambiente no navegador ou CLI.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a OpenScience.
Alternativas a OpenScience

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.