
Orpheus TTS
Canopy Labs · Voz e linguagem
Orpheus TTS é um modelo de texto para fala de código aberto da Canopy Labs, com base Llama 3B, que clona vozes sem treinamento, adiciona tags de emoção e transmite áudio com baixa latência.
Sobre Orpheus TTS
About
O que é o Orpheus TTS
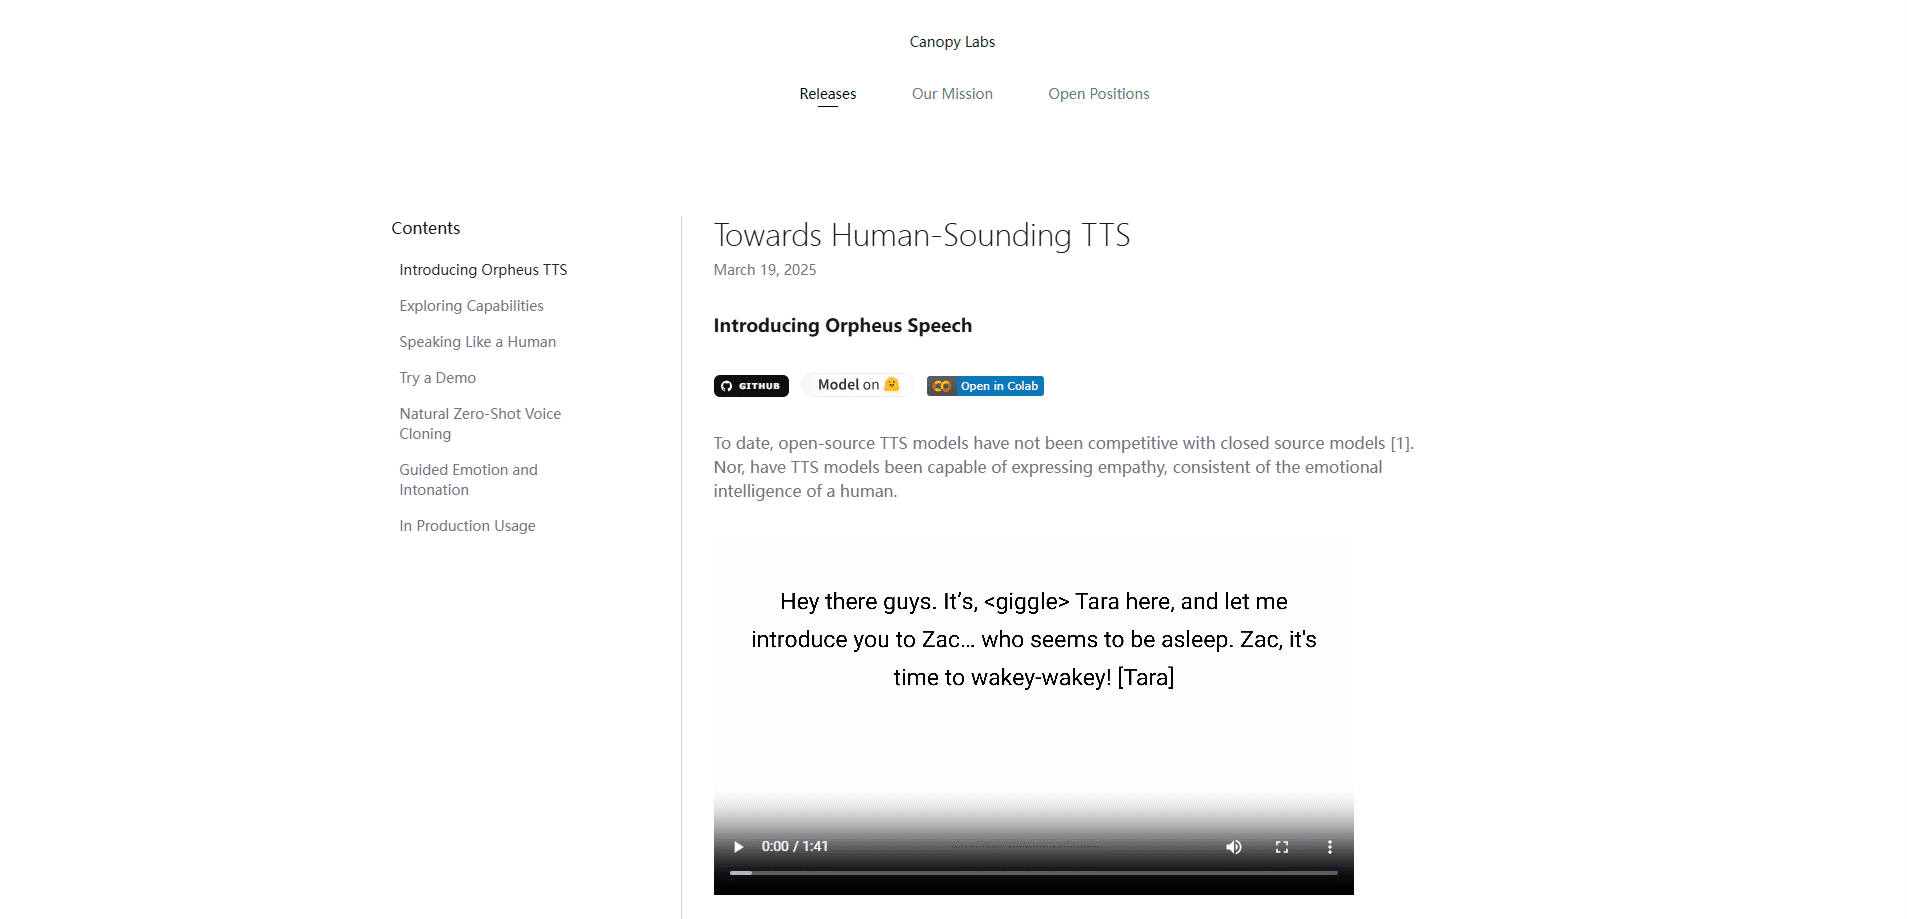
O Orpheus TTS é um modelo de texto para fala de código aberto criado pela Canopy Labs. Ele roda sobre uma base Llama 3B, então a equipe aplica técnicas de modelos de linguagem à síntese de fala em vez de uma cadeia acústica tradicional. O resultado é uma voz com ritmo, entonação e emoção naturais, e o projeto publica o código e os pesos para qualquer pessoa rodar.
A ideia é simples. Os sistemas de fala antigos resolviam cada etapa, a análise do texto, o ritmo e a geração de áudio, com peças separadas. O Orpheus trata o problema como uma tarefa de geração que um modelo de linguagem já sabe fazer. O modelo aprendeu a produzir unidades de fala do mesmo jeito que um modelo de linguagem produz palavras, e esse enquadramento deu origem a um comportamento emergente que, segundo os autores, iguala ou supera algumas opções de código fechado.
Você recebe uma ferramenta para desenvolvedores, não um app pronto. Não existe um site onde você digita uma frase e baixa um arquivo. Você instala o pacote, hospeda o modelo e conecta ao seu próprio produto. Essa flexibilidade importa se você quer voz sem pagar por requisição, e também significa que você cuida do hardware e da configuração.
Primeiros passos
- Clone o repositório ou instale o pacote com pip install orpheus-speech, que usa vllm por baixo para uma inferência rápida.
- Carregue um modelo como canopylabs/orpheus-tts-0.1-finetune-prod pela classe OrpheusModel.
- Escreva o texto com um nome de voz opcional e tags de emoção, e chame generate_speech com uma voz da lista disponível.
- Transmita os trechos de áudio retornados para um arquivo WAV ou direto para o seu app e reproduza em tempo real.
- Para a sua própria voz, prepare um dataset do Hugging Face e rode os scripts de ajuste, mirando em cerca de 300 exemplos por voz.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Orpheus TTS.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que adicionam voz a um app
- Criadores que querem uma voz específica
- Quem monta conversa em tempo real
Tarefas
- Clonar uma voz a partir de uma amostra curta
- Adicionar emoção à narração
- Gerar fala em vários idiomas
- Rodar a fala localmente por privacidade
Cenários
- Alimentar um ciclo de assistente de voz
- Narrar audiolivros e roteiros longos
- Dublar vídeo para outro idioma
Principais recursos
Fala com som humano
O Orpheus TTS produz entonação, emoção e ritmo que, segundo os autores, rivalizam ou superam os melhores sistemas de código fechado. Ele capta sinais no texto e pode encaixar um suspiro ou uma risada onde a escrita sugere. Essa é a promessa principal, e foi o que levou o projeto para a conversa do código aberto. Um texto limpo e com sinais claros dá os melhores resultados.
Clonagem de voz sem treinamento
O modelo pré-treinado copia uma voz sem nenhum ajuste. Dê a ele um ou mais pares texto-fala no prompt e ele imita a pessoa com texto novo. Quanto mais pares você passar, mais seguro ele acerta a voz certa. É isso que o separa de sistemas antigos que exigiam horas de gravação.
Emoção e entonação guiadas
Você guia a entrega com tags simples, como risada, risinho, suspiro, tosse, fungada, gemido, bocejo e arquejo. O modelo lê essas tags como parte do texto e molda o áudio em volta delas. Para diálogos, audiolivros ou um chatbot que precise soar humano, esse controle ajuda muito. As tags aceitas variam conforme o idioma na versão multilíngue.
Streaming de baixa latência
A latência no streaming fica em torno de 200 milissegundos, e a documentação indica que pode cair para perto de 100 com entrada em streaming. Em usos em tempo real, como assistentes de voz, essa diferença decide se a conversa parece natural. O pacote emite trechos de áudio conforme eles são gerados, então você pode começar a reproduzir antes de o clipe ficar pronto.
Vários tamanhos de modelo
Além dos modelos em inglês ajustado e pré-treinado, o projeto planeja várias versões menores de 1B, 400M e 150M parâmetros. Modelos menores trocam um pouco de qualidade por velocidade e hardware mais leve, o que importa se você implanta em máquinas modestas. O roteiro lista esses como próximos lançamentos.
Ajuste com a sua própria voz
O repositório traz scripts de treino e de processamento de dados para adaptar o modelo base ao seu próprio locutor. Os resultados começam a ficar bons após cerca de 50 exemplos, e a equipe sugere mirar em 300 por locutor para o melhor resultado. O processo lembra ajustar um modelo de linguagem com Trainer e Transformers, então ajuda ter base em ML.
Várias formas de rodar
Você pode usar o Orpheus TTS pelo pacote de Python, por um caminho sem GPU com llama.cpp ou por uma implantação dedicada na Baseten, a parceira de inferência preferida do projeto. Builds da comunidade adicionam uma API compatível com OpenAI e uma interface web Gradio. Escolha o caminho que encaixa com o seu jeito de lançar.
Prós e contras
Prós
- Fala com emoção e ritmo naturais que competem com modelos de código fechado
- Clona uma voz sem treinamento a partir de uma amostra curta
- Transmite áudio com latência de cerca de 200 ms para apps em tempo real
- Pesos e código abertos, então você pode rodar por conta própria
- As tags de emoção dão um controle fino da entrega
Contras
- Não há API oficial hospedada, então você hospeda e mantém sozinho
- Precisa de uma GPU para inferência rápida, e o arquivo do modelo base é grande
- A qualidade depende do clipe de referência, então áudio com ruído piora o resultado
- A família multilíngue completa ainda é uma prévia de pesquisa
Perguntas frequentes
O Orpheus TTS transforma texto em fala natural e pode imitar uma voz escolhida. Desenvolvedores usam para assistentes de voz, narração, dublagem e pesquisa sobre modelos de fala. É uma peça que você conecta a um projeto maior, não um produto independente.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Orpheus TTS.
Alternativas a Orpheus TTS

Prosp
Prosp · Escrita · Voz e linguagem · MarketingO Prosp é uma ferramenta de abordagem no LinkedIn com IA, feita para agências e equipes de vendas, e escreve a mensagem e a nota de voz com a sua própria voz para cada prospect, para que eles realmente respondam. Você conecta suas contas, encontra leads e deixa a IA redigir e enviar mensagens personalizadas em escala, tudo em uma única caixa de entrada. É feita para quem faz abordagem em volume. Essa é toda a proposta. Cada toque ainda precisa parecer humano.

Wordly AI Translation
Wordly · Voz e linguagem · ProdutividadeO Wordly AI Translation é uma plataforma de tradução e legendagem com IA em tempo real feita para reuniões, conferências e eventos. Ele entrega tradução ao vivo, legendas, transcrições e resumos em mais de 60 idiomas, e os participantes entram escaneando um QR code ou abrindo um link em vez de usar fones dedicados. A plataforma funciona com Zoom, Microsoft Teams, Google Meet e Webex, e foi pensada para organizações que querem acesso multilíngue sem contratar intérpretes humanos para cada sessão. Simples assim.
Musicful
Musicful AI · Voz e linguagem · VídeoO Musicful é um gerador de música com IA e um criador de videoclipes com IA que transforma texto em música em minutos. Você entrega um texto, um conjunto de letras ou uma melodia cantarolada e ele devolve uma faixa pronta com vocais e instrumentos. Também funciona como gerador de músicas com IA, produz videoclipes a partir das músicas que você cria e oferece uma ferramenta de cover com IA mais uma API para desenvolvedores. A plataforma roda no navegador e em um app para Android, então você pode começar uma música no computador e continuar no celular.