
Parallax by Gradient
Gradient · Outros
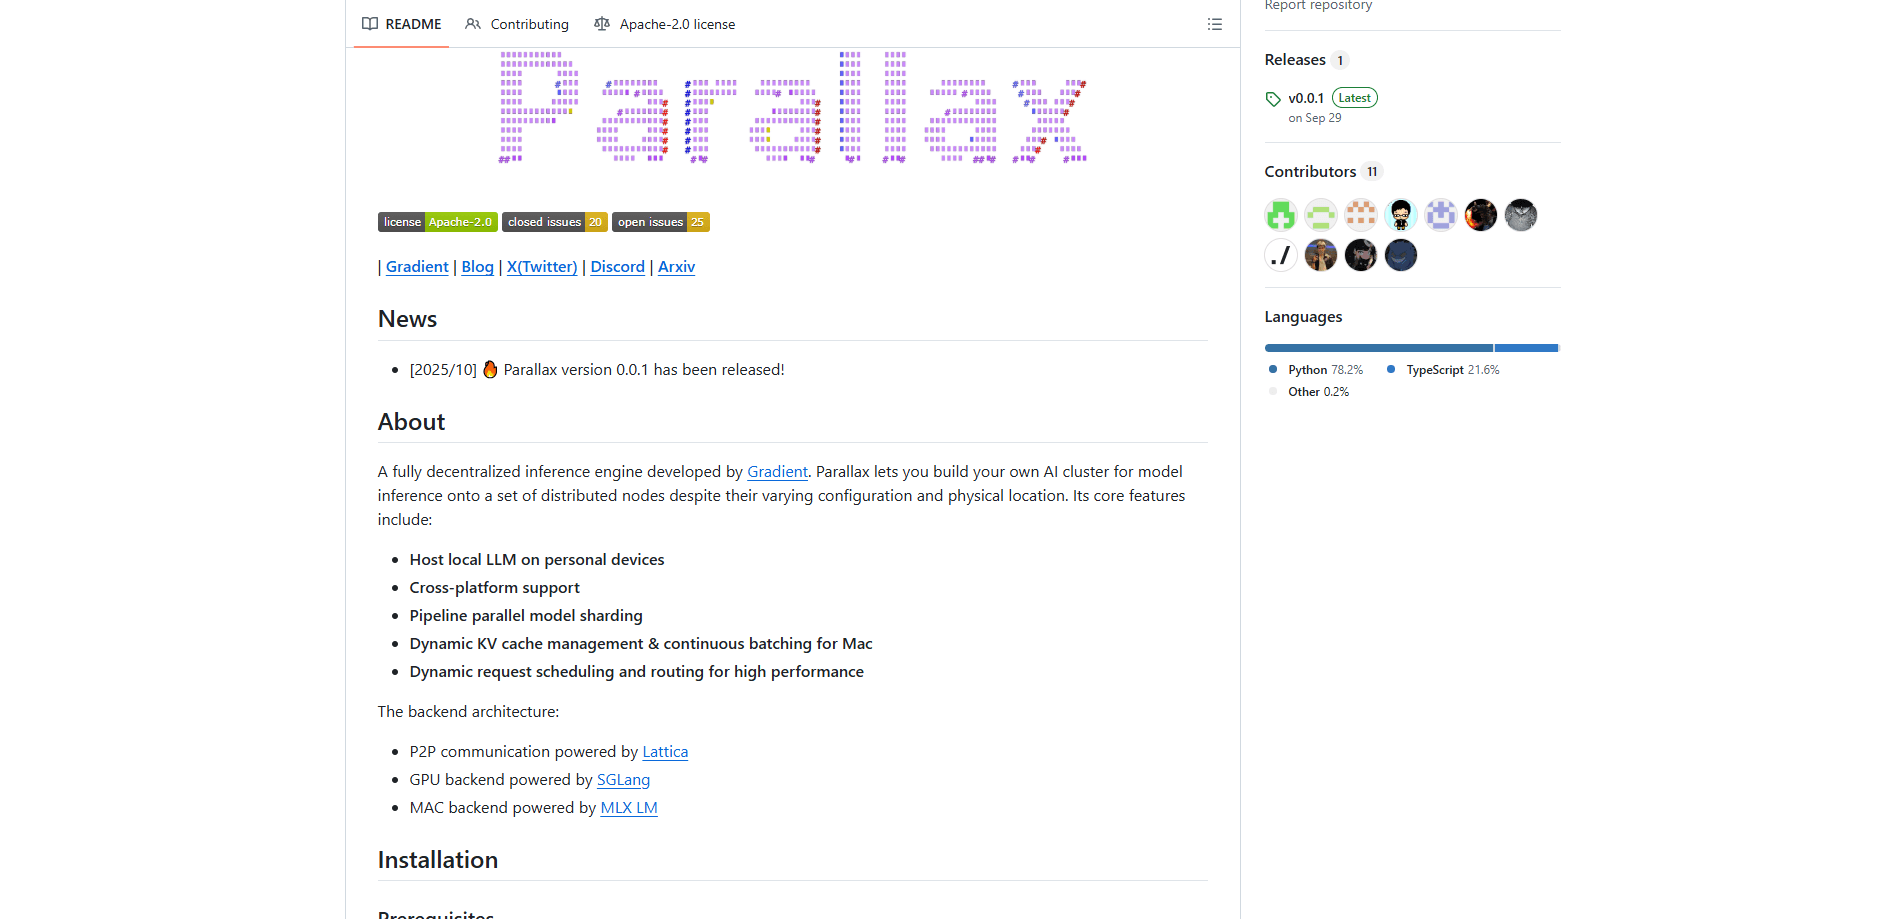
O Parallax by Gradient é um mecanismo de inferência totalmente descentralizado com o qual você monta o seu próprio cluster de IA para executar grandes modelos de linguagem em vários dispositivos, por mais diferentes que sejam seus componentes ou onde estejam fisicamente. Em vez de alugar GPUs na nuvem, você reúne as máquinas que já tem e serve modelos como Qwen, DeepSeek e GLM a partir de um único endpoint local.
Sobre Parallax by Gradient
O que é o Parallax by Gradient
O Parallax é um framework de código aberto para clusters de IA distribuídos, criado pela Gradient. Ele divide um grande modelo de linguagem entre várias máquinas e roda a inferência em todas ao mesmo tempo, de modo que um notebook, um desktop com GPU e um pequeno servidor do outro lado da rede doméstica funcionam como uma única máquina maior. Tudo conversa por um protocolo ponto a ponto, o que significa que não existe um servidor central que precise ficar online. Essa é a proposta.
O problema que ele resolve é simples de enunciar e doloroso de conviver. Rodar um LLM competente normalmente significa ou pagar por token a um provedor de nuvem, ou comprar uma GPU caríssima em que o modelo inteiro caiba. O Parallax segue um terceiro caminho. Ele fragmenta o modelo camada por camada e transmite as requisições pelo hardware que você tiver, então você aproveita mais os dispositivos que já estão sobre a sua mesa. Seus prompts e resultados ficam nas suas próprias máquinas, o que importa se você lida com algo que prefere não enviar a terceiros.
A principal limitação é que esta é uma ferramenta para desenvolvedores, não um app de instalar com um clique. Você precisa estar à vontade no terminal e, no Linux, pode contar que vai mexer com Docker ou configurar drivers de GPU. O projeto também é novo. A versão 0.0.1 chegou em outubro de 2025, então arestas soltas são esperadas e o suporte a modelos muda a toda hora. Se você quer algo que simplesmente funcione de cara, sem configuração nenhuma, uma API hospedada vai te tratar melhor.
Primeiros passos
- Instale o cliente clonando o repositório e rodando
./install.sh, que prepara um ambiente virtual de Python e compila os binários necessários. Usuários de Windows podem baixar um instalador independente. - Ative o ambiente com
source .venv/bin/activatee confirme que os extras do seu hardware foram detectados, pois as compilações de GPU para macOS e Linux instalam componentes de backend diferentes. - Inicie o nó local com um comando como
parallax serve -m Qwen/Qwen3.5-0.8B, escolhendo um modelo que caiba na sua memória combinada. - Una máquinas adicionais ao mesmo cluster para que os fragmentos do modelo alcancem todos os dispositivos que você adicionou.
- Aponte seu app ou script para o endpoint local e envie requisições como faria a qualquer API compatível com OpenAI.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Parallax by Gradient.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que já têm algumas máquinas e querem rodar cargas de LLM auto-hospedadas sem contas de nuvem, desde que não se importem de trabalhar pelo terminal.
- Equipes atentas à privacidade que lidam com texto sensível e preferem manter a inferência no hardware local a enviar prompts para uma API hospedada.
- Hobbistas curiosos sobre montagens de cluster de IA distribuído e dispostos a gastar uma tarde na configuração.
Tarefas
- Hospedar um endpoint de LLM compartilhado para um laboratório doméstico ou escritório pequeno, onde várias pessoas apontam suas ferramentas para um mesmo servidor local.
- Testar e comparar modelos abertos como Qwen, DeepSeek ou GLM em hardware real, em vez de pagar por cada execução de benchmark.
- Construir agentes e ferramentas internas que precisam de um backend de inferência de IA local, sem dependência de fornecedor nem limite de uso.
Cenários
- Um projeto de fim de semana para tirar um modelo maior de um notebook mais um desktop reserva com GPU.
- Rodar um assistente de código nas máquinas do escritório para que nenhum código-fonte saia do prédio.
- Experimentar a fragmentação de modelo por paralelismo de pipeline para ver até onde vai o hardware de consumo somado.
- Qualquer pessoa que queira rodar um LLM localmente entre algumas máquinas mistas e dispensar a nuvem por completo.
Principais recursos
Fragmentação distribuída do modelo
O Parallax divide um modelo entre dispositivos usando paralelismo de pipeline, então cada máquina guarda apenas uma fatia da rede, e não ela inteira. É isso que permite que hardware com especificações bem diferentes coopere em um mesmo modelo. Você pode ampliar o cluster adicionando nós, e o framework ajusta como o trabalho é dividido.
Cluster independente de hardware
O mecanismo não exige máquinas idênticas. Ele resolve a parte difícil de rotear requisições entre nós com configuração e localização física variadas, que é justamente o sentido de uma montagem descentralizada. Um Mac, um equipamento Linux com GPU e uma máquina Windows podem participar do mesmo cluster.
Comunicação ponto a ponto
Os nós conversam entre si por meio do Lattica, uma camada P2P, então não há um único ponto de falha na rede. Se um nó cai, o cluster não desmorona junto. Esse desenho é o que faz rodar o cluster "em qualquer lugar" ser mais do que uma frase de marketing.
Compatibilidade multiplataforma
Você pode instalar o Parallax no Windows, no Linux e no macOS. O backend de GPU se apoia em SGLang e vLLM, enquanto os Macs rodam via MLX LM. Os caminhos de instalação mudam conforme o sistema, e o projeto traz um instalador para Windows mais imagens Docker para máquinas com GPU. O ganho é hospedagem de LLM de verdade multiplataforma: um cluster, vários sistemas operacionais, sem mexer no código.
Tratamento otimizado de requisições
No Mac, o Parallax adiciona gerenciamento de cache KV paginado e batching contínuo, técnicas que seguram o uso de memória enquanto atende muitas requisições. O agendamento de requisições se ajusta na hora para decidir qual nó cuida de quê, com o objetivo de manter a produtividade alta em todo o cluster.
Serviço compatível com OpenAI
Depois que um nó está rodando, ele expõe um endpoint que suas ferramentas atuais podem chamar quase como uma API hospedada. Isso significa que apps, scripts e agentes que você já construiu não precisam ser reescritos. O projeto também documenta um caminho de integração para o OpenClaw.
Prós e contras
Prós
- Grátis e de código aberto, então não há conta por token e você pode ler exatamente como a inferência funciona.
- Transforma hardware que você já tem em um cluster de LLM funcional, incluindo máquinas de características bem diferentes.
- Mantém prompts e resultados nos seus próprios dispositivos, o que ajuda com privacidade e conformidade.
- O suporte multiplataforma permite compartilhar uma mesma instalação entre Macs e máquinas Linux com GPU.
- A arquitetura P2P dispensa um servidor central, então não há um único ponto de falha.
Contras
- A configuração é de nível desenvolvedor. Não é um app de um clique, e instalações de GPU no Linux podem envolver Docker ou trabalho com drivers.
- O projeto está em fase inicial. Espere suporte a modelos em mudança e quebras ocasionais.
- O desempenho depende inteiramente do seu hardware; dispositivos de consumo somados não vão igualar um cluster de GPU na nuvem.
- A documentação ainda está sendo completada, então parte do diagnóstico passa por ler o repositório ou perguntar no Discord.
Perguntas frequentes
Sim. O Parallax by Gradient é de código aberto e gratuito, sem assinatura. Você paga apenas a eletricidade e o hardware em que já o executa. Não há plano pago, então o preço de "$0" cobre o produto inteiro.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Parallax by Gradient.
Alternativas a Parallax by Gradient
BinkBink
BinkBink · OutrosO BinkBink é uma plataforma de jogos online gratuita e um criador de jogos com IA que deixa qualquer pessoa transformar uma breve descrição em texto em um jogo de navegador jogável. Você pode entrar em centenas de jogos feitos pela comunidade. Ou descreve a sua própria ideia, joga em segundos e compartilha com amigos. Quer criar seu próprio jogo? Não precisa programar. Sem configurar motor, sem download, sem complicação.

Audiogen
Audiogen Inc. · OutrosO Audiogen é um gerador de música com IA criado pela Audiogen Inc., uma equipe de pesquisa pequena que passou cerca de 2,5 anos treinando o próprio modelo de música generativa e desenhando uma interface web em volta dele. Em vez de uma simples caixa de texto, essa ferramenta de música com IA transforma a linha do tempo em uma Estação de Trabalho de Áudio Generativo, ou GAW, voltada para iniciantes, na qual o inpainting, a extensão, a remixagem e a edição de faixas funcionam mais como pintar em uma tela. O produto ainda está em beta, então o acesso passa por uma lista de espera ou por um convite. Os planos pagos ainda não foram publicados.

Aiml API
AIMLAPI OÜ · OutrosA Aiml API é uma API unificada de modelos de IA que coloca mais de 1000 modelos da OpenAI, Google, Anthropic e outros por trás de um único endpoint e uma única fatura. Você escreve código contra um só esquema compatível com OpenAI e depois alterna entre modelos de chat, imagem, vídeo e áudio mudando uma string de modelo. Ela serve para desenvolvedores e equipes pequenas que querem acesso multimodelo sem administrar uma dúzia de contas de fornecedor separadas, e elimina a dor de cabeça comum de faturamento que vem com testar vários fornecedores. Uma chave cobre tudo.