
Reflection 70B
HyperWrite · Escrita · Chatbot
O Reflection 70B é um modelo de pesos abertos da HyperWrite. Construído sobre o Llama 3.1 70B, este LLM com autocorreção revisa o próprio raciocínio antes de responder.
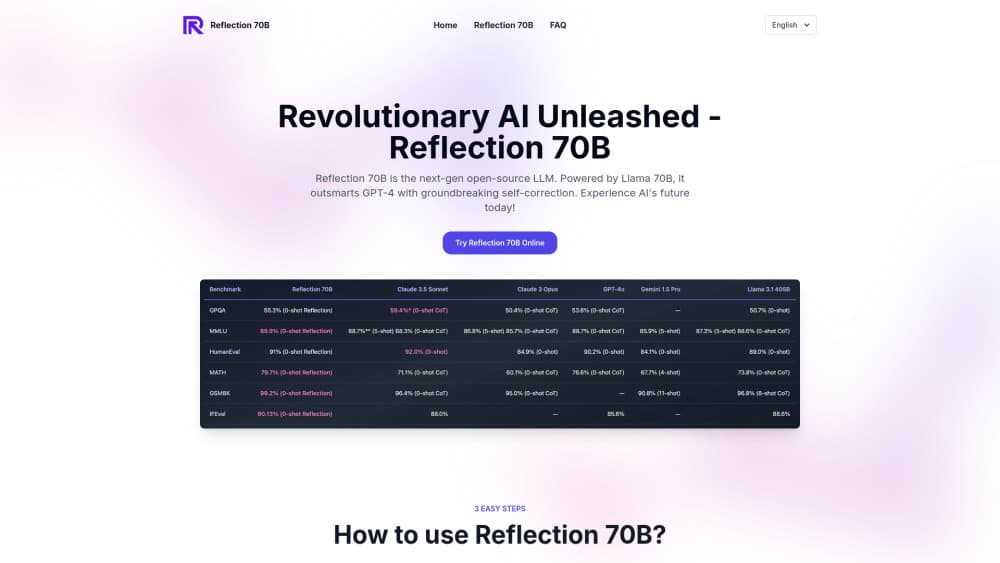
Sobre Reflection 70B
O que é o Reflection 70B
O Reflection 70B é um modelo de linguagem voltado ao raciocínio, da HyperWrite, lançado no início de setembro de 2024 e construído sobre o Llama 3.1 70B Instruct, da Meta. Seu atrativo é um método de treinamento chamado Reflection-Tuning, que ensina o modelo a identificar erros na própria cadeia de pensamento e corrigi-los antes de dar uma resposta final. O modelo escreve seu raciocínio dentro de tags <thinking> e sua resposta final dentro de tags <output>, e adiciona um bloco <reflection> sempre que detecta um erro no meio do raciocínio.
A ideia ataca uma frustração real. Os LLM padrão alucinam. Raramente percebem que alucinam. O Reflection 70B foi treinado para perceber. Segundo a HyperWrite, o modelo superou o GPT-4o e até o Llama 3.1 405B em testes como MMLU, MATH, IFEval e GSM8K. Esses números atraíram uma atenção enorme no lançamento.
Esse hype inicial não resistiu ao contato com terceiros. Avaliadores independentes, incluindo o Artificial Analysis, não conseguiram reproduzir os números de destaque. Testes posteriores descobriram que as versões publicadas no Hugging Face rendiam pior que o próprio Llama 3.1 70B puro, sobre o qual foi construído. Alguns usuários também acusaram a API hospedada de desviar pedidos para o Claude sem avisar. Matt Shumer, da HyperWrite, reconheceu que o modelo ficou abaixo dos benchmarks divulgados.
A conclusão honesta, então, é dividida. A abordagem Reflection-Tuning é realmente interessante. O modelo como foi entregue nunca igualou o próprio marketing. Lançamentos de modelos de pesos abertos como este ainda valem estudo, mesmo quando o discurso de lançamento os vende demais.
Como começar
- Abra a página do modelo no Hugging Face (mattshumer/Reflection-70B) ou em um espelho, e aceite os termos da licença.
- Baixe os pesos, ou pule a instalação local e rode-o por um provedor de inferência hospedada.
- Carregue-o com o mesmo código que você usaria para qualquer modelo Llama, já que ele compartilha o template de chat do Llama.
- Envie a mensagem de sistema de raciocínio para que ele retorne, em ordem, as seções de pensamento, reflexão e resposta.
- Leia as tags
<reflection>se quiser ver onde o modelo mudou de ideia.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Reflection 70B.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Pesquisadores de IA
- Desenvolvedores que criam ferramentas de raciocínio locais
- Entusiastas curiosos sobre prompts de reflexão
Tarefas
- Problemas de matemática e lógica
- Prototipar pipelines de autoverificação
- Estudos comparativos
Cenários
- Rodar um modelo de raciocínio sem enviar dados para uma API fechada
- Estudar as armadilhas da avaliação
- Experimentar prompts de reflexão com pouco orçamento
Principais recursos
Reflection-Tuning
O Reflection-Tuning é a técnica que dá nome ao modelo. Em vez de treinar só com respostas finais, ele treina o modelo para revisar o próprio raciocínio e reescrevê-lo durante a geração. Na prática, o modelo produz um rascunho do seu pensamento, confere-o e reescreve as partes que julga erradas antes de entregar uma resposta. Essa ordem é a ideia toda: corrige e depois confirma.
Tags estruturadas de pensamento e saída
O modelo separa seu trabalho interno da resposta usando tokens especiais. O raciocínio fica dentro de tags <thinking>, e a resposta final dentro de tags <output>. Essa separação mantém o rascunho visível, o que ajuda quando você quer depurar por que um modelo chegou a uma conclusão, ou quando prefere esconder o pensamento e mostrar só a resposta.
Autocorreção em linha
Quando o modelo percebe um erro, ele emite um bloco <reflection> dentro do seu pensamento. Você pode ler esse bloco para ver exatamente onde o raciocínio virou. Em tarefas com uma única resposta certa, essa virada visível costuma ser mais útil que a própria resposta, porque mostra o modelo pegando o próprio deslize em vez de enterrá-lo.
Compatibilidade com Llama
Como parte do Llama 3.1 70B Instruct e mantém o formato de chat padrão do Llama, o Reflection 70B entra em ferramentas e pipelines que já suportam Llama. Se você já implantou um modelo Llama antes, o código de carregamento e a configuração de serviço se reaproveitam com pouca mudança. Essa compatibilidade é o motivo pelo qual o modelo foi fácil de testar desde o início.
Foco em raciocínio de alta precisão
O modelo mira tarefas que premiam precisão acima de velocidade, como matemática e lógica de várias etapas. Ele divide o raciocínio em etapas distintas e gasta mais tokens conferindo-as. O preço é a latência. As respostas demoram mais a chegar e os custos de tokens sobem, porque refletir significa escrever mais texto antes de você obter a linha final.
Pesos abertos
Os pesos estão disponíveis publicamente, então você pode rodar o modelo no seu próprio hardware, ajustá-lo ou estudar como o treinamento de reflexão mudou o comportamento dele. Pesos abertos também significam que você não fica preso ao preço nem aos limites de um único fornecedor, o que importa se você testa o modelo em qualquer escala.
Prós e contras
Prós
- Pesos abertos que você pode baixar, inspecionar e auto-hospedar
- Construído sobre o Llama 3.1 70B, então funciona com o ferramental e os stacks de serviço Llama que você já tem
- Autocorreção visível pelas tags de pensamento, reflexão e saída
- Grátis para rodar localmente, com inferência hospedada barata quando você prefere não gerenciar GPUs
Contras
- Os benchmarks independentes nunca confirmaram as alegações de desempenho do lançamento
- Algumas versões do Hugging Face teriam pontuado abaixo do Llama 3.1 70B puro
- Etapas longas de pensamento e reflexão adicionam latência e custo de tokens
- A API hospedada atraiu acusações de desviar tráfego para o Claude, o que abalou a confiança
Perguntas frequentes
É um modelo de linguagem de código aberto da HyperWrite, construído sobre o Llama 3.1 70B Instruct, que usa um método de treinamento chamado Reflection-Tuning para conferir e corrigir o próprio raciocínio antes de responder.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Reflection 70B.
Alternativas a Reflection 70B

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

MePersona
MePersona, Inc. · Escrita · Produtividade · MarketingMePersona é uma caixa de entrada unificada com IA para criadores de conteúdo. Aprende o seu jeito de escrever, rascunha respostas aos fãs em 12 plataformas e envia apenas o que você aprova.

Fluence
Yay Software (Yannick Huchard) · Escrita · Voz e linguagem · ProdutividadeO Fluence é um app de Android que lê em voz alta PDF, EPUB, arquivos do Word e artigos da web, acompanha a frase falada e responde perguntas sobre o texto sem sair do celular.