

Rememberall
wrannaman · Programação · Aprendizado
O Rememberall é uma ferramenta de memória para IA de código aberto. Dá aos GPTs e aos apps de IA memória persistente entre conversas, com uma API REST auto-hospedada.
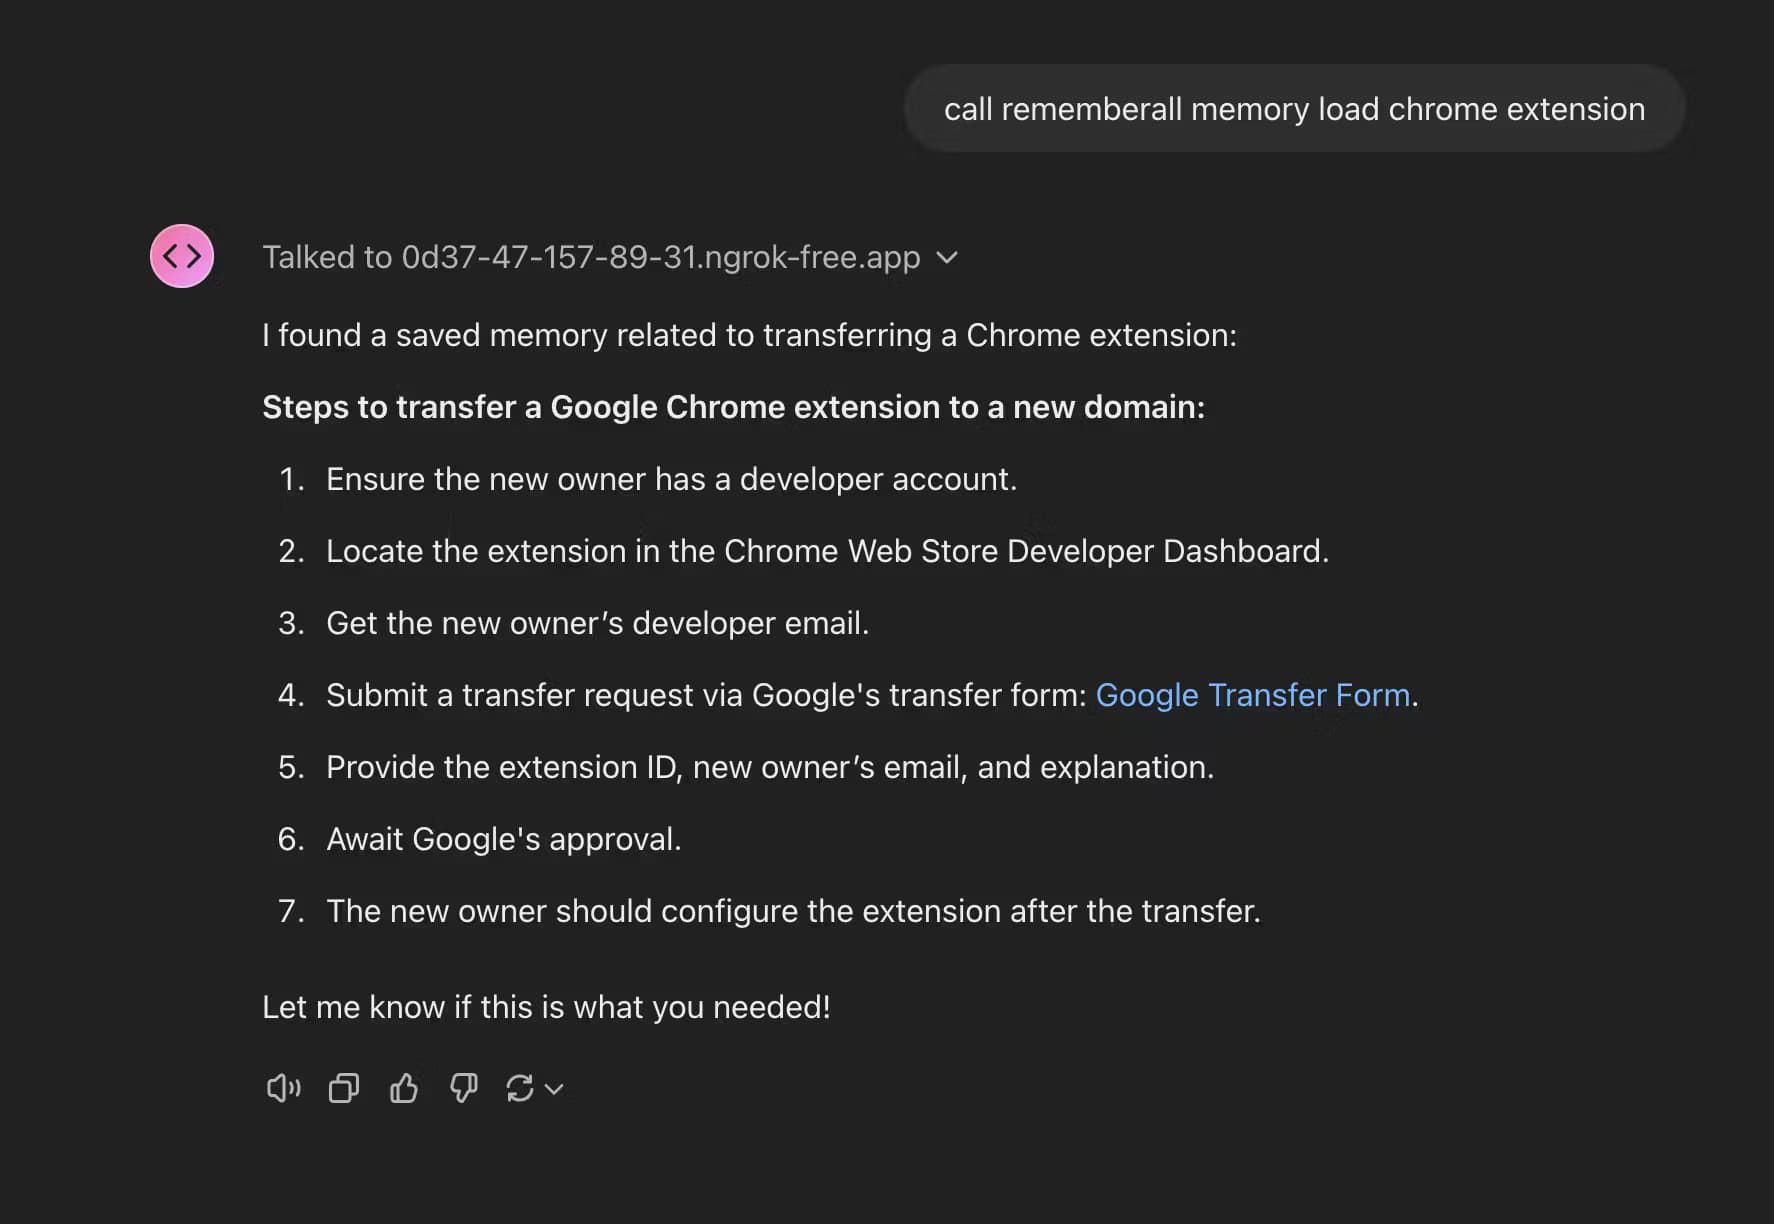
Sobre Rememberall
O que é o Rememberall
O Rememberall é uma camada de memória de longo prazo para aplicações de IA. Guarda fatos e contexto de conversas passadas e depois puxa de volta os relevantes quando o usuário pergunta sobre eles. O problema que ele ataca é simples e irritante: quase todo chatbot esquece tudo no momento em que a sessão termina, então cada continuação começa do zero e você acaba se repetindo em cada conversa nova.
A ideia central é um repositório de memória que é seu. Em vez de confiar seu histórico de conversas a um fornecedor, você roda o Rememberall por conta própria e ele mantém os dados. As memórias entram por uma API REST, são indexadas para busca semântica e voltam ordenadas por significado em vez de coincidência exata de palavras. Quando você pergunta "o que decidimos sobre autenticação na semana passada", o repositório consegue trazer uma nota salva como "tokens JWT com validade de 24 horas". Aí está o ganho.
O Rememberall foi feito para criadores do GPT Store e desenvolvedores de IA. Você o adiciona a um GPT personalizado com uma especificação OpenAPI e menciona @rememberall na conversa para salvar ou recuperar contexto. Os desenvolvedores também podem chamar a API diretamente. Os limites honestos: é um projeto jovem, seu último push de código foi em janeiro de 2025, e a instalação auto-hospedada supõe que você se vira bem com Docker.
Primeiros passos
- Para quem cria GPTs, instale o Rememberall pela GPT Store e adicione-o à configuração do seu GPT personalizado usando a especificação OpenAPI fornecida.
- Mencione @rememberall na sua conversa do GPT para armazenar informações ou recuperar contexto passado.
- Para desenvolvedores, clone o repositório e faça o deploy da pilha com Docker Compose a partir da pasta deploy.
- Autentique suas requisições com um token Bearer, porque todos os endpoints exigem isso.
- Use a API para escrever memórias com POST /memory e buscá-las com GET /memories, ou gerencie tudo pelo painel.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Rememberall.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Criadores do GPT Store
- Desenvolvedores de IA e curiosos
- Equipes atentas à privacidade
Tarefas
- Armazenar contexto de conversa
- Recuperar discussões passadas
- Gerenciar memórias salvas
- Ligar a memória a um GPT
Cenários
- Um GPT de suporte que precisa lembrar a configuração de um cliente e os tickets anteriores entre conversas separadas.
- Um assistente de pesquisa que deveria recordar descobertas anteriores sem você colar tudo de novo.
- Um assistente pessoal que acompanha projetos em andamento e retoma de onde você parou.
Principais recursos
Memória persistente entre conversas
O Rememberall mantém o contexto vivo depois que uma conversa termina. Guarde um fato em uma sessão, pergunte sobre ele na seguinte e ele volta. Simples. Essa é a razão de existir da ferramenta, e resolve a reclamação mais comum sobre os GPTs: a amnésia que reinicia cada conversa no instante em que você fecha a aba.
Busca semântica sobre as memórias salvas
As memórias são indexadas e buscadas por significado, não por redação exata. O exemplo do README tem um usuário perguntando sobre decisões de autenticação da semana anterior, e a ferramenta traz a nota sobre autenticação com JWT. Você recebe resultados relevantes mesmo quando sua consulta não compartilha nenhuma palavra com o que foi salvo. Por que isso importa? Porque a busca por palavra exata falha no momento em que você formula a pergunta de outro jeito, e isso acontece o tempo todo em conversas reais.
Armazenamento baseado em vetores
O repositório de memória usa armazenamento vetorial para alimentar essa busca. Os vetores deixam o sistema comparar o significado de uma consulta com tudo o que foi salvo, então um histórico grande continua pesquisável em vez de virar uma pilha de texto que você rola à mão. Sem arquivamento manual. O README diz que o armazenamento vetorial é auto-hospedado em vez de alugado.
Implantação auto-hospedada e com privacidade em primeiro lugar
Você roda o Rememberall por conta própria com Docker Compose, então os dados das conversas ficam na sua infraestrutura. O projeto lista criptografia de ponta a ponta, controle de acesso detalhado e tratamento de dados conforme o GDPR. Esse é o recurso que o separa dos complementos de memória hospedados. Também é o que soma trabalho de instalação. Você troca conveniência por controle.
API REST simples
Dois endpoints cobrem o básico: POST /memory para escrever uma memória e GET /memories para listá-las ou buscá-las, com limit e offset para paginar. Toda requisição precisa de um token Bearer. Fácil o bastante. Para desenvolvedores, é uma barra baixa. Você pode conectá-la a um GPT, a um script ou a um app próprio.
Especificação OpenAPI para integração com GPT
Para quem cria GPTs, o caminho de integração é uma mudança de configuração, não um projeto de programação. Você aponta seu GPT personalizado para a especificação OpenAPI incluída e o GPT ganha capacidades de memória. Depois, @rememberall na conversa dispara um salvamento ou uma recordação. Rápido de montar. Mantém o fluxo conversacional, que é exatamente onde a memória precisa viver.
Painel para gerenciar a memória
O projeto traz um painel onde você vê e gerencia o que foi armazenado. Isso importa. Memória que você não pode inspecionar é memória em que você não pode confiar, e o painel transforma o repositório de caixa-preta em algo que você pode auditar e podar.
Código aberto e extensível
O código é aberto, então você pode lê-lo, fazer um fork e mudar como a memória funciona para ajustá-la ao seu caso. Não é fechado. Para uma camada de memória que toca conversas sensíveis, poder inspecionar a implementação é mais do que um extra agradável.
Prós e contras
Prós
- Resolve o problema do esquecimento dos GPTs de forma direta: as memórias persistem entre conversas separadas.
- A auto-hospedagem mantém os dados das conversas na sua própria infraestrutura em vez da de um fornecedor.
- A busca semântica devolve memórias relevantes mesmo quando as palavras da sua consulta diferem do que foi salvo.
- A API REST e a especificação OpenAPI tornam a integração realista tanto para criadores quanto para desenvolvedores.
- O código aberto deixa você auditar e personalizar a lógica de memória, o que importa com dados sensíveis.
Contras
- A auto-hospedagem joga a carga de operação para você, então você vai precisar de habilidades com Docker, um servidor para rodar tudo e um plano de atualizações e backups.
- O projeto é jovem e seu último push no repositório foi em janeiro de 2025, então espere uma comunidade pequena e documentação que anda devagar.
- Não há preços publicados porque não há plano hospedado; você traz sua própria infraestrutura e os custos dela.
- A instalação para criadores de GPTs envolve editar a configuração com uma especificação OpenAPI, o que vai frustrar quem queria uma instalação com um clique.
Perguntas frequentes
Ele dá memória de longo prazo a apps de IA e GPTs personalizados. Em vez de esquecer uma conversa quando a sessão termina, o Rememberall salva o contexto em um repositório e o recupera depois, então a IA consegue recordar discussões, preferências e decisões passadas em conversas futuras.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Rememberall.
Alternativas a Rememberall

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.