
RLAMA
Dontizi · Programação · Produtividade
O RLAMA é uma ferramenta de linha de comando grátis e de código aberto que cria sistemas RAG privados sobre os seus documentos, com modelos locais do Ollama para que nada saia da sua máquina.
Sobre RLAMA
What Is RLAMA
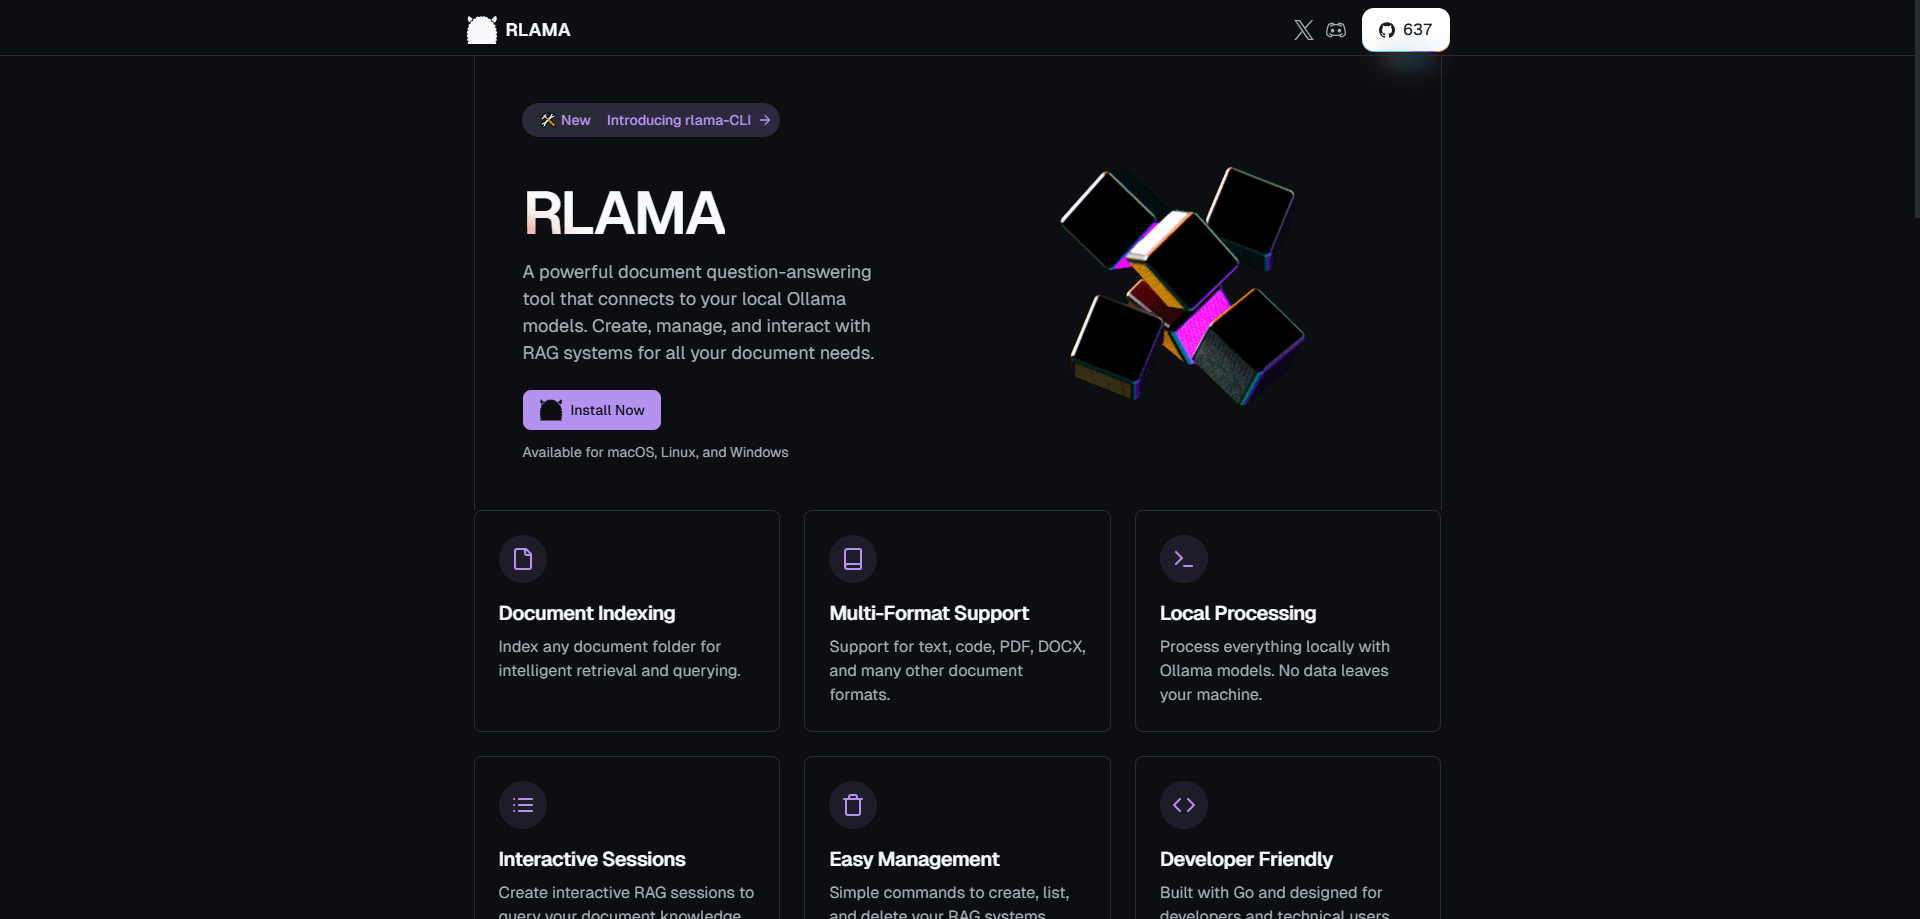
O RLAMA é uma ferramenta de perguntas e respostas para os seus próprios documentos, feita para rodar inteira no seu computador. É uma ferramenta RAG local de linha de comando que se apoia no Ollama, o aplicativo que roda modelos de linguagem offline, e transforma uma pasta de arquivos em uma base de conhecimento consultável. O desenvolvedor publica tudo sob a licença Apache 2.0, então o código é aberto e pode ser usado de graça.
A ideia é direta. Você aponta para uma pasta, o RLAMA lê os arquivos, quebra cada um em trechos e guarda no seu disco os vetores de cada trecho. Quando você faz uma pergunta, a ferramenta encontra os trechos que combinam, entrega para o seu modelo local e o modelo responde usando o seu material como contexto. Esse método se chama geração aumentada por recuperação (RAG), e é ele que mantém as respostas presas a fontes reais em vez de deixar o modelo improvisar de memória.
O ponto fraco está na instalação. O RLAMA é uma CLI, não um app de um clique, então você trabalha no terminal e precisa do Ollama instalado e rodando antes de qualquer coisa funcionar. Também não existe versão hospedada, que é justamente o que se espera de uma ferramenta RAG auto-hospedada. Os resultados dependem do modelo que você escolher e da qualidade dos seus documentos, e uma máquina fraca ou um modelo pequeno aparecem nas respostas. O projeto também está em pausa, então não há recursos novos chegando agora.
Getting Started
- Instale o Ollama em ollama.ai e baixe pelo menos um modelo, por exemplo ollama pull llama3.
- Instale o RLAMA com o script de uma linha: curl -fsSL https://raw.githubusercontent.com/dontizi/rlama/main/install.sh | sh.
- Crie um sistema RAG apontando para uma pasta: rlama rag llama3 meus-docs ./docs.
- Abra uma sessão interativa e pergunte: rlama run meus-docs.
- Adicione arquivos depois com rlama add-docs, ou ligue o monitoramento de pasta para que entrem sozinhos no índice.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de RLAMA.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores que querem busca local de documentos
- Equipes que se preocupam com privacidade
- Quem já usa o Ollama
- Quem quer entender como o RAG funciona
Tarefas
- Perguntar sobre uma pasta de documentação
- Consultar um repositório de código
- Montar uma base a partir de um site
- Manter a base atualizada
- Levar RAG para outra ferramenta
Cenários
- Um freelancer com contratos de clientes que não pode subir em lugar nenhum
- Um desenvolvedor procurando num repositório grande
- Um pesquisador com uma pilha de PDFs
- Um hobista testando modelos pequenos
Principais recursos
Pipeline RAG local
Use o comando rag para indexar uma pasta, o run para consultá-la e os arquivos locais em ~/.rlama para guardar tudo. Os documentos são lidos, divididos em trechos, viram embeddings pelo Ollama e ficam no disco. Nada toca um servidor externo, que é o ponto da ferramenta.
Várias estratégias de divisão
O RLAMA parte os documentos de quatro formas: tamanho fixo, semântica, hierárquica e híbrida. O modo híbrido escolhe o melhor método por tipo de arquivo e trata o Markdown por títulos, o código por funções e classes, e o texto puro por parágrafos. Trechos melhores significam recuperação melhor, e é aqui que muitas ferramentas RAG ficam no básico.
Rastreamento e monitoramento de sites
O comando crawl-rag cria um RAG a partir de um site em vez de uma pasta, com controles de profundidade, concorrência e caminhos excluídos. O web-watch vigia esse site e incorpora páginas novas ao índice, então um site de documentação se mantém atual sem reindexar à mão.
Monitoramento de pastas
Você pode apontar um RAG para uma pasta e fazer o RLAMA checá-la em um intervalo, ou só quando o RAG é usado. Arquivos novos entram sozinhos no índice, o que tira a etapa de lembrar de rodar add-docs a cada mudança.
Servidor de API integrado
O comando api sobe um servidor HTTP, e um único endpoint POST /rag aceita o nome do RAG, um prompt e um tamanho de contexto opcional. Assim você pluga perguntas e respostas sobre documentos locais num script, num app pequeno ou numa ferramenta que não fala CLI.
Modelos do Ollama e do Hugging Face
O RLAMA se apoia no Ollama tanto para os embeddings quanto para a geração, e aceita qualquer modelo que o Ollama consiga rodar. Os comandos hf-browse e run-hf chegam ao catálogo GGUF do Hugging Face para você buscar e testar um modelo antes de colocá-lo num sistema RAG.
Prós e contras
Prós
- Roda totalmente offline, então os documentos não saem da sua máquina e não há custo por consulta.
- Grátis e de código aberto sob Apache 2.0, com um único binário em Go que se instala em uma linha.
- Quatro estratégias de divisão e um rastreador de sites vão além da maioria das soluções RAG locais.
- O servidor de API integrado transforma a CLI em algo que outras ferramentas podem chamar.
- Funciona no Linux, macOS e Windows sem depender da nuvem.
Contras
- É só uma CLI, então quem espera um app de desktop vai ter que trabalhar no terminal.
- A instalação exige o Ollama rodando e modelos baixados antes de começar, e esse passo trava os novatos.
- A qualidade das respostas segue o modelo escolhido, então um modelo pequeno em máquina fraca dá resultados rasos.
- O desenvolvimento está em pausa, o que significa que agora não há recursos novos e as correções saem mais devagar.
Perguntas frequentes
O RLAMA monta um sistema privado de perguntas e respostas sobre os seus próprios arquivos. Você indexa uma pasta ou um site, depois pergunta e recebe respostas tiradas desse material, tudo com modelos locais do Ollama.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a RLAMA.
Alternativas a RLAMA
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.