

Salad - GPU Cloud
Salad Technologies · Programação
O Salad é uma nuvem de GPU distribuída que roda contêineres de IA e modelos de pesos abertos em cerca de 16.000 GPUs ativas por dia em mais de 190 países, a partir de US$ 0,015 por hora de GPU.
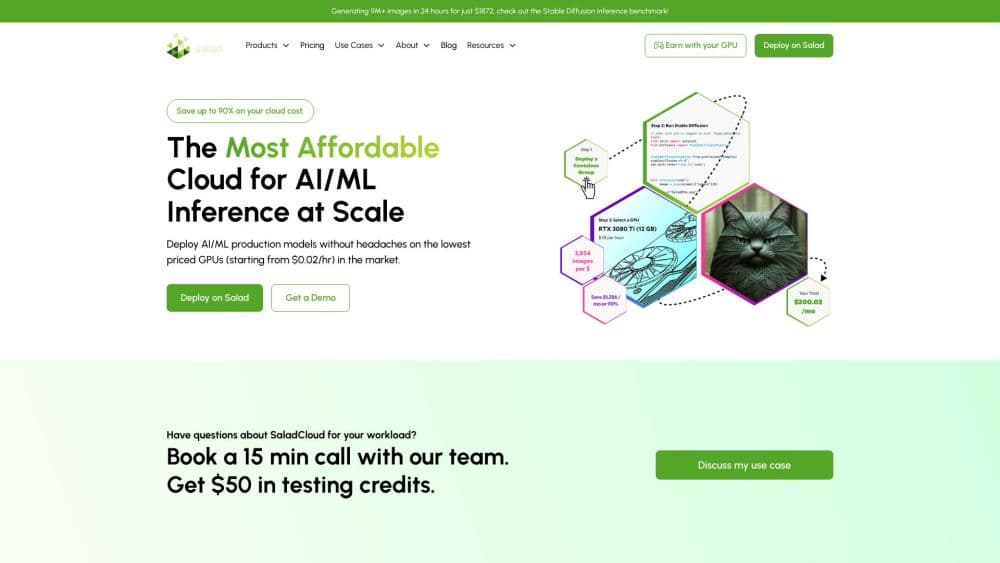
Sobre Salad - GPU Cloud
What Is Salad
O Salad é uma nuvem de GPU montada sobre hardware que a empresa não possui. Em vez de encher data centers com racks iguais, ele reúne GPUs de consumo e de estação de trabalho que ficam ociosas em PCs gamer e pequenos escritórios pelo mundo, e aluga essa capacidade para desenvolvedores e empresas que rodam cargas de IA. O resultado é um pool de processamento que custa bem menos que as nuvens tradicionais. Ele também se comporta de modo diferente em alguns pontos importantes.
Como plataforma de inferência de IA, ela cobre três frentes. Você pode fazer implantação de contêineres em GPU numa rede distribuída de GPUs da linha RTX, chamar modelos de pesos abertos por um endpoint de tokens compatível com OpenAI, ou transcrever e sintetizar áudio com APIs dedicadas. A mesma camada de orquestração roda na Community Cloud, em hardware reservado da Dedicated e na Private Cloud dentro das suas próprias máquinas.
O principal trade-off é a previsibilidade. Como os nós pertencem a pessoas físicas, instâncias podem ser realocadas ou desconectadas quando uma máquina sai do ar. O Salad lida com isso usando níveis de prioridade e realocação automática, mas ele serve para cargas que toleram interrupção, não para clusters rígidos de disponibilidade constante.
Getting Started
- Crie uma conta no SaladCloud e verifique seus dados.
- Gere uma chave de API no portal, ou uma chave do AI Gateway se você só precisa de tokens de modelos.
- Empacote sua carga como contêiner Docker, ou escolha um modelo de pesos abertos no catálogo do Gateway.
- Implante pelo portal ou com uma única chamada de API. Defina um nível de prioridade e um número de réplicas.
- Acompanhe os logs e confira os resultados. A cobrança só corre enquanto a instância está em execução.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Salad - GPU Cloud.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Startups de IA com orçamento apertado
- Desenvolvedores solo e criadores independentes
- Engenheiros de ML que prototipam pipelines de inferência
Tarefas
- Geração de imagem e vídeo em lote
- Transcrição de áudio e texto em fala
- Servir LLMs de pesos abertos
Cenários
- Escalar uma demo para produção sem reservar capacidade de data center
- Esticar uma bolsa de pesquisa
- Manter inferência sensível no seu próprio hardware
Principais recursos
Pool de GPU distribuído
O Salad agenda contêineres em cerca de 16.000 GPUs ativas por dia, vindas de PCs gamer e estações de trabalho em mais de 190 países. O hardware já existe, então a plataforma coordena oferta em vez de financiar novos data centers. É isso que mantém os preços baixos.
Salad Container Engine
Essa camada de orquestração faz a implantação de contêineres em GPU em nós que nunca viu antes. Ela verifica cada máquina, isola a máquina atrás de um hipervisor e realoca o trabalho no momento em que um nó desaparece. Você envia uma imagem Docker com alguns ajustes de recursos, sem ajustar servidores na mão.
AI Gateway
O Gateway é uma API compatível com OpenAI para modelos de pesos abertos como o Qwen 3.6 e o Qwen 3.5. As versões maiores trazem uma janela de contexto de 262.144 tokens. Aponte qualquer SDK da OpenAI para uma nova URL base e seus agentes, assistentes de código ou apps passam a pagar por token ou uma mensalidade fixa.
Níveis de prioridade e cobrança por segundo
Quatro níveis de prioridade deixam você trocar confiabilidade por custo. A prioridade alta nunca sofre preempção; o nível mais baixo é o mais barato e o mais interrompível. A cobrança para no instante em que uma instância para, e a alocação, o download da imagem e a inicialização a frio são gratuitos.
APIs especializadas por modalidade
O Salad publica endpoints ajustados para tarefas específicas. Sua API de transcrição chegou a 95,1% de precisão no CommonVoice, e seu serviço de texto em fala é citado em até 6 milhões de palavras por dólar. Cada número leva a uma metodologia declarada, não a uma promessa de marketing.
Implantações privadas e dedicadas
Além do pool compartilhado, servidores Dedicated reservados rodam por contrato com placas RTX PRO 6000 Blackwell, e a Private Cloud licencia a mesma pilha de orquestração para hardware que você já tem. Na Private Cloud, os dados da empresa ficam nos equipamentos da empresa.
Prós e contras
Prós
- Aluguel de GPU barato: o preço por hora de GPU começa em cerca de US$ 0,015 por nó RTX 4090 na nuvem distribuída, uma fração do que as nuvens comuns cobram por trabalho comparável.
- A cobrança por segundo, sem contratos nem mínimos, deixa experimentos pequenos baratos de rodar.
- O motor de contêineres e o AI Gateway reaproveitam ferramentas padrão de Docker e OpenAI, o que reduz o trabalho de migração.
- Endpoints especializados de transcrição e texto em fala cobrem tarefas de áudio comuns sem configuração extra.
- As opções Private Cloud e Dedicated mantêm cargas sensíveis em hardware que você controla.
Contras
- Instâncias podem sofrer preempção ou ser desconectadas quando os donos dos nós saem, então serviços sempre ativos precisam de lógica de repetição.
- Os nós são GPUs de consumo em casas e pequenos escritórios, o que descarta o treinamento multi-GPU fortemente acoplado que os data centers permitem.
- Não há teste gratuito, então você paga desde o primeiro teste. O custo de entrada é baixo, mas nada é de graça.
- O AI Gateway ainda está em acesso antecipado e seu catálogo de modelos é mais enxuto que o de provedores dedicados de tokens.
Perguntas frequentes
Não. Você só paga pelos segundos em que uma instância fica em execução. Alocação, download da imagem e inicialização do contêiner são gratuitos.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Salad - GPU Cloud.
Alternativas a Salad - GPU Cloud
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.