
SemanticGuard
SemanticGuard · Programação
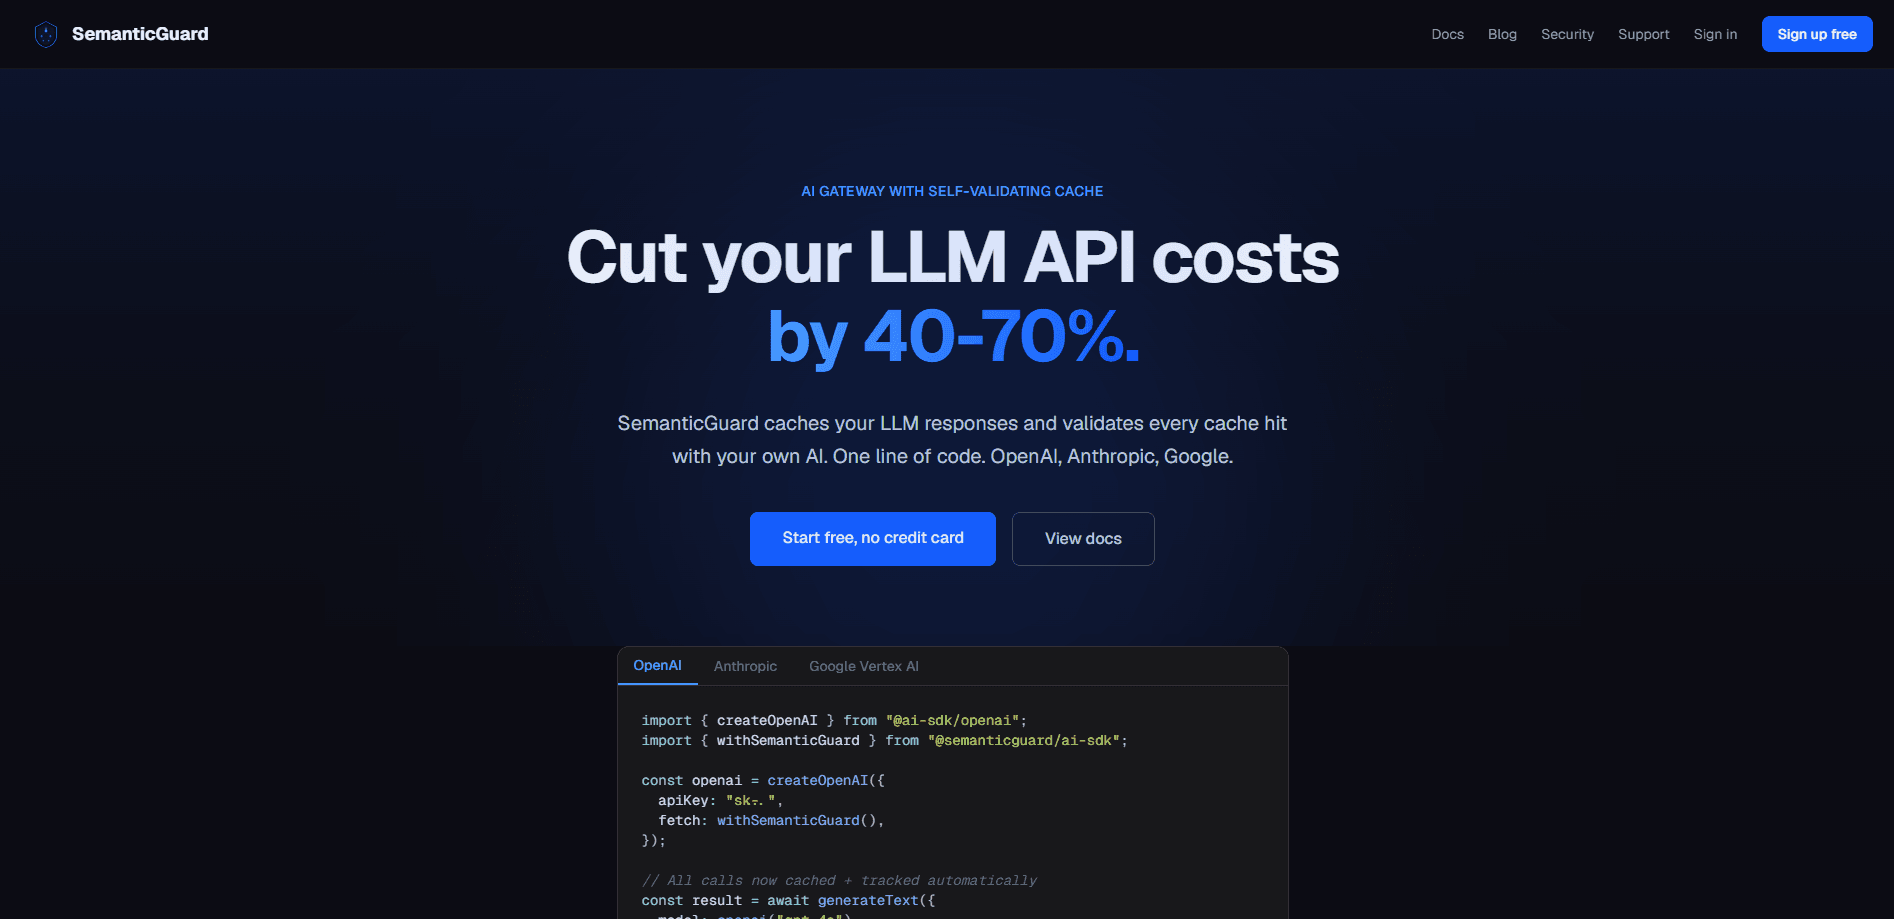
O SemanticGuard é um gateway de IA que fica entre o seu app e os provedores de LLM que você já usa. Ele faz dois trabalhos ao mesmo tempo: guarda as respostas em cache para você parar de pagar o preço cheio por perguntas repetidas, e audita e controla as chamadas de ferramenta que seus agentes de IA fazem. O fornecedor relata uma economia mediana de 50% no gasto com LLM em seu próprio benchmark, com um plano gratuito dimensionado para 10K requisições por mês e um plano Pro a $49/mês.
Sobre SemanticGuard
O que é o SemanticGuard
O SemanticGuard é um proxy compatível com OpenAI com um cache semântico autovalidado. Aponte seu cliente para ele em vez do provedor, insira uma chave de API do SG, e cada requisição fica em cache, logada e rastreada. O atrativo? O cache não confia em si mesmo. Uma segunda camada revisa os acertos com a sua própria IA antes de servi-los, então uma paráfrase que cai perto de uma consulta antiga não devolve a resposta errada em silêncio.
A outra metade é a governança de agentes de IA. Cada chamada de ferramenta que seu LLM emite aparece em um feed de atividade com o nome, os argumentos, o modelo e a atribuição de sessão. Um classificador classifica cada chamada como leitura, escrita ou destrutiva. Depois, um motor de políticas permite, nega ou sinaliza para aprovação. Isso pega a falha clássica em que um run_shell de aparência inofensiva esconde um rm -rf, ou um agente tenta fazer push direto para a main.
O detalhe é que isso é infraestrutura, não um app de consumo. Você precisa de um lugar para executá-lo, chaves de API para gerenciar e pelo menos uma noção clara de como seu tráfego de LLM flui. O cache também pressupõe repetição real no seu tráfego; um app de baixo volume com prompts únicos a cada vez verá pouco benefício. O Modo Sombra existe para você medir a sua própria economia antes de gastar um dólar.
Primeiros passos
- Cadastre-se em semanticguard.dev e crie uma chave de API no painel. Não é preciso cartão de crédito para o plano gratuito.
- Ative o Modo Sombra primeiro. Ele registra cada requisição e mostra quanto você economizaria antes de qualquer resposta em cache ser de fato servida.
- Encaminhe seu tráfego pelo proxy. Configure
ANTHROPIC_BASE_URLpara o Claude Code, ou adicione o wrapper fetch do AI SDK com a sua chave do SG às chamadas de OpenAI, Anthropic, Google, Azure, Bedrock ou Mistral. - Revise o painel até se sentir confortável com a economia projetada, depois ative o cache e defina suas regras de política para chamadas destrutivas de ferramenta.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de SemanticGuard.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores em busca de economia de custos com LLM
- Equipes de engenharia que usam governança de agentes de IA
Tarefas
- Cortar o gasto com API de LLM
- Auditar chamadas de ferramenta dos agentes
- Bloquear ações destrutivas dos agentes
Cenários
- Agentes em produção que tocam sistemas ao vivo
- Configurações com vários provedores
- Equipes que querem um único proxy do Claude Code
Principais recursos
Cache semântico autovalidado
O cache combina por significado, não só por palavras, então uma pergunta reformulada ainda pode acertar. O que o diferencia é a camada de validação: os acertos passam por verificação em várias camadas e amostragem contínua julgada por IA, então a correção é tratada como algo a provar, não a presumir. O fornecedor afirma 100% de correção do cache em seu benchmark público, e o cache entre provedores significa que a resposta de um modelo pode servir a uma paráfrase destinada a outro.
Governança de chamadas de ferramenta dos agentes
Cada chamada de ferramenta que seu LLM emite cai em um feed de atividade com o nome da ferramenta, os argumentos, o modelo e a atribuição completa da sessão. Um classificador determinístico classifica cada chamada como leitura, escrita ou destrutiva. Se você já encaminha pelo SemanticGuard, isso funciona sem nenhuma mudança de código.
Motor de políticas com regras de aprovação
Você define o que roda e o que não roda, por padrão, nível de risco, espaço de trabalho ou usuário. Padrões sensatos já vêm no primeiro dia: negar chamadas destrutivas em prod, exigir aprovação para deploys, bloquear PRs para a main. Edições de regras aparecem na trilha de auditoria em segundos.
Integração com o AI SDK em uma linha
Adicione um wrapper fetch a qualquer provedor com o Vercel AI SDK. Funciona com OpenAI, Anthropic, Vertex AI e qualquer outra coisa que aceite uma função fetch personalizada. Para o Claude Code e outros clientes do SDK da Anthropic, configurar uma variável de ambiente encaminha o tráfego pelo gateway com rastreamento de custos, auditoria e redação de dados pessoais inclusos.
Modo Sombra
Antes de confiar no cache, o Modo Sombra registra tudo e reporta quanto você teria economizado, sem servir uma única resposta em cache. É a forma honesta de descobrir se seu tráfego se repete o bastante para justificar a mudança. O plano gratuito gira em torno disso, sem cartão de crédito.
Implantação auto-hospedada no seu próprio tenant
Instalar pelo Vercel Marketplace implanta o proxy na sua própria conta da Vercel, apoiada pelo seu Neon Postgres, Upstash Redis e Upstash Vector. Prompts, respostas, embeddings e o conteúdo do cache nunca saem do seu tenant; apenas a licença, a validação da chave de API e um sinal de saúde chegam ao plano de controle do SemanticGuard.
Observabilidade e controles por tenant
O painel cobre análise de custos e rastreamento por requisição, com um endpoint Prometheus para equipes que enviam métricas para a própria stack. Cada tenant tem seu próprio interruptor de corte e log de auditoria.
Prós e contras
Prós
- Financia o próprio custo cortando o gasto com LLM que elimina, em vez de adicionar uma linha separada.
- O cache entre provedores é de fato incomum; os caches nativos da OpenAI e da Anthropic ficam cada um dentro dos próprios modelos.
- A governança chega com uma variável de ambiente ou um wrapper fetch, então adotá-la não exige reescrever o agente.
- A opção auto-hospedada mantém prompts, respostas e embeddings dentro da sua própria VPC.
- A validação de correção com amostragem julgada por IA aborda o principal medo que as pessoas têm do cache semântico.
Contras
- A economia depende de o seu tráfego se repetir; prompts únicos sem sobreposição mostrarão pouco benefício, então o Modo Sombra é um primeiro passo obrigatório.
- O plano Enterprise é cobrado a 15% da economia documentada com um piso de $500/mês, algo mais difícil de prever do que uma tarifa fixa.
- Algumas peças de governança, como a caixa de aprovação com humano no loop e o proxy da camada MCP, ainda estão no roadmap.
- As 10K requisições/mês do plano gratuito acabam rápido para equipes que testam em volume real.
Perguntas frequentes
É um gateway de IA com duas metades. Uma faz cache das respostas de LLM para cortar o custo da API, e a outra audita e controla as chamadas de ferramenta que seus agentes fazem. Você encaminha seu tráfego de LLM atual por ele e as duas funções rodam sobre as mesmas requisições.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a SemanticGuard.
Alternativas a SemanticGuard
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.