

Serpex.dev
Serpex.dev · Programação
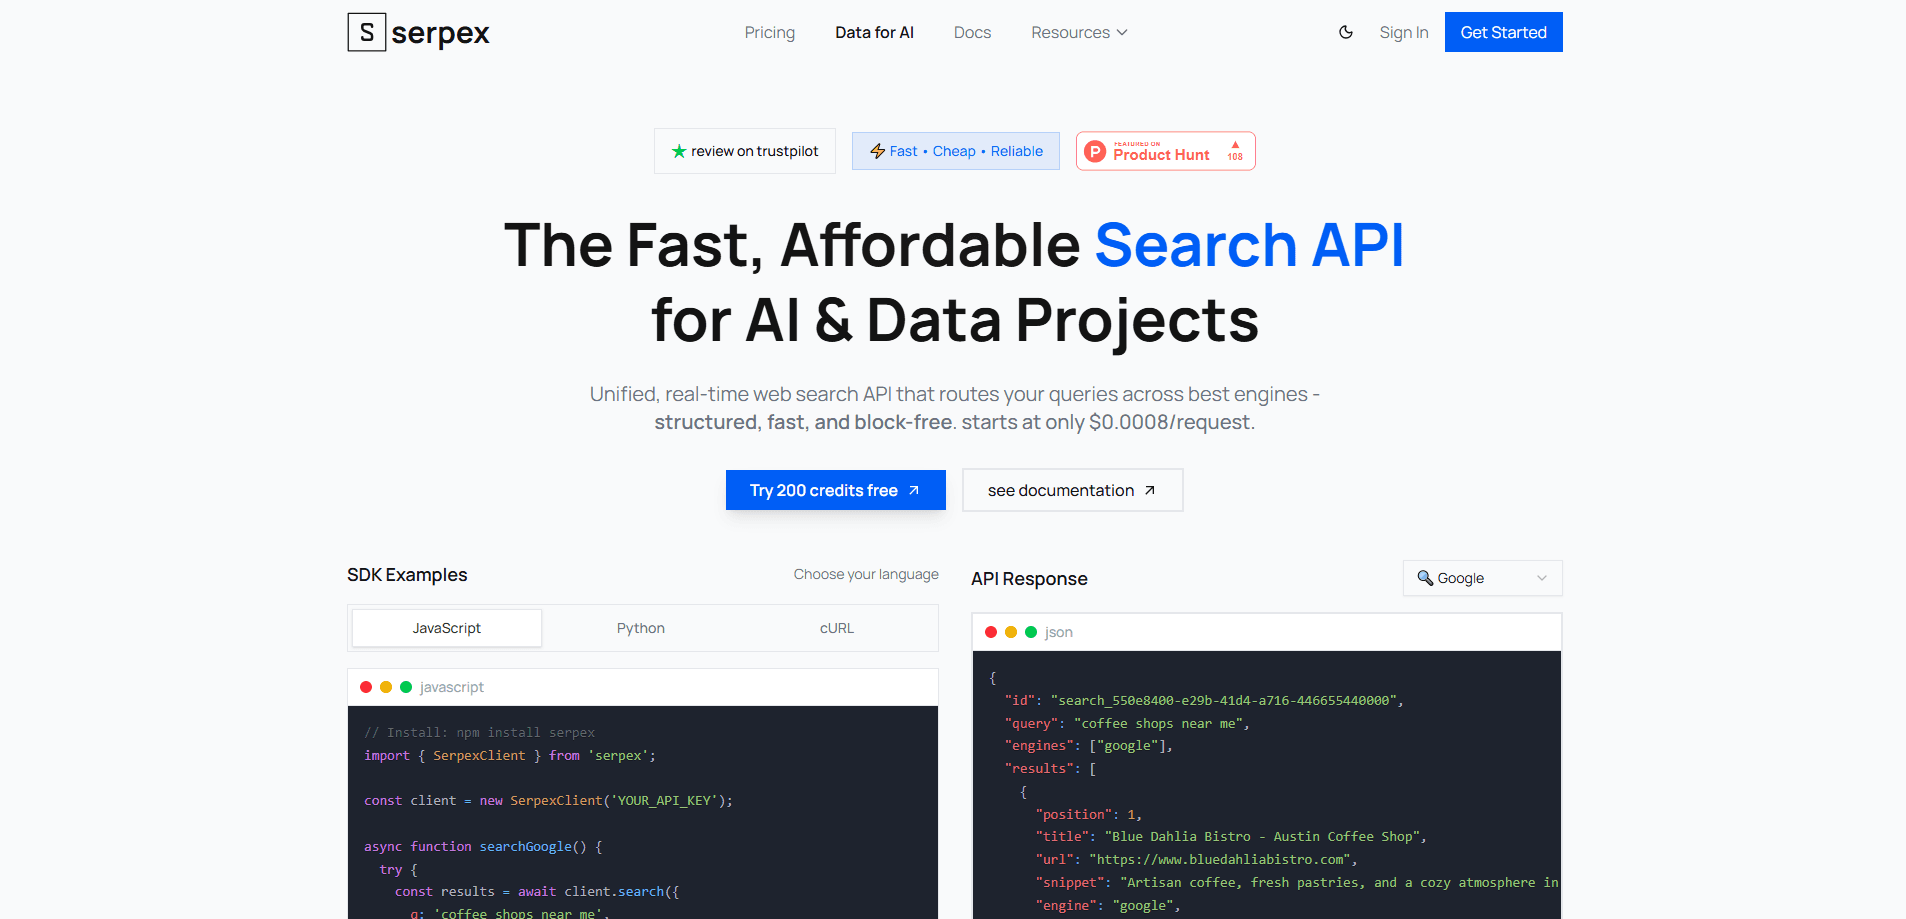
O Serpex.dev é uma API de busca e extração voltada a desenvolvedores. Devolve resultados web estruturados e o conteúdo limpo de uma página em uma única chamada. É feita para agentes de IA, pipelines RAG e projetos de dados que precisam de informação web fresca sem manter os próprios navegadores ou scrapers. As requisições começam em cerca de $0.0008 cada, e você só paga pelas chamadas bem-sucedidas.
Sobre Serpex.dev
O que é o Serpex.dev
O Serpex.dev é uma API de busca na web para quem conecta dados vivos da internet dentro do software. Você envia uma consulta e recebe resultados classificados em JSON: títulos, URLs, trechos, posições e o motor que respondeu. Envia uma lista de URLs e recupera o conteúdo dessas páginas em Markdown ou HTML, já limpo.
O serviço existe porque basear um sistema de IA em dados de treinamento velhos é uma batalha perdida. Se você constrói um agente que precisa dos preços de hoje, ou uma configuração de ingestão RAG que deve citar o que a web realmente diz, fazer essa raspagem por conta própria é um trabalho que nunca termina. E o que isso significa para quem conecta tudo? Que o navegador, o pool de proxies e a lógica de retentativa que você teria que escrever e manter ficam atrás do endpoint de outra pessoa, e o seu trabalho se resume a formatar uma consulta e ler uma lista JSON de volta.
O limite principal está no escopo. Isso é infraestrutura para desenvolvedores, não um painel para busca casual. Você precisa de uma chave de API, algum código e uma noção de quantas requisições o seu app vai disparar. A extração também tem teto de 10 URLs por requisição, então rastreamentos massivos precisam de lotes. Páginas com proteção anti-bot pesada ainda podem falhar. Requisições stealth que falham são grátis, então uma página bloqueada não consome o seu saldo.
Como começar
- Cadastre-se em app.serpex.dev e resgate os 200 créditos grátis que vêm com uma conta nova.
- Gere uma chave de API no painel e guarde-a como
sk_...no seu servidor, nunca no código do cliente. - Envie sua primeira requisição com um POST para
https://api.serpex.dev/api/search, passando uma consulta como{"q": "openai gpt-4o"}e o seu token Bearer no cabeçalho. - Para o conteúdo de uma página, chame
POST /api/crawlcom uma lista de URLs, e adicione"stealth": truese um site bloquear requisições normais. - Leia a resposta JSON e depois conecte os resultados ao seu agente, banco de dados vetorial ou pipeline de relatórios.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Serpex.dev.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores de IA e de backend
- Times de dados que constroem pipelines RAG
- Pesquisadores de SEO e de mercado
Tarefas
- Ancorar respostas de LLM
- Ingestão de conteúdo
- Monitoramento de concorrentes
Cenários
- Você está prototipando um agente de pesquisa e não quer gerenciar proxies nem navegadores headless.
- Você precisa de uma forma barata de rodar milhares de consultas para um trabalho de análise sem contratos empresariais.
- Um site bloqueia a raspagem normal e você precisa de um recurso que contorne a proteção anti-bot.
Principais recursos
Busca e extração unificadas
A maioria das APIs de busca para na página de resultados. O Serpex leva o trabalho um passo adiante. Você pode consultar resultados e depois puxar o conteúdo completo por trás de cada um no mesmo serviço, com a mesma chave e o mesmo saldo. Isso significa uma integração a menos para construir e uma fatura a menos para conciliar no fim do mês. Para um pipeline RAG, essa economia de configuração é real.
Respostas JSON estruturadas
As chamadas de busca devolvem campos de título, URL, trecho, posição e motor em um formato JSON previsível. Chegam como um array simples sobre o qual você pode iterar, filtrar ou armazenar sem escrever uma linha de código para interpretar HTML nem manter um navegador headless vivo nos seus servidores. Essa estrutura é o que permite classificar, filtrar e guardar resultados sem lógica de raspagem improvisada.
Modo stealth para páginas bloqueadas
Alguns sites se defendem do acesso automatizado. Adicionar stealth: true a uma requisição de crawl a encaminha por uma configuração feita para passar pela proteção anti-bot pesada, cobrada a cinco créditos por URL. Requisições stealth que falham não custam nada, então uma página bloqueada não esvazia o seu saldo. Pense nisso como uma API de scraping web com um interruptor de contorno para os sites teimosos.
Roteamento multi-motor
Uma camada de roteamento automático escolhe o motor para cada consulta em vez de obrigar você a escolher um por chamada. Os resultados voltam marcados com o motor que respondeu. Essa marca ajuda quando você quer comparar como fontes diferentes classificam a mesma consulta.
Modelo de créditos compatível com cripto
Os créditos nunca expiram, e você pode comprá-los conforme o uso ou em um pacote único. Sem assinatura que prende. Uma requisição que falha não é cobrada, e o nível grátis começa com 200 créditos, uma forma de baixo atrito de testar o serviço antes de se comprometer.
Níveis de preço acessíveis
O preço da API de busca cai conforme o volume cresce: cerca de $0.80 por 1,000 requisições no Starter, $0.65 no Standard e $0.50 no Scale. A extração stealth roda a cerca de $4.00, $3.25 e $2.50 por 1,000 conforme o nível. Esse é o argumento principal, e ele se sustenta bem frente a opções de API SERP mais caras do mercado.
Rede global de proxies e concorrência
Cada nível roda sobre uma rede global de proxies com 99.7% de disponibilidade e proteção contra limites de taxa. A concorrência cresce com o seu plano, então você pode rodar 10 requisições paralelas no Starter, 50 no Standard e até 100 no Scale, com tetos personalizados para contas empresariais que precisam de milhares de chamadas em voo ao mesmo tempo.
Análise e suporte
O painel reporta análise de uso detalhada para você ver para onde vão os créditos, e o suporte atende o dia todo por chat e e-mail. Para um serviço cobrado por requisição, saber exatamente o que consumiu o seu saldo importa.
Prós e contras
Prós
- A busca e a extração de páginas vivem em uma só API, então você pula um segundo fornecedor de raspagem.
- O preço por requisição de cerca de $0.0008 mantém baratos os grandes volumes de consultas.
- Requisições stealth que falham são grátis, o que suaviza o custo das páginas bloqueadas.
- Os créditos nunca expiram e não há assinatura que prende.
- 200 créditos grátis tornam fácil testar antes de pagar.
Contras
- Não há painel no navegador para busca casual. Você precisa de código e de uma chave de API para usar.
- As requisições de crawl têm teto de 10 URLs, então trabalhos grandes precisam de lotes.
- O modo stealth custa cinco vezes a tarifa normal, e isso se acumula em sites protegidos.
Perguntas frequentes
O Serpex.dev dá aos desenvolvedores uma forma rápida de levar resultados de busca na web ao vivo e conteúdo de páginas para dentro de uma aplicação. É mais comum em agentes de IA, pipelines RAG e projetos de dados que precisam de informação atual em vez do conhecimento embutido de um modelo.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Serpex.dev.
Alternativas a Serpex.dev

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.