
Soup CLI
MePlay, Inc. · Programação
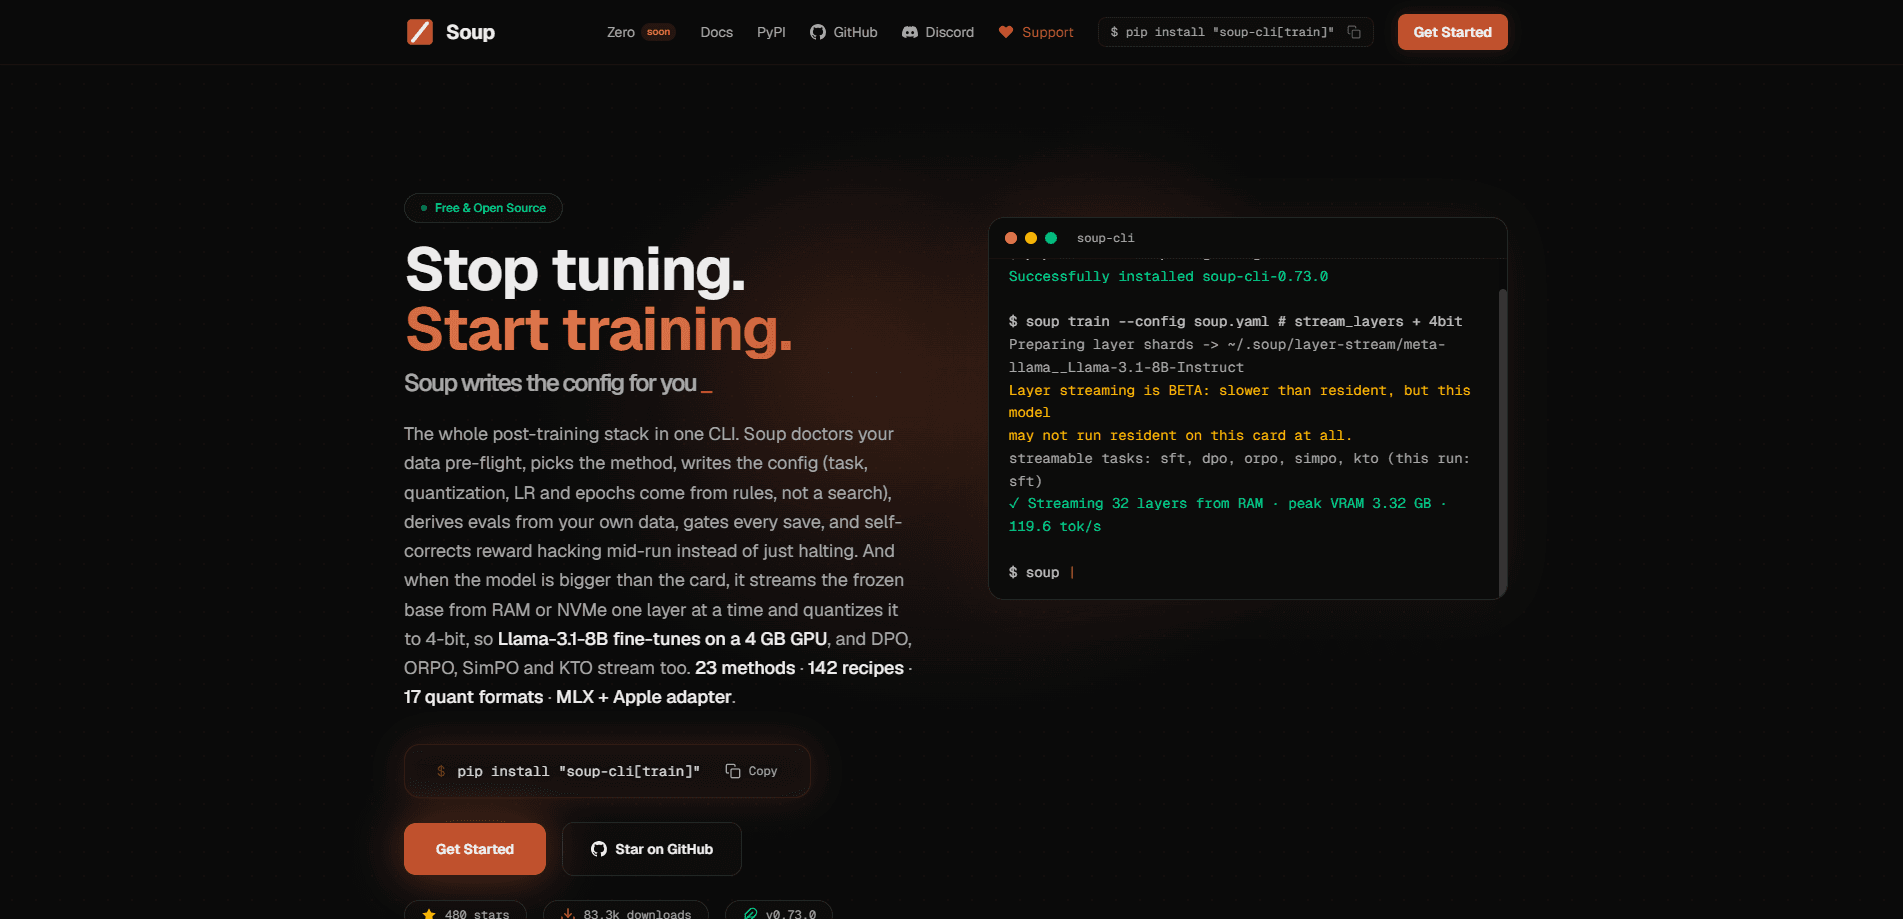
O Soup CLI é uma ferramenta de linha de comando de código aberto para ajuste fino e pós-treinamento de grandes modelos de linguagem. Como ferramenta de ajuste fino de LLM, transforma o trabalho de configuração habitual em um único fluxo: você escreve um arquivo YAML, roda `soup train`, e o Soup cuida sozinho da detecção da GPU, do tamanho do lote e da quantização. O projeto é feito para quem quer ajustar modelos localmente em vez de alugar GPUs na nuvem ou brigar com scripts de treinamento, e seu recurso principal, o streaming de camadas, permite treinar um modelo de 8B na GPU de um notebook com apenas 4 GB de VRAM.
Sobre Soup CLI
O que é o Soup CLI
O Soup CLI (também publicado como o pacote Python soup-cli) é uma pilha centrada em linha de comando que cobre todo o ciclo de pós-treinamento: limpeza de dados, escolha de método, geração de configuração, avaliação e filtragem de checkpoints. É mantido pela MePlay, Inc. e lançado sob a licença Apache-2.0, então você pode ler o código, fazer um fork ou integrá-lo ao seu próprio pipeline.
O principal problema que ele resolve é o atrito. Quem já treinou um modelo conhece o ritual: escolher o hardware, lutar com conflitos de dependência, adivinhar o tamanho do lote e depurar uma falha no passo 400. O Soup comprime tudo isso em um arquivo de configuração que ele mesmo escreve para você. Por que isso importa? Porque a configuração inicial, e não o treinamento em si, é onde a maioria dos ajustes de iniciante morre. Ele é voltado a desenvolvedores, pesquisadores e equipes pequenas que querem um ajuste funcional sem se tornarem engenheiros de infraestrutura.
A maior limitação é o hardware. O treinamento ainda exige uma GPU CUDA, e rodar um trabalho real de 7B a 8B em uma máquina comum significa aceitar QLoRA e pesos quantizados em vez de treinamento em precisão total. Essa é a troca. O streaming de camadas, o recurso que torna viáveis as GPUs pequenas, ainda está marcado como BETA e precisa ser ativado à mão.
Como começar
- Instale o pacote. Use
pipx install "soup-cli[train]"ouuv tool install "soup-cli[train]". A instalação simples desoup-clié uma CLI leve sem PyTorch, então você precisa do extra[train]para ajustar. - Gere uma configuração. Rode
soup init --template chatpara criar umsoup.yamlinicial para um ajuste no estilo chat. - Aponte para seus dados e o modelo base. Edite o YAML para definir o caminho do seu conjunto de dados e o modelo que você quer adaptar.
- Comece o treinamento. Rode
soup traine deixe que ele detecte sua GPU e escolha as configurações. Para modelos grandes em placas pequenas, definastream_layers: trueantes. - Sirva ou exporte o resultado. Use
soup servepara expor o modelo ajustado atrás de um endpoint de API compatível com OpenAI.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Soup CLI.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores individuais e entusiastas
- Engenheiros de ML e pesquisadores
- Startups pequenas
Tarefas
- Ajuste supervisionado
- Otimização de preferências
- Experimentação local
Cenários
- Fluxo só com notebook
- Ajuste privado
- Transformar um modelo ajustado em serviço
Principais recursos
Uma configuração, um comando
A ideia central é que um único arquivo YAML descreve todo o trabalho. Você roda soup init para gerar uma configuração inicial, edita alguns campos e então roda soup train. O Soup lê a configuração, verifica sua GPU e escolhe um tamanho de lote e uma quantização que cabem. Para quem já manteve uma pasta de scripts de treinamento em shell, esse é o atrativo: a configuração é a documentação.
Streaming de camadas para GPUs pequenas
O streaming de camadas é o recurso que recebe mais atenção. Em vez de carregar todo o modelo base congelado na VRAM, o Soup o mantém fora da memória e alimenta a GPU com uma camada decodificadora por vez. Em uma RTX 3050 Laptop com 4 GB, o projeto relata um modelo de 8B rodando com 3,32 GB de memória de pico. Um resultado e tanto. O porém é que é opcional e ainda está em BETA, e os números de vazão vêm de uma versão antiga específica, então trate a velocidade como um piso e não como uma promessa.
Avaliação integrada e filtragem de checkpoints
O Soup não para no treinamento. Ele deriva avaliações da sua configuração e filtra os checkpoints contra elas, então uma execução que regride é sinalizada em vez de salva em silêncio. Para equipes que treinam com frequência, isso importa mais do que a velocidade bruta. Você quer um pipeline que avise quando um checkpoint é pior que o anterior.
Serviço compatível com OpenAI
O comando soup serve transforma um modelo treinado em um serviço de API com um único comando. Ele expõe os endpoints padrão /v1/chat/completions, /v1/models e /health, aceita respostas em streaming e pode mudar para backends vLLM ou SGLang para maior vazão. Adaptadores LoRA podem ser servidos direto, com o modelo base resolvido a partir da configuração do adaptador, então você não precisa fundir os pesos à mão antes.
Local em primeiro lugar, sem nuvem
Tudo é pensado para rodar no hardware que você já tem. Sem necessidade de nuvem. Não há conta obrigatória, nem painel hospedado, nem dados saindo da sua máquina a menos que você configure isso. Para equipes que lidam com dados sensíveis, esse costuma ser o fator decisivo em relação a um serviço de treinamento gerenciado.
Ferramentas de dados e comandos de inspeção
A instalação leve de soup-cli já inclui soup data ... e comandos de inspeção que funcionam sem PyTorch. Isso significa que você pode limpar e inspecionar seu conjunto de dados em uma máquina sem GPU nenhuma. Prepare agora, treine depois.
Prós e contras
Prós
- Código aberto sob Apache-2.0, então não há dependência de fornecedor e o código é totalmente auditável.
- Um único arquivo YAML de configuração substitui quase todo o scripting e a configuração inicial que o ajuste costuma exigir.
- O streaming de camadas torna modelos realmente grandes treináveis em GPUs pequenas de consumidor.
- O serviço e a avaliação fazem parte da mesma ferramenta, não são utilitários separados que você precisa conectar.
- Funciona totalmente offline, o que mantém dados e pesos no seu próprio hardware.
Contras
- O streaming de camadas, o recurso de destaque, ainda está em BETA e precisa ser ativado à mão, então não é uma opção de configurar e esquecer.
- O melhor desempenho pressupõe uma GPU CUDA; o suporte a Apple Silicon e CPU é experimental e lento.
- A instalação dividida pode confundir os novatos, já que um simples `pip install soup-cli` não deixa você treinar até adicionar o extra `[train]`.
- A documentação é densa e específica de cada versão, então dicas de guias antigos podem não corresponder à versão atual.
Perguntas frequentes
É uma ferramenta de linha de comando de código aberto para ajuste fino e pós-treinamento de grandes modelos de linguagem. Você define um trabalho em um arquivo YAML e roda soup train, e ele cuida da detecção da GPU, da quantização e do lote para você.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Soup CLI.
Alternativas a Soup CLI

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.