
TraceLLM
TraceLLM · Programação
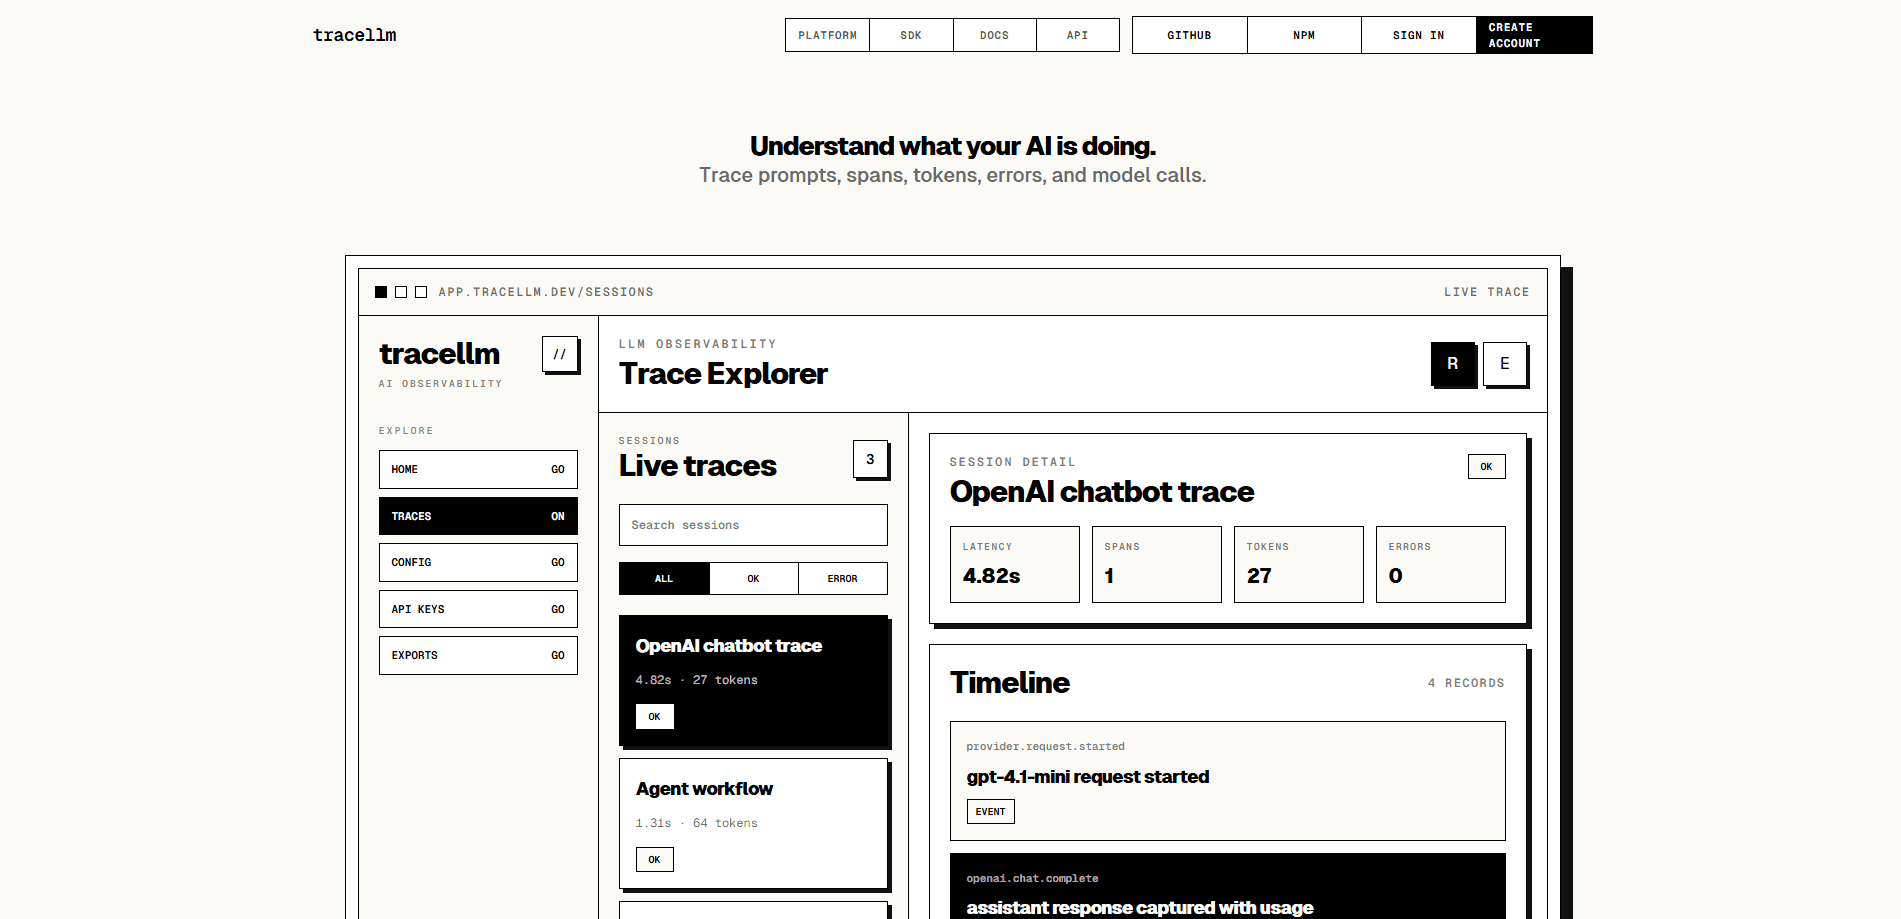
O TraceLLM é uma plataforma de observabilidade de LLM com foco local para equipes que rodam aplicações de IA em produção. Ele registra sessões, spans, prompts e saídas (quando você permite), uso de tokens, latência e erros em chatbots, agentes e pipelines RAG, e depois mostra tudo em uma única linha do tempo. Uma camada de políticas decide o que é capturado, mascarado ou descartado, e um caminho de exportação OpenTelemetry encaminha as traças selecionadas para backends como SigNoz ou Honeycomb. E o que isso te dá? Um só lugar para responder por que uma resposta saiu errada.
Sobre TraceLLM
O que é o TraceLLM
O TraceLLM é uma plataforma de observabilidade feita especificamente para aplicações de IA. Em vez de espalhar pistas entre painéis de provedores, logs do app e relatos de bugs dos usuários, ele dá a cada fluxo de IA uma única linha do tempo: o que o acionou, qual chamada ao modelo rodou, quanto durou cada passo, quantos tokens consumiu e onde falhou.
O projeto é de código aberto sob a licença MIT, com o código no GitHub e o app hospedado em tracellm.in. Ele nasceu de um problema comum: uma resposta errada aparece em produção, mas o código do app, o armazenamento vetorial e o provedor do modelo guardam apenas fragmentos da história. O TraceLLM costura esses fragmentos em um único registro inspecionável.
O principal limite é a maturidade. O TraceLLM é jovem. O SDK de Node é um pacote de workspace em vez de uma versão publicada no npm, e a documentação ainda aponta para um guia local de configuração. Se você precisa de uma ferramenta testada em batalha com uma grande galeria de integrações, esta ainda não é. Se você quer ler o código e hospedá-lo sozinho, o encaixe é bom.
Primeiros passos
- Crie uma conta em tracellm.in ou rode o stack localmente com
pnpm install,pnpm infra:buildepnpm infra:up. - Crie um projeto e copie a chave de API do projeto (
trllm_...). - Instale o SDK de Node no seu app e inicie uma sessão com o seu endpoint, a chave de API e o nome do serviço.
- Envolva suas chamadas ao modelo em spans e registre eventos, contagens de tokens e erros conforme avança.
- Abra o Explorador de traças para inspecionar cada sessão e, opcionalmente, adicione um endpoint OTLP para encaminhar as traças ao seu próprio backend.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de TraceLLM.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de IA e desenvolvedores de backend
- Equipes de produto pequenas sem orçamento de plataforma
- Equipe de suporte focada em depuração
Tarefas
- Rastrear uma resposta ruim de chatbot
- Acompanhar o gasto com tokens
- Manter os erros ligados a sessões reais
- Exportar para um APM existente
Cenários
- Lançar um agente em produção e precisar de um jeito de reproduzir uma conversa que falhou
- Trabalhar sob regras de conteúdo em que os prompts contêm dados pessoais
- Padronizar a observabilidade em vários serviços de IA
Principais recursos
Rastreamento de sessões e spans
O TraceLLM organiza um fluxo de IA como uma sessão com spans aninhados. Uma sessão contém o turno do usuário. Cada span cobre uma unidade de trabalho, como uma chamada a um provedor, um passo de recuperação ou a execução de uma ferramenta. Esse é o núcleo do rastreamento de LLM. Você inicia uma sessão, abre spans dentro dela, registra eventos conforme acontecem e fecha os dois com um status. A estrutura transforma uma pilha solta de linhas de log em uma execução reproduzível.
Controles de política de captura
Nem tudo deveria ser armazenado. Você define a política por projeto: se o conteúdo de prompts e saídas é capturado, quantos metadados e uso são mantidos e se o mascaramento oculta chaves de API e tokens bearer antes de chegarem ao banco de dados. É aqui que o rastreamento de prompts ganha suas proteções. A amostragem pode capturar de 0% a 100% das sessões, e certos tipos de span podem ser totalmente ignorados.
Acompanhamento de uso de tokens e latência
Cada span pode carregar contagens de tokens e tempos junto aos seus atributos. Custo e velocidade ficam na mesma visão que a chamada em si. Você vê qual passo é lento e qual é caro. Sem juntar dois painéis. Essa é a diferença entre saber que a conta subiu e saber qual prompt causou isso.
Exportação OpenTelemetry e OTLP
O TraceLLM mantém sua própria linha do tempo e pode encaminhar traças selecionadas a um coletor OTLP HTTP próprio. Você cola um endpoint, escolhe quais sinais encaminhar e os dados fluem para SigNoz, Honeycomb, Tempo, Datadog ou qualquer backend compatível com OTLP. Equipes que já usam um APM mantêm o stack atual e tratam o TraceLLM como a camada específica de IA por cima.
Instrumentação agnóstica ao provedor
Pense nisso como uma ferramenta de depuração de IA que não te prende a um fornecedor. Os spans não se importam com qual modelo você chama. O TraceLLM funciona com OpenAI, Claude, Gemini, roteadores próprios, serviços internos e fluxos no formato MCP, porque você mesmo envolve a chamada em vez de depender de um plugin específico. Trocar de modelo ou de gateway não quebra sua configuração de rastreamento.
Chaves de API por projeto
Cada chave de API associa as requisições a um projeto e leva a política de captura desse projeto ao runtime do SDK. Crie várias chaves. Dê nomes a elas. Revogue as antigas quando um serviço parar de usá-las. Assim uma política compartilhada não vaza para apps não relacionados, e a rotação de chaves vira uma tarefa simples de dois passos.
Prós e contras
Prós
- Licenciado em MIT e de código aberto, então não há assinatura e o código pode ser lido.
- O design local permite auto-hospedar e manter os dados de traças na sua própria infraestrutura.
- A política de captura separa conteúdo, metadados, uso e erros, o que ajuda com prompts sensíveis.
- A exportação OTLP significa que você não abandona uma configuração existente de SigNoz ou Datadog.
- Os spans agnósticos ao provedor cobrem OpenAI, Claude, Gemini e gateways próprios sem plugins.
Contras
- O SDK de Node ainda não está publicado no npm, então os primeiros usuários o instalam pelo repositório ou como pacote de workspace.
- É um projeto jovem, então espere menos integrações prontas e menos exemplos da comunidade do que as ferramentas maduras oferecem.
- A auto-hospedagem significa que você cuida do deploy, das atualizações e do dimensionamento do armazenamento.
- A documentação ainda está sendo completada, então alguns passos de configuração exigem ler o código-fonte.
Perguntas frequentes
O TraceLLM serve para depurar e monitorar aplicações de IA em produção. Ele registra sessões, spans, uso de tokens, latência e erros de chatbots, agentes e pipelines RAG, e depois os mostra em uma única linha do tempo para que você encontre por que uma resposta específica saiu errada.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a TraceLLM.
Alternativas a TraceLLM
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.