

Unbody
Unbody (Unbody Labs) · Programação · Outros
O Unbody é um backend nativo de IA que ingere, enriquece e vetoriza conteúdo e o entrega por uma única API GraphQL para busca semântica, chatbots e respostas geradas.
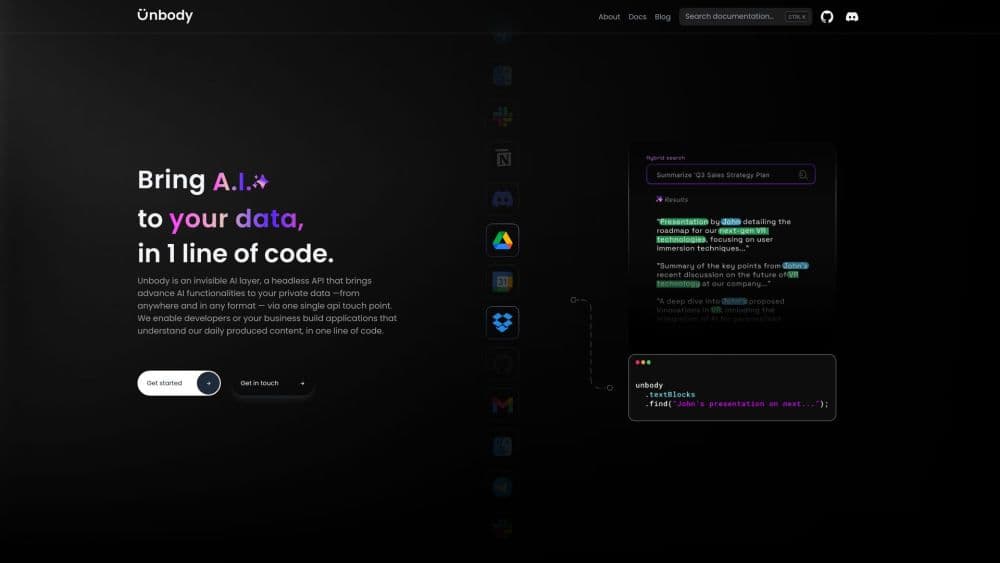
Sobre Unbody
About
O que é o Unbody
O Unbody é um backend para equipes que querem recursos de IA sem montar a infraestrutura com as próprias mãos. Você conecta uma fonte de dados, escolhe algumas etapas de enriquecimento e consulta o resultado em um único endpoint GraphQL. A proposta era um backend RAG e backend para chatbots na mesma caixa: sem banco de dados vetorial, serviço de embeddings, camada sobre o LLM e fila de tarefas para manter em sincronia.
A arquitetura se divide em quatro camadas. Percepção cuida da ingestão, do parsing, do enriquecimento e da vetorização. Memória guarda os objetos e os vetores resultantes. Raciocínio executa as chamadas de modelo e as prompts. Ação expõe tudo por APIs e SDKs. Os conectores prontos cobrem Google Drive, Discord e GitHub, e a API Push aceita qualquer outra fonte com um schema definido por você. Os enriquecedores acrescentam resumos, palavras-chave, legendas de imagem, texto de OCR e páginas rastreadas antes da indexação.
Um ponto pesa mais que qualquer recurso: o Unbody não está mais em desenvolvimento. O repositório no GitHub está arquivado, o aplicativo hospedado em app.unbody.io não carrega e o domínio da documentação retorna erro. A Unbody Labs trabalha agora no Adapt, um framework de memória separado. Esta página serve como registro do que a plataforma oferecia e como guia do código arquivado, caso você queira rodá-lo por conta própria. O código está em nível alfa e ninguém publica correções.
Como começar
- Instale Node.js 20 ou 22, Docker, Docker Compose e yarn. Clone o repositório unbody-io/unbody e rode yarn para baixar as dependências.
- Copie .env.example para .env.local e informe uma chave de API da OpenAI. Essa chave alimenta os embeddings e os endpoints generativos.
- Suba os serviços de apoio com docker compose up e depois execute yarn start. As tarefas de indexação passam pelo Temporal, cujo painel fica na porta 8233.
- Crie um projeto e adicione uma fonte com o comando unbody-cli source add. Em seguida dá para acompanhar os primeiros arquivos passando por parsing, enriquecimento e vetorização.
- Consulte o projeto pela API GraphQL ou pelo SDK de TypeScript. O SDK envolve as chamadas de recuperação, busca e geração em um cliente encadeável.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Unbody.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores de backend que colocam busca ou chat em um produto existente
- Equipes de produto pequenas sem engenheiro de machine learning
- Equipes cujo conteúdo já está no Google Drive, no Discord ou no GitHub
Tarefas
- Transformar um arquivo de documentos em uma base de conhecimento pesquisável
- Adicionar um chatbot de documentação a um site
- Resumir e etiquetar conteúdo em lote
- Testar similaridade semântica ou visual
Cenários
- Avaliar um backend nativo de IA antes de construir um em casa
- Manter um projeto antigo funcionando
- Ensinar ou demonstrar um pipeline RAG
Principais recursos
Uma única API GraphQL para o conteúdo
Tudo que a plataforma guarda é consultado em um endpoint GraphQL que funciona como API de base de conhecimento, com filtros, ordenação, paginação e objetos aninhados na mesma consulta. Você pede os campos de que precisa e recebe registros enriquecidos, incluindo resumos e palavras-chave gerados. Endpoints separados de imagem e vídeo cobrem o processamento de mídia, e a API de administração gerencia projetos e fontes sem passar pelo painel.
Conectores prontos e API Push
Google Drive, Discord e GitHub têm integrações já feitas. Cada uma define um ponto de entrada, como uma pasta ou um canal, e depois extrai o conteúdo conforme a agenda. Para o resto existe a API Push, que aceita registros em um schema definido por você e cobre bancos internos, arquivos exportados e feeds próprios. Essa combinação resolvia o começo típico de um produto de conhecimento sem escrever um ETL sob medida.
Pipelines de enriquecimento
Antes da indexação, um pipeline configurável faz o parsing do conteúdo e roda enriquecedores sobre o resultado. O AutoSummary escreve resumos curtos, o AutoKeywords extrai os termos importantes e o AutoVision gera legendas, retira texto com OCR e etiqueta objetos. Os crawlers transformam páginas web em registros estruturados. Os pipelines são montados no painel ou pela API de administração, e plugins próprios podem ser registrados quando o conjunto embutido não basta.
Cinco modos de busca
A API oferece busca semântica, busca por palavra-chave e busca híbrida, além de dois modos de similaridade: similaridade de registros e similaridade visual. A semântica procura por significado, o que ajuda quando as palavras do usuário não batem com o documento. A de palavra-chave continua previsível para termos exatos. A híbrida mistura as duas. A visual trabalha com vetores de imagem, então a foto de um produto encontra parecidos dentro de um catálogo.
Busca generativa e saída JSON
Dois modos de geração ficam sobre a recuperação. O From One dispara um prompt contra cada objeto e pode inserir valores dos campos no texto. O From Many pega um conjunto de objetos e produz um resultado único para todos, útil em resumos e comparações. Um modo separado devolve JSON estruturado validado contra um schema, feito para extrair campos em vez de prosa. O modelo é escolhido por plugin, então o backend não fica preso a um fornecedor.
SDK de TypeScript e peças de interface
O SDK de TypeScript transforma chamadas GraphQL em um cliente encadeável: pegar uma coleção, filtrar, buscar, escolher campos e gerar. Há projetos iniciais para Next.js, Nuxt, NestJS e Express, e a camada de interface inclui componentes prontos para React e Vue. Nada disso prende você a um serviço hospedado, porque o mesmo SDK aponta para uma instância local.
Prós e contras
Prós
- Uma API cobre ingestão, enriquecimento, vetorização, busca e geração, o que elimina uma pilha de serviços separados.
- O código é público sob Apache 2.0, então dá para ler a implementação, criar um fork e rodar no seu próprio hardware.
- Os conectores de Google Drive, Discord e GitHub reduzem a primeira demonstração funcional a uma tarde.
- O enriquecimento acontece dentro do pipeline, então resumos, palavras-chave e etiquetas de imagem existem antes da primeira consulta.
- O SDK de TypeScript e os projetos iniciais diminuem a quantidade de GraphQL escrita à mão.
Contras
- O repositório está arquivado e o aplicativo hospedado saiu do ar. Não há patches de segurança, correções de bugs nem canal de suporte.
- O site de documentação não resolve mais, então os detalhes de instalação saem do código, do README e de posts antigos do blog.
- Era software alfa: as APIs mudavam entre versões e alguns plugins ficaram pela metade.
- A auto-hospedagem exige Docker, Node, um worker do Temporal e uma chave da OpenAI, além de paciência para depurar uma pilha que ninguém mantém.
Perguntas frequentes
O Unbody era um backend para recursos de IA. Ele puxava conteúdo de fontes como Google Drive e Discord, enriquecia com resumos e metadados, guardava vetores e entregava o resultado por uma API GraphQL. As equipes usavam para busca semântica, chatbots de documentos e respostas geradas.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Unbody.
Alternativas a Unbody

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Google EmbeddingGemma 2
Google DeepMind · Escrita · Imagem · ProgramaçãoGoogle EmbeddingGemma 2 é um modelo aberto de 740 milhões de parâmetros que transforma texto, código, imagens, áudio e quadros de vídeo em vetores de um único espaço de 768 dimensões, rodando em celulares e notebooks.

GitGlow
GitGlow · Programação · ProdutividadeO GitGlow é um cliente Git de desktop que coloca seu código e as mudanças dos seus agentes de IA na mesma revisão, para você saber o que vai sair da máquina antes de publicar.