
Unreal Speech
Unreal Speech · Voz e linguagem
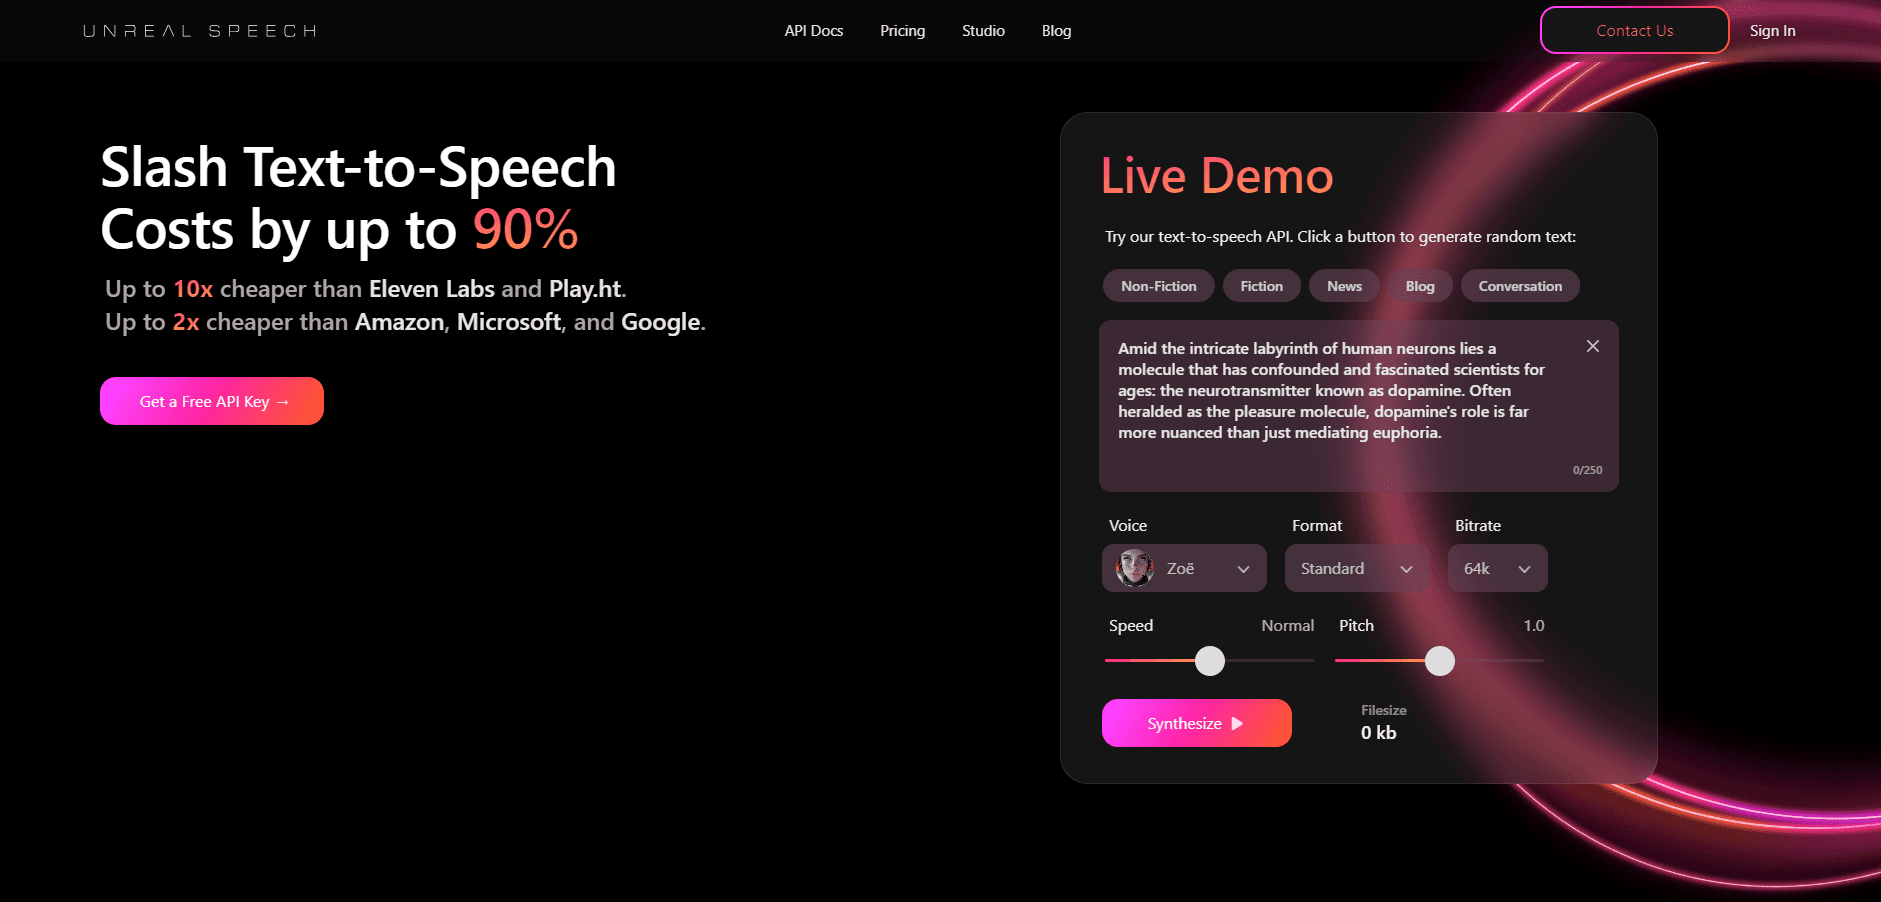
Unreal Speech é uma API de texto para fala que transforma texto escrito em vozes naturais de IA, entrega o áudio em cerca de 300ms e traz marcações de tempo por palavra a uma fração do preço das APIs de voz comuns.
Sobre Unreal Speech
About
O que é o Unreal Speech
O Unreal Speech é uma API de texto para fala feita para quem precisa colocar voz num app sem pagar os preços da IA de voz de alto padrão. Você envia texto para um endpoint e recebe áudio falado com uma chamada REST simples ou uma conexão websocket em streaming. A empresa apresenta o serviço como uma API de síntese de voz que custa cerca de 11 vezes menos que o ElevenLabs e mantém a saída de voz bem próxima da humana. Quem compara ferramentas de voz costuma buscar uma alternativa ao ElevenLabs mais barata, e é no preço que esta se destaca.
O trabalho principal é gerar voz em escala. Além do áudio puro, o Unreal Speech devolve marcações de tempo por palavra que marcam o início e o fim de cada termo, exatamente o que você precisa para legendas, destaque no estilo karaokê e vídeo com texto sincronizado. Ele também encara trabalhos longos: uma única requisição cobre até 10 horas de áudio pelo endpoint de tarefas assíncronas, então audiolivros e narração longa não travam por tempo de espera.
Os limites vale conhecer. O plano grátis cobre uma cota fixa de caracteres por mês, então projetos em produção migram para um plano pago ou uma cobrança por uso. O catálogo de vozes é menor que o dos grandes provedores de nuvem, e a qualidade depende da voz e do modelo escolhidos. Também é um produto que vive na API: não há um estúdio para editar a narração à mão, então quem não programa precisa de outra ferramenta para conduzir.
Como começar
- Pegue uma chave de API grátis no site do Unreal Speech, sem cartão para começar.
- Envie uma requisição POST para o endpoint /stream ou /speech com seu texto, um VoiceId e ajustes como bitrate, velocidade e tom.
- Escolha um codec como libmp3lame ou pcm_mulaw e ajuste tom e velocidade para moldar a voz.
- Para textos longos, mude para o endpoint /synthesisTasks e consulte até o áudio e as marcações ficarem prontos.
- Salve o MP3 devolvido, ou ligue as marcações a uma camada de legenda ou de destaque no seu app.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Unreal Speech.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores de apps e backend
- Estúdios pequenos e criadores individuais
- Equipes de conteúdo que produzem áudio com frequência
Tarefas
- Gerar narração para vídeo
- Transformar documentos longos em audiolivros
- Adicionar voz a um app ou bot
Cenários
- Lançar recursos de voz com orçamento de startup
- Criar uma ferramenta de leitura ou acessibilidade
- Localizar a narração para alcançar mais gente
Principais recursos
Áudio em streaming em cerca de 300ms
O endpoint /stream devolve o áudio rápido, e a empresa aponta uma resposta de cerca de 300ms. É o caminho central de TTS em streaming, e o que se procura quando a latência importa: o áudio chega como dados em streaming, não como um arquivo que exige esperar tudo. Em assistentes, jogos e interfaces ao vivo, essa diferença é o que decide se a conversa parece fluida ou quebrada.
Marcações de tempo por palavra
O Unreal Speech devolve dados de tempo que marcam o início e o fim de cada palavra, entregues como JSON ao lado do áudio. Isso sustenta legendas, destaque no estilo karaokê e texto que segue a voz com exatidão. Uma rota websocket mais nova emite áudio e marcações juntos, então a camada de destaque atualiza em tempo real sem esperar o clipe inteiro.
Síntese de formato longo até 10 horas
O endpoint /synthesisTasks encara trabalhos grandes numa só requisição, e a empresa cita suporte a até 10 horas de áudio. Combina com audiolivros, cursos longos e relatórios completos que, de outro modo, precisariam ser fatiados e remendados. Você envia o texto, consulta a tarefa e busca o áudio pronto junto com o arquivo de marcações quando termina.
Vozes naturais com controle de velocidade e tom
Cada requisição recebe um VoiceId e valores de velocidade, tom e bitrate, então você molda a entrega sem regravar. O bitrate chega a 320k para uma reprodução limpa, e os ajustes de velocidade e tom permitem encaixar um personagem ou um ritmo específico. O catálogo se apoia num conjunto curado de vozes com nome em vez de centenas de opções, o que simplifica a escolha mas reduz a variedade.
Codecs e formatos flexíveis
A API entrega o áudio em codecs como libmp3lame e pcm_mulaw, cobrindo a entrega comum em MP3 e o áudio de telefonia de menor banda. Você ajusta a taxa de amostragem e o bitrate conforme a plataforma de destino, então o mesmo serviço serve para tocar na web e para fluxos de tipo telefone. Essa variedade poupa a conversão entre formatos depois.
API REST e WebSocket simples
O serviço gira em torno de poucos endpoints: /stream para clipes rápidos, /speech para textos médios com URLs de marcações, /synthesisTasks para trabalhos longos e /streamWithTimestamps para áudio e tempo em tempo real. A autenticação é um token bearer comum, e a documentação mostra exemplos em Python, Node e cURL. Essa simplicidade é o motivo de ele entrar num protótipo numa tarde.
Prós e contras
Prós
- O preço é o destaque: como opção de TTS econômico custa várias vezes menos que o ElevenLabs, algo decisivo quando um projeto gera muito volume de voz.
- O plano grátis deixa testar a API com caracteres reais antes de pagar, então você julga a qualidade com o seu próprio roteiro.
- As marcações de tempo por palavra vêm junto com o áudio, o que tira o passo extra de alinhar legendas ou destaques à mão.
- O endpoint de tarefas encara até 10 horas de fala num único trabalho, então audiolivros e relatórios longos não precisam ser partidos.
- Uma rota websocket em streaming começa a soar em cerca de 300ms e mantém ágeis as respostas de voz em tempo real.
Contras
- O catálogo de vozes é menor que o dos grandes provedores de voz na nuvem, então pode faltar algum sotaque ou idioma específico.
- A precisão e o ritmo variam conforme a voz e o modelo, então vale testar uma amostra antes de dedicar todo um projeto a uma só escolha.
- É um produto só de API, sem editor visual, o que obriga quem não programa a usar outra ferramenta para sair com a narração pronta.
- A qualidade nos planos grátis ou com desconto é limitada pelos caracteres mensais, então um uso intenso pode esgotar a cota antes do previsto.
Perguntas frequentes
O Unreal Speech é uma API de texto para fala e API TTS que converte texto escrito em vozes naturais de IA. Os desenvolvedores enviam texto para endpoints REST ou websocket e recebem áudio falado, com marcações de tempo por palavra para legendas e destaque. É feito para equipes que querem recursos de texto para fala com IA sem pagar preços de IA de voz premium.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Unreal Speech.
Alternativas a Unreal Speech

Foley
Hanamori Labs, LLC · Voz e linguagem · Produtividade · Assistente de IAFoley é uma lista de tarefas por voz que transforma uma frase falada em tarefa arquivada, com projeto, data e hora já preenchidos, e depois ajuda você a organizar o dia com o que já está anotado.

HireKey
HireKey · Voz e linguagem · Produtividade · AprendizadoHireKey é um copiloto de busca de emprego com IA criado por uma recrutadora de tecnologia. Avalia aderência à vaga, adapta o currículo, treina entrevistas e organiza cada candidatura.

Fluence
Yay Software (Yannick Huchard) · Escrita · Voz e linguagem · ProdutividadeO Fluence é um app de Android que lê em voz alta PDF, EPUB, arquivos do Word e artigos da web, acompanha a frase falada e responde perguntas sobre o texto sem sair do celular.