
Vectorize
Vectorize · Programação · Aprendizado
O Vectorize é uma plataforma gerenciada de RAG que extrai dados não estruturados de documentos, apps SaaS e bases de conhecimento para o seu próprio banco vetorial, e mantém esse índice atualizado.
Sobre Vectorize
What Is Vectorize
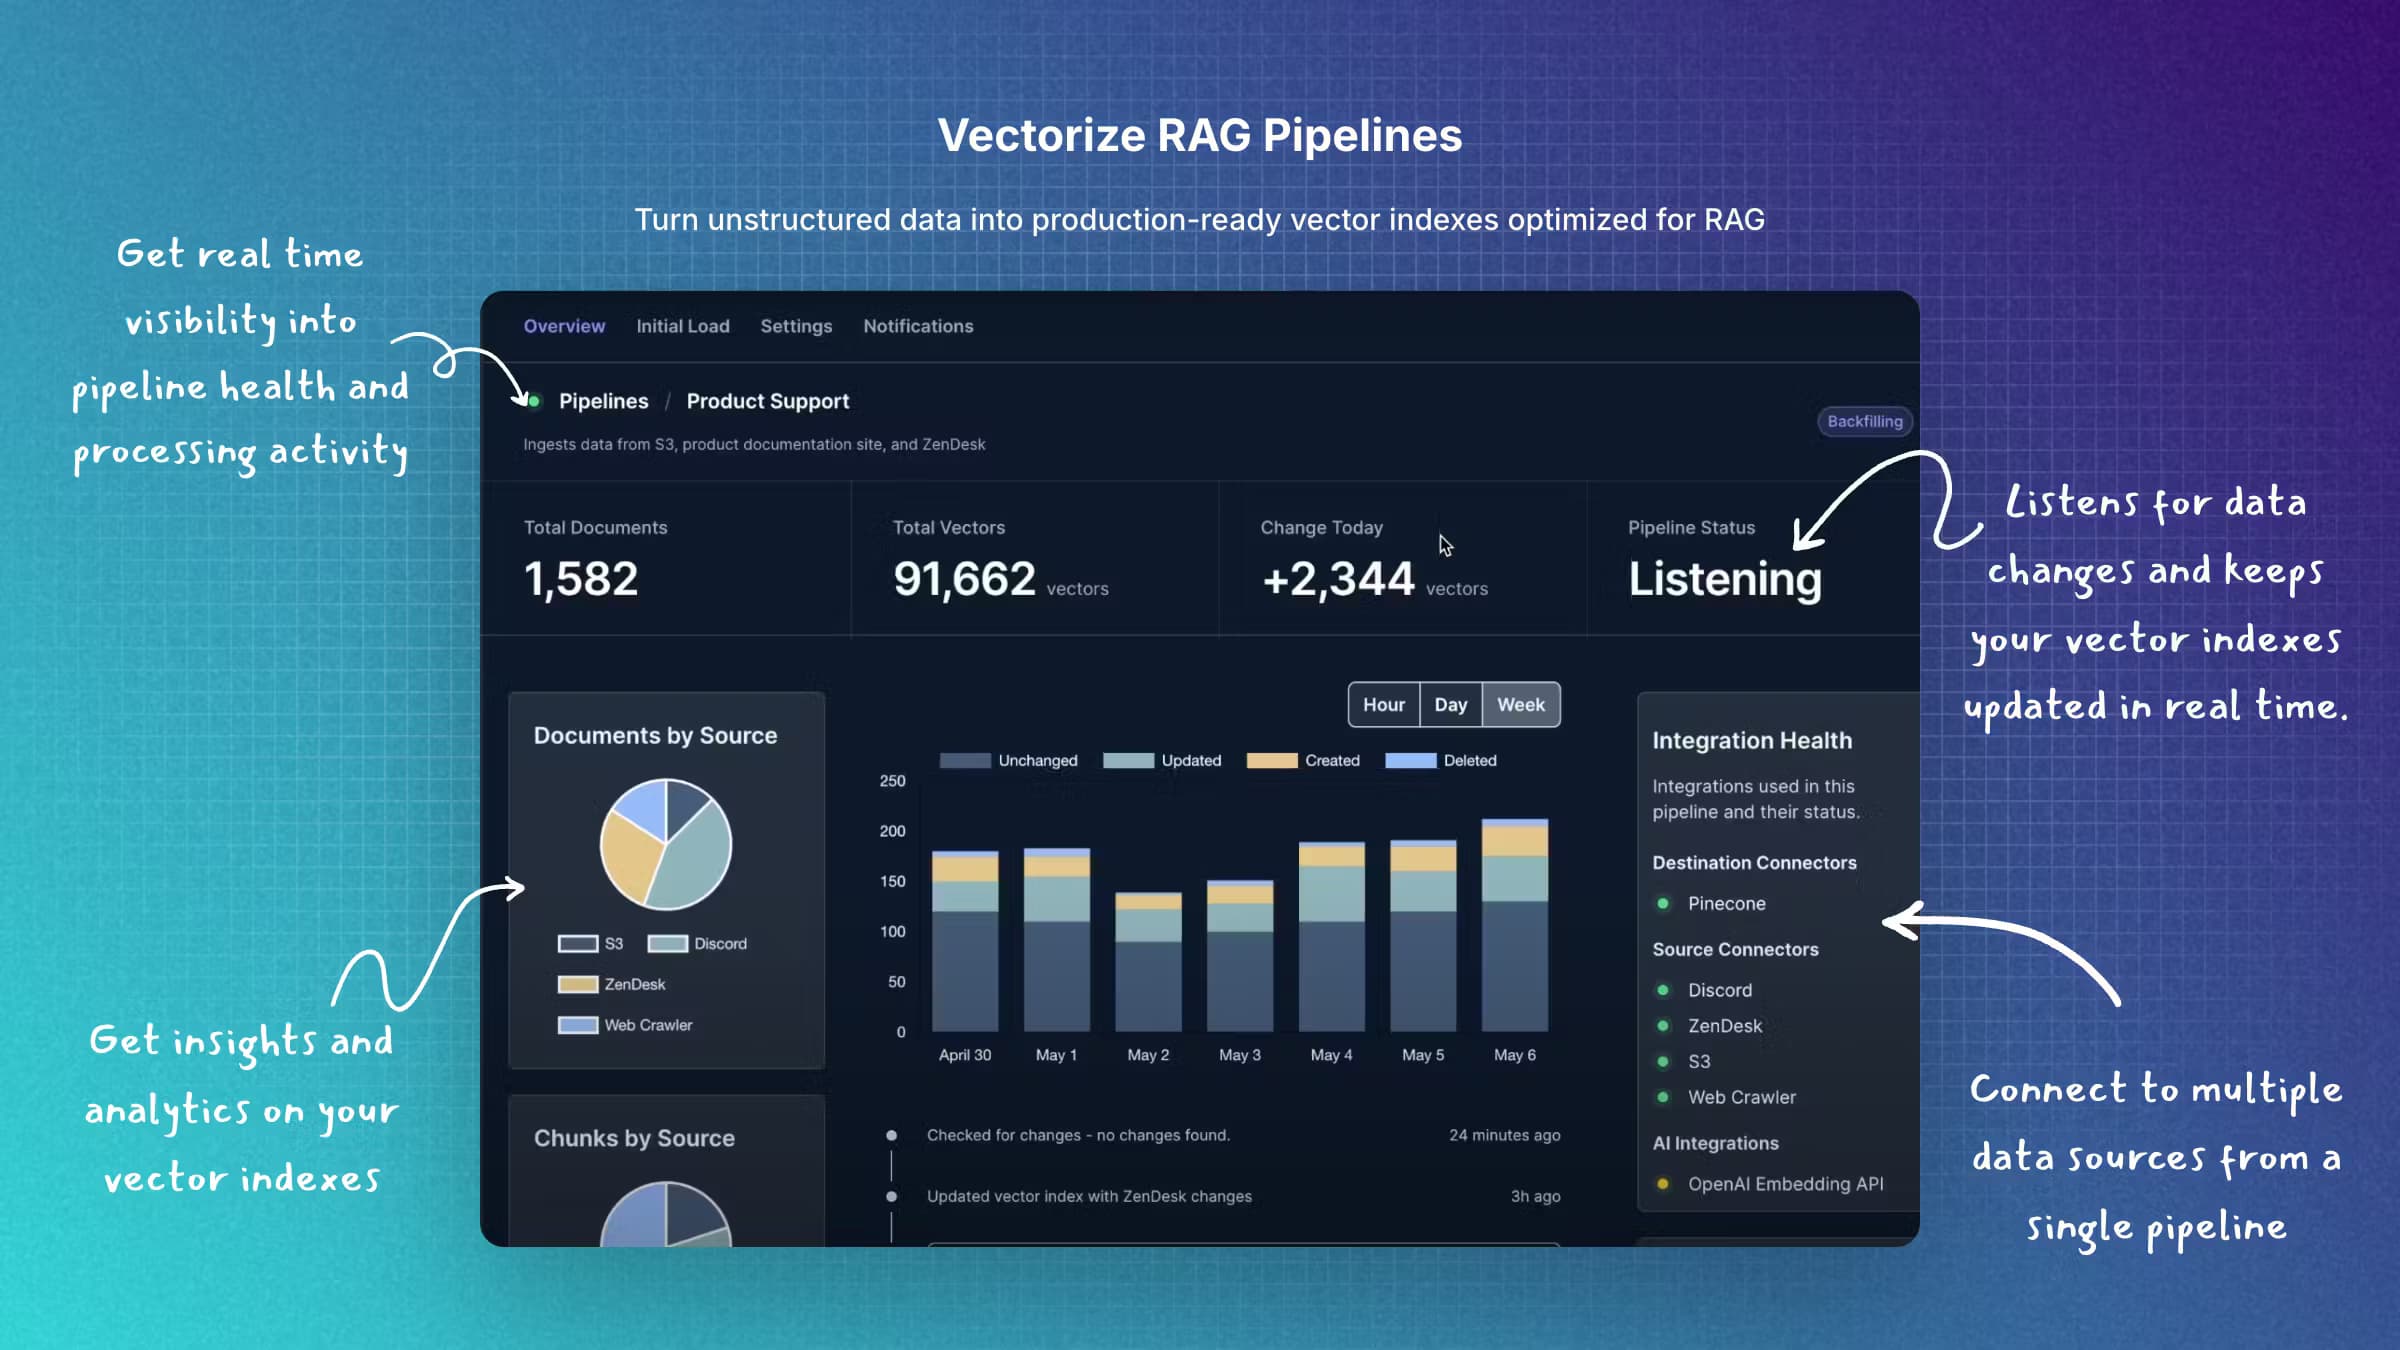
O Vectorize é uma plataforma hospedada para montar pipelines de geração aumentada por recuperação, ou RAG. Ele se concentra em montar um pipeline RAG em tempo real, em que o índice se atualiza conforme os dados de origem mudam. Ele se conecta aos dados que você já tem, arquivos, unidades na nuvem, históricos de conversa, tickets de suporte e conteúdo de sites, transforma esse conteúdo em embeddings e grava tudo num banco vetorial que você controla. A ideia é dar a um modelo de linguagem um contexto privado e recente com o qual ele nunca foi treinado.
O problema que ele ataca é o conhecimento espalhado ou desatualizado. Se você monta o mesmo pipeline à mão, acaba ligando vários serviços, um para extrair o texto, outro para dividir e gerar embeddings, outro para guardar os vetores, além do seu próprio código para manter tudo sincronizado. O Vectorize junta essas etapas atrás de uma única interface e faz cada mudança nos dados de origem chegar ao índice.
A principal limitação está no escopo. O Vectorize cuida da camada de recuperação, não da camada do modelo, então você ainda traz o seu próprio LLM e banco vetorial. Ele também prioriza conectores pré-configurados em vez de pipelines totalmente sob medida, o que significa que uma fonte de dados incomum pode exigir trabalho extra.
Getting Started
- Crie uma conta em platform.vectorize.io e monte uma organização para o seu projeto.
- Conecte uma fonte de dados, como uma unidade na nuvem, upload de arquivos ou uma base de conhecimento SaaS, na lista de conectores prontos.
- Escolha um banco vetorial de destino, como Pinecone, Qdrant ou PostgreSQL, e selecione um modelo de embeddings da OpenAI, Voyage AI ou das opções integradas.
- Configure o pipeline para sincronizar as mudanças conforme elas acontecem e comece a indexar o seu conteúdo.
- Consulte o índice pelo endpoint de recuperação, que gera o embedding da pergunta, executa uma busca k-ANN e devolve resultados ordenados com pontuações de relevância.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Vectorize.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores backend e de ML
- Times iniciantes lançando um produto de IA
- Engenheiros de dados e plataforma em empresas maiores
Tarefas
- Ancorar um chatbot de suporte
- Manter um índice de busca em dia
- Testar a qualidade da recuperação
Cenários
- Times com documentação que muda rápido
- Produtos com muitas fontes de dados
- Ambientes regulados
Principais recursos
Construtor de pipelines RAG
O construtor de pipelines é o centro da ferramenta. Você escolhe uma fonte, um banco de destino e um modelo de embeddings, e o Vectorize monta para você as etapas de extração, divisão, embeddings e armazenamento. É uma abordagem de apontar e configurar em vez de um framework centrado em código, o que encurta o tempo entre conectar uma fonte e ter um índice consultável. Times que quiserem trocar de modelo depois podem fazer isso sem refazer todo o fluxo.
Atualizações vetoriais em tempo real
Quase toda configuração de RAG fica desatualizada no instante em que um documento muda, porque a indexação roda numa agenda fixa. O Vectorize vigia as fontes conectadas e envia as mudanças para o armazenamento vetorial conforme elas acontecem, então uma nova página de políticas ou um ticket resolvido chegam ao índice pouco depois de aparecer. Isso mantém as respostas presas ao que de fato existe hoje nos seus sistemas.
Endpoint de recuperação avançada
O endpoint de recuperação concentra várias etapas numa só chamada. Ele vetoriza a consulta recebida, executa uma busca k-ANN no seu índice, opcionalmente reescreve a consulta com base no histórico da conversa e aplica uma reordenação integrada. Os resultados voltam com pontuações de relevância, similaridade de cosseno e metadados, o que ajuda quando você precisa mostrar fontes ou filtrar por atributos do documento em vez de receber só um bloco de texto.
Integração com banco de dados vetorial
A integração com banco de dados vetorial deixa você escolher o armazenamento. O Vectorize guarda os embeddings num banco que você escolhe em vez de trancar os dados no armazenamento dele. Os conectores pré-configurados cobrem Pinecone, Qdrant, Weaviate, PostgreSQL, Elastic, Azure AI Search, Neo4j, Milvus e outros. Você conserva as ferramentas de consulta, os controles de acesso e os backups em que já confia, e pode mover os dados ou rodar cargas mistas no mesmo armazenamento.
Conectores de origem
A lista de conectores chega onde o conteúdo real vive: armazenamento na nuvem como Amazon S3 e Google Cloud Storage, apps de produtividade como Google Drive e Dropbox, ferramentas de conversa como Discord e plataformas como Confluence, GitHub e Intercom. Ingerir dessas fontes direto evita exportar tudo para uma pasta temporária primeiro, o que reduz tanto o trabalho de configuração quanto as dessincronizações.
Escolha do modelo de embeddings
Você não fica preso a um único provedor de embeddings. A plataforma aceita modelos da OpenAI, Voyage AI, Amazon Bedrock, Vertex AI e outras plataformas de IA, então você pode pesar custo contra qualidade de recuperação e escolher por pipeline. Trocar de provedor depois é um ajuste de configuração e não uma reescrita, o que ajuda quando aparece um modelo melhor ou mais barato.
Processamento visual com Iris
O Vectorize Iris lida com PDFs complexos que a extração de texto simples estraga, como páginas digitalizadas, tabelas densas e layouts em que o significado depende da estrutura. Ele lê a disposição visual para que os trechos com embeddings mantenham as relações de tabela e página que importam para uma recuperação precisa, que costuma ser justamente onde os analisadores simples falham.
Prós e contras
Prós
- Mantém os seus vetores num banco que você controla, então as regras de acesso e os backups que você já usa continuam valendo.
- A sincronização em tempo real reduz o trabalho manual de reindexação do qual as configurações RAG desatualizadas dependem.
- Conectores pré-configurados para armazenamento, SaaS e bases de conhecimento comuns cortam o tempo de implantação.
- O endpoint de recuperação junta a reescrita de consultas e a reordenação, então você escreve menos código de ligação.
- Existe um nível gratuito para desenvolvedores individuais e projetos paralelos.
Contras
- Você ainda precisa do seu próprio LLM e banco vetorial, então não é uma pilha de aplicação completa.
- Fontes de dados incomuns ou internas podem precisar de trabalho sob medida fora dos conectores prontos.
- O preço escala conforme as páginas processadas, então volumes altos de documentos podem subir os custos rápido.
- O construtor de pipelines funciona pela interface, então times que preferem ferramentas centradas em código podem achá-lo limitado.
Perguntas frequentes
O Vectorize cria e executa pipelines RAG que dão a um modelo de linguagem um contexto privado e atualizado a partir dos seus próprios dados. Você conecta fontes, escolhe um banco vetorial e consulta o índice por um endpoint de recuperação.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Vectorize.
Alternativas a Vectorize

Udon
Udon · Programação · ProdutividadeO Udon transforma um Mac com Apple Silicon em servidor doméstico gerenciado pelo navegador, com contêineres, arquivos compartilhados e um administrador de sistemas com IA opcional.

offstage
offstage cloud · Programação · ProdutividadeO offstage entrega um Mac de verdade para agentes de IA e jobs de CI: uma conta macOS 27 em Apple silicon, controlada por API e cobrada por segundo.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Programação · ProdutividadeO BotBus leva os agentes de programação com IA do seu computador para o celular e o relógio: você aprova comandos, inicia tarefas e lê resultados sem voltar para a mesa.