
Vogent Voicelab
Vogent · Voz e linguagem · Programação
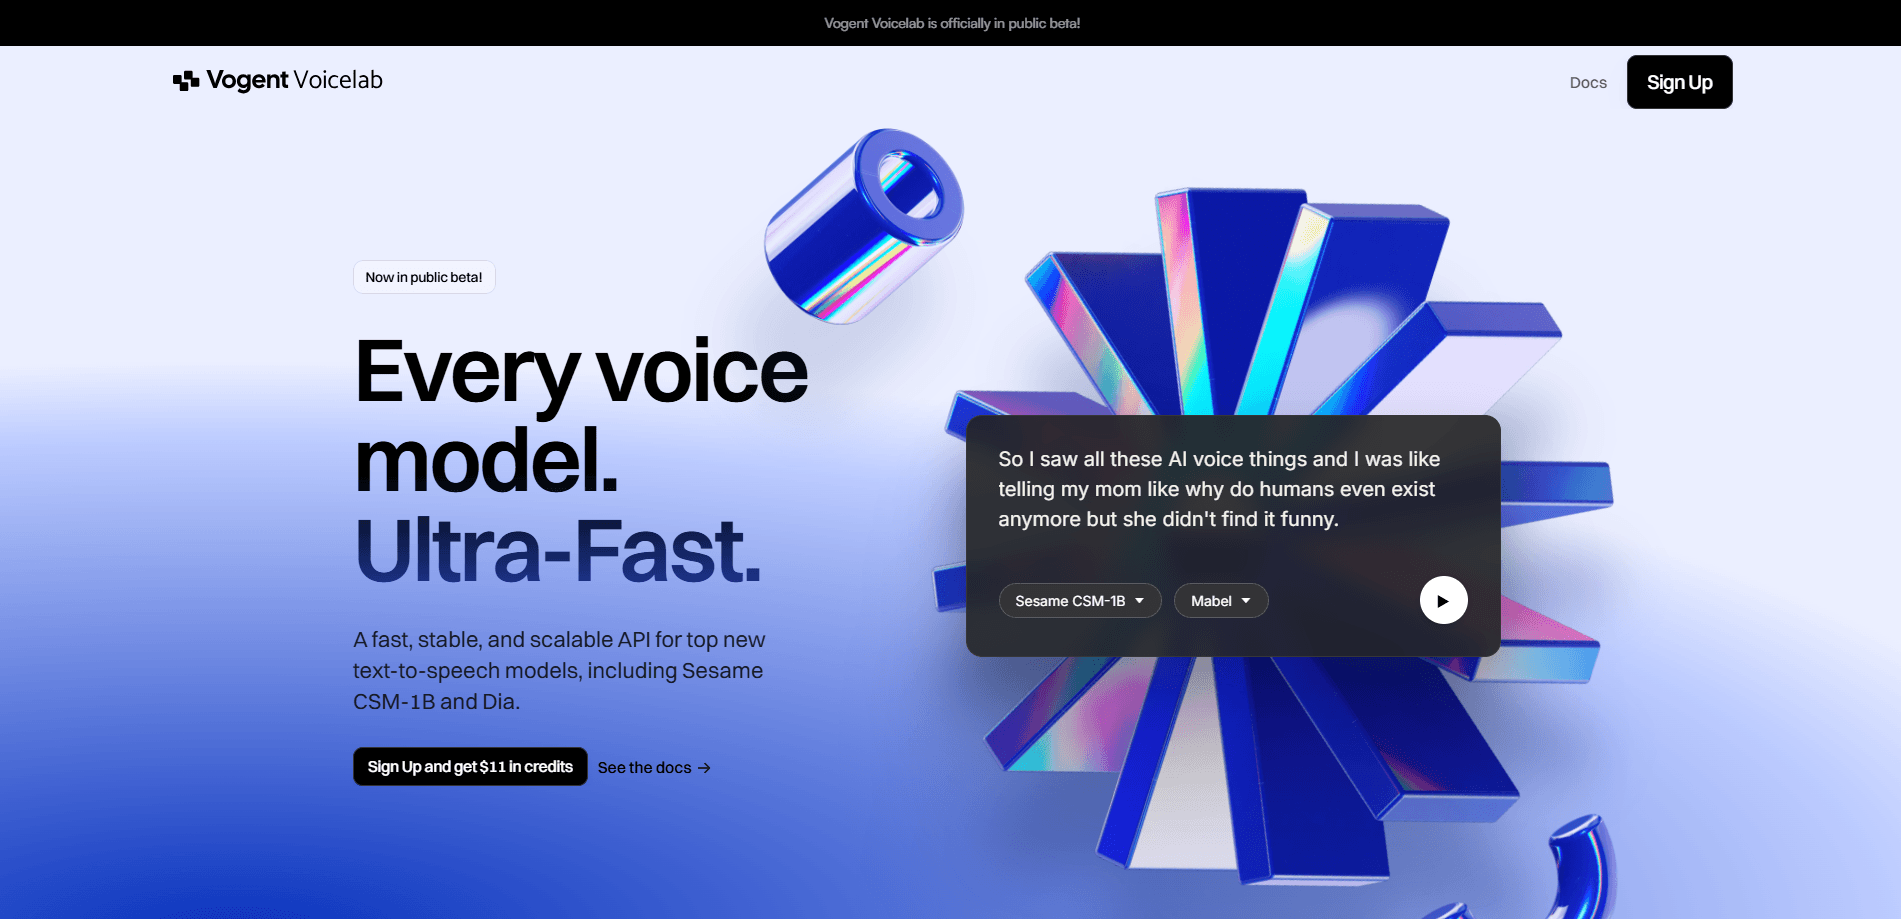
O Vogent Voicelab é uma API de texto para fala que roda modelos de voz de código aberto como Sesame CSM-1B e Dia em um endpoint rápido e barato, com clonagem a partir de um áudio curto.
Sobre Vogent Voicelab
What Is Vogent Voicelab
O Vogent Voicelab é uma API para rodar os principais modelos de texto para fala de código aberto, esses que vivem no topo das tabelas de voz, sem montar GPUs próprias. Você envia texto para um endpoint, escolhe uma voz e recebe áudio de volta. É só isso, e o alvo são desenvolvedores que querem fala realista dentro de um produto, não mais uma assinatura para administrar.
Os modelos são o atrativo. O Sesame CSM-1B lida bem com diálogo natural de ida e volta, o Dia lê texto geral e aceita etiquetas emotivas como uma risada ou um suspiro, e o Orpheus aposta mais forte na entrega emocional. A cada poucas semanas aparece uma voz de código aberto nova, e o Voicelab mantém uma lista ativa para você testar o que saiu sem reescrever sua stack.
O detalhe vale saber desde o começo. Alguns modelos ainda não passaram por pós-treinamento, então a qualidade pode oscilar entre gerações, e quase todo o catálogo fala inglês primeiro. Além disso, o Voicelab é uma ferramenta para desenvolvedores de raiz, então o valor aparece quando você encaixa a voz em um app, não quando quer uma frase falada rápida.
Getting Started
- Cadastre-se em app.vogent.ai e pegue uma chave de API gratuita na seção API da barra lateral.
- Escolha uma voz da biblioteca ou envie um áudio de 15 a 20 segundos para clonar a sua.
- Envie uma requisição POST para o endpoint de TTS com o texto e um voiceId, e guarde o arquivo de áudio retornado.
- Para dois falantes, troque para o endpoint multispeaker e envie várias falas, cada uma com sua própria voz.
- Para apps ao vivo, abra a rota WebSocket e transmita o texto para o áudio tocar antes de a frase terminar.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Vogent Voicelab.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores de apps
- Criadores independentes e startups
- Times de produto que somam IA conversacional
Tarefas
- Gerar locuções para demos e vídeos
- Montar um diálogo entre duas pessoas
- Clonar uma voz específica
- Transmitir fala para um app ao vivo
Cenários
- Testar vários modelos de TTS antes de decidir
- Rodar um piloto de voz com orçamento apertado
- Passar de uma locução só para muitos agentes ao mesmo tempo
Principais recursos
Uma API para vários modelos de voz
O Voicelab coloca CSM-1B, Dia, Orpheus e uma lista crescente de modelos de código aberto atrás de um mesmo endpoint. Você troca o modelo sem mudar a forma de chamá-lo. Isso evita reescrever a integração cada vez que surge uma voz melhor, o que neste campo acontece direto.
Clonagem de voz instantânea
Envie uma gravação de 15 a 20 segundos e o Voicelab monta um clone usável daquela voz. Serve para quase todo projeto, e a documentação recomenda manter um áudio natural e conversacional em vez de uma leitura polida para chegar mais perto do original. Também há vozes de atores profissionais já treinadas se você preferir não clonar nada.
Fala conversacional realista
O CSM-1B foi feito para o diálogo, não só para ler texto em voz alta. Ele conduz o pequeno toma lá dá cá de uma conversa real e mantém uma voz estável mesmo em gerações longas. Se seu produto tem um assistente com quem as pessoas conversam, comece por esse modelo.
Diálogo com vários falantes
Um endpoint dedicado transforma uma lista de falas em uma conversa pronta, cada fala com sua voz. Dois falantes se alternam em um arquivo só. É um jeito simples de produzir entrevistas, podcasts ou cenas de personagens sem colar áudio na mão.
Streaming em tempo real por WebSocket
Para uso ao vivo, o Voicelab abre uma rota WebSocket que transmite texto e devolve pedaços de áudio conforme são criados. Seu app pode começar a falar antes de a resposta inteira ser escrita. Isso conta em chatbots e em qualquer experiência em que uma pausa quebra o ritmo.
Etiquetas emotivas e ajuste fino
O Dia e o Orpheus aceitam etiquetas como um suspiro ou uma risadinha, que puxam a entrega para um sentimento em vez de uma leitura chapada. Nos planos mais altos você também pode ajustar uma voz com seus próprios dados e hospedá-la, fundo o bastante para mudar o estilo, não só copiá-lo.
Prós e contras
Prós
- Uma API cobre vários modelos de TTS de código aberto de ponta, então você os testa sem contas separadas.
- O plano gratuito inclui 180 minutos de fala, acesso à API e clonagem.
- A clonagem instantânea pede só um áudio curto, o que deixa as vozes próprias ao alcance.
- O preço por minuto cai ao subir de plano, de cerca de 6 centavos para 3.
- O streaming, o modo multispeaker e as etiquetas emotivas vêm de fábrica, não como extras.
Contras
- Nem todo modelo passou por pós-treinamento, então a qualidade varia entre gerações.
- Quase todos os modelos são inglês primeiro por enquanto, então outros idiomas dependem da saída em inglês.
- É uma ferramenta para desenvolvedores, ou seja, não há editor de arrastar e soltar para uma fala rápida.
- As vozes treinadas sob medida e a instalação local ficam atrás do plano Business, pedido por contato.
Perguntas frequentes
É uma API para rodar modelos de texto para fala de código aberto como Sesame CSM-1B, Dia e Orpheus. Você envia texto, escolhe uma voz e recebe áudio, tudo sem hospedar os modelos você mesmo.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Vogent Voicelab.
Alternativas a Vogent Voicelab

Foley
Hanamori Labs, LLC · Voz e linguagem · Produtividade · Assistente de IAFoley é uma lista de tarefas por voz que transforma uma frase falada em tarefa arquivada, com projeto, data e hora já preenchidos, e depois ajuda você a organizar o dia com o que já está anotado.

HireKey
HireKey · Voz e linguagem · Produtividade · AprendizadoHireKey é um copiloto de busca de emprego com IA criado por uma recrutadora de tecnologia. Avalia aderência à vaga, adapta o currículo, treina entrevistas e organiza cada candidatura.

Fluence
Yay Software (Yannick Huchard) · Escrita · Voz e linguagem · ProdutividadeO Fluence é um app de Android que lê em voz alta PDF, EPUB, arquivos do Word e artigos da web, acompanha a frase falada e responde perguntas sobre o texto sem sair do celular.