

Web Bench
Skyvern and Halluminate · Programação · Produtividade
O Web Bench é um benchmark de agentes de navegação com IA criado pela Skyvern e a Halluminate que mede o desempenho em 5.750 tarefas por 452 sites.
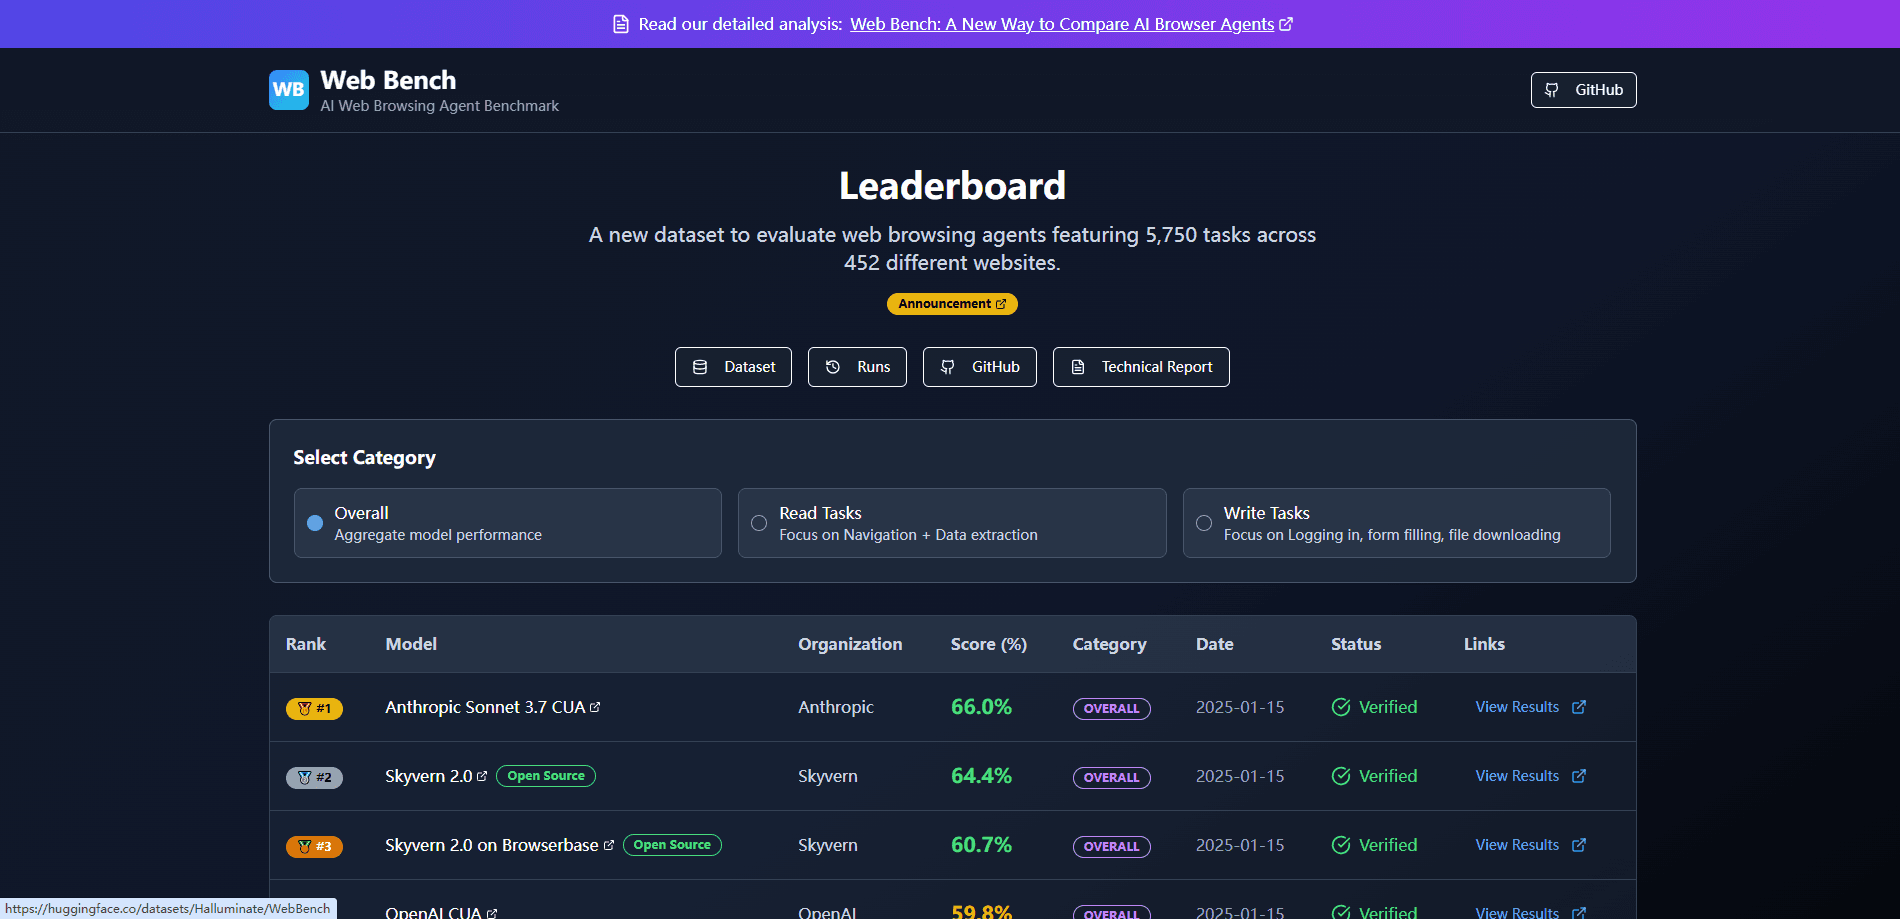
Sobre Web Bench
What Is Web Bench
O Web Bench é um benchmark que mede quão bem agentes de navegador com IA concluem tarefas reais em sites ao vivo. A Skyvern e a Halluminate o lançaram para substituir o WebVoyager, um conjunto antigo que cobria só 643 tarefas em 15 sites. Hoje os agentes que controlam um navegador fazem candidaturas de emprego, baixam faturas e preenchem formulários fiscais, então faltava um sistema de medição mais amplo.
O benchmark divide cada tarefa em dois grupos. As tarefas de leitura pedem que o agente navegue por um site e extraia informação. As de escrita pedem login, preenchimento de formulário, solução de verificação em duas etapas ou download de arquivo. As de escrita quase não apareciam em testes anteriores, e é aí que a maioria dos agentes tropeça. Esse desenho faz dele uma avaliação de agentes de navegador, não um teste de chatbot comum.
Os limites são o alcance e a frequência. Ele pontua apenas sites em inglês do top 1.000 global, uma fatia pequena da web, e os resultados só mudam quando a equipe roda o conjunto de novo. Mede precisão, custo e velocidade, não se é seguro deixar o agente sozinho com suas contas.
Getting Started
- Abra o ranking público em webbench.ai para comparar agentes pela nota geral, de leitura ou de escrita.
- Confira o conjunto de dados aberto no GitHub ou no Hugging Face para ver as tarefas exatas e a lista de sites.
- Leia o relatório técnico para entender como cada execução foi pontuada e validada.
- Se você desenvolve agentes, fale com a equipe da Halluminate para enviar seus próprios resultados ao quadro.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Web Bench.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de IA
- Equipes de produto
- Pesquisadores
Tarefas
- Avaliar uma versão própria
- Escolher entre agentes
- Achar pontos fracos
Cenários
- Uma equipe prestes a implantar um agente de uso de computador que precisa de prova de que ele passa por login e checkout. Os agentes de uso de computador que agem dentro de um navegador recebem aqui o sinal mais direto, e o ranking de agentes web permite ordená-los por tipo de tarefa.
- Uma startup que pesa dois fornecedores de automação de navegador e quer uma régua comum.
- Um redator ou analista que cita números atuais de precisão de agentes de navegador num relatório.
Principais recursos
Separação entre Tarefas de Leitura e Escrita
O Web Bench separa as tarefas que extraem dados das que os alteram. As de leitura cobrem navegação e extração; as de escrita, login, entrada em formulários, 2FA e downloads. A divisão importa porque um agente que brilha lendo costuma travar em tudo o que muda um site.
5.750 Tarefas em 452 Sites
O conjunto roda 5.750 tarefas em 452 sites tirados do top 1.000 global por tráfego. A amplitude é o ponto: benchmarks anteriores testavam um punhado de sites, então os agentes podiam decorar layouts. Mais sites significa que os resultados se transferem melhor para as páginas que você usa de verdade.
Dados de Tarefas Abertos
Cerca de 2.454 tarefas saem como dados abertos no GitHub e no Hugging Face. Qualquer um pode inspecionar as instruções, rodar o conjunto de novo ou treinar contra ele. Para equipes que desconfiam de rankings fechados, isso mantém a pontuação auditável.
Falhas de Agente e Infraestrutura Separadas
Cada execução falha leva uma etiqueta de causa. Erros de agente cobrem navegação ruim, sucesso inventado, tempo esgotado e extração errada. Erros de infraestrutura cobrem bloqueio de proxy, captcha e detecção de bot no login. A separação diz se você deve consertar o modelo ou a pilha do navegador.
Métricas de Custo e Velocidade
Além da precisão, o Web Bench registra a duração e o número de passos por tarefa. Os passos definem o custo de quase todo agente, então os números ajudam a estimar o gasto de um deploy real. Também mostra se cabe um preço por hora ou por passo.
Modos Copiloto e Autônomo
O quadro pontua duas configurações. O benchmark autônomo roda os agentes sem ajuda. O de copiloto os roda com uma pessoa no circuito. Comparar os dois mostra o quanto uma pessoa no fluxo muda o resultado.
Prós e contras
Prós
- Registra fricções reais como login, captcha e formulário que benchmarks anteriores ignoravam.
- Conjunto de dados e logs de execução abertos deixam as equipes conferirem as notas em vez de confiarem nelas.
- A divisão entre leitura e escrita torna os resultados úteis para fluxos específicos.
- Inclui passos e tempos, então você pesa custo junto com precisão.
Contras
- Cobre só sites em inglês, então um agente multilíngue não recebe sinal aqui.
- Tira amostras do top 1.000, o que deixa páginas de nicho ou regionais sem teste.
- As notas só se renovam quando a equipe repete o conjunto, então podem ficar atrás de agentes novos.
- O teto nas tarefas de escrita é baixo em geral, então reporta números fracos até para os melhores agentes atuais.
Perguntas frequentes
Mede com que precisão agentes de navegação com IA concluem tarefas reais em sites ao vivo, além de quantos passos e quanto tempo cada execução exige. Todo resultado mistura precisão com sinais de custo e velocidade.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Web Bench.
Alternativas a Web Bench
Forefront
Forefront · ProgramaçãoO Forefront é uma plataforma web para construir com IA de código aberto. Você ajusta os principais modelos de linguagem de código aberto com seus próprios dados, avalia o desempenho deles e os roda por uma API ou os exporta para hospedar por conta própria. Desenvolvedores que querem a conveniência de uma plataforma fechada, mas fazem questão de ser donos dos modelos e dos dados, são o público-alvo aqui.

Startkit
StartKit.AI · ProgramaçãoStartkit é um boilerplate para criar produtos de SaaS com IA e wrappers de IA. Pense nele como um boilerplate para startups de IA com as partes chatas já conectadas: autenticação, pagamentos com Stripe e Lemon Squeezy, limites de uso, e-mail transacional e um kit inicial de API de IA que conversa com OpenAI, Anthropic, Groq ou Llama. Você clona o repositório, define seu preço e começa pela parte do produto que as pessoas realmente pagam. Ele é feito em Next.js sobre React e Tailwind, então boa parte do código boilerplate já parece familiar.
Testim
Tricentis · ProgramaçãoO Testim é uma plataforma de automação de testes com IA para criar e executar testes de ponta a ponta em aplicações web, mobile e Salesforce. Ele se apoia no aprendizado de máquina para manter os testes estáveis quando uma interface muda, então as equipes gastam menos tempo consertando seletores quebrados. Nada mal para uma ferramenta de testes automatizados que você pode começar a usar hoje. Você cria testes gravando ações no navegador e depois adiciona JavaScript quando precisa de mais controle. É uma escolha sólida para equipes de QA ocupadas.