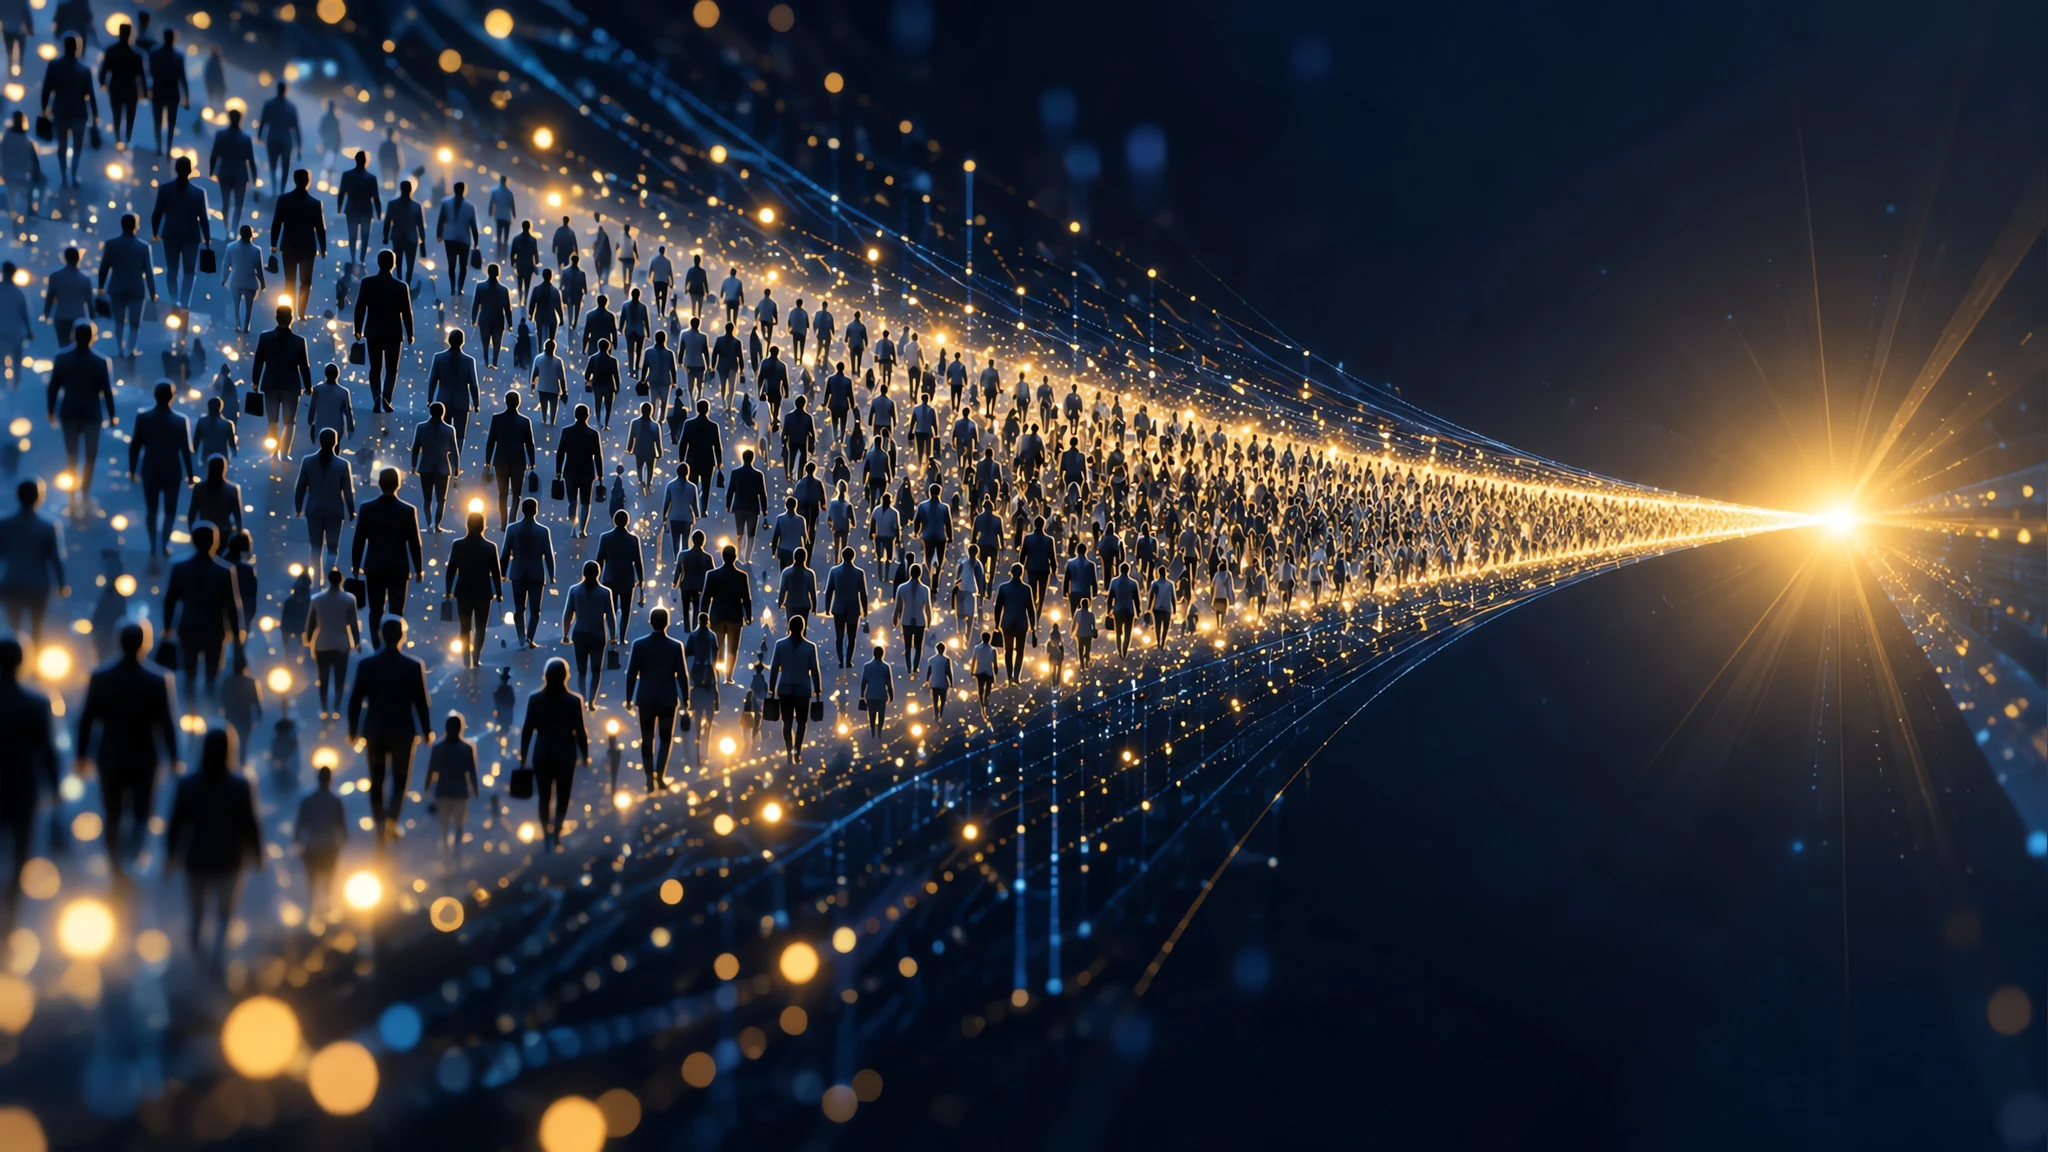
Andrej Karpathy 說,大家對大型語言模型能力的理解落差,已經不是「兩群人各說各話」,而是一個上寬下窄、愈收愈緊的落差結構。他自己的粗略估算,約有 60 億人幾乎沒碰過前沿模型。
Karpathy 說的落差是什麼形狀?
10 月 11 日,Andrej Karpathy 在 X 上發文,說公眾對大型語言模型能力的共同理解落差正在擴大。他形容,這個落差過去像「兩群人各說各話」,現在則比較像一個上寬下窄、愈收愈窄的結構。
Karpathy 是 AI 領域的重量級研究者,曾任特斯拉 AI 主管,也是 OpenAI 的早期成員。他的說法屬於個人觀點,不是研究機構的正式結論。
他用的比喻很直白。寬的那一端,站著絕大多數幾乎沒接觸過前沿模型的人;窄的那一端,才是真正在日常使用這些工具的人。兩端之間的落差,就是他說的「理解鴻溝」。
「餐巾紙估算」點出的數字
Karpathy 提到一組粗略估算:大約 60 億人,也就是全球人口的七成五左右,幾乎沒接觸過前沿模型的能力。
這個數字推估自全球人口與實際使用規模之間的落差。它精確到什麼程度,Karpathy 自己也說是隨手算的,重點不在數字本身,而在量級。當大部分的人連一次都沒用過,討論「AI 有多強」就難有共同基礎。
換句話說,爭論雙方可能根本不在同一個起點上對話。一端談的是親身使用的心得,另一端談的是從新聞標題拼出來的印象。
為什麼這個落差會擴大
落差擴大,一部分來自使用門檻與資訊落差。
前沿模型多半要付費、要英文能力、還要願意花時間摸索。能跨過這幾道門檻的人相對集中,得到的是第一手的體驗。其他人拿到的,往往是二手轉述,或社群平台上最戲劇化的片段。
Karpathy 的說法之所以引起討論,是因為它點出一件容易被忽略的事:工具愈強,內外落差可能愈大,而不是愈小。普及需要時間,能力成長卻很快。
社群怎麼接這個話題
這則貼文在 Hacker News 上引來約 198 分、316 則討論,多位業界人士轉發,包括 Ethan Mollick。
Karpathy 在貼文裡提到,他是把今年 4 月的一則舊貼文「重新拿出來撣塵」,用意正是強調這道落差是在加深,不是收斂。社群反應大致分成兩類:一派認同落差確實存在,另一派則追問該怎麼把更多人拉進這一端。
認同落差擴大的一派
- 使用門檻集中在付費、語言與時間
- 多數人的印象來自二手轉述
- 能力成長快,普及速度相對慢
主張落差被誇大的一派
- 免費版本與行動 App 已降低入門門檻
- 年輕世代接觸 AI 的速度比想像中快
- 「沒用過」與「沒能力用」是兩回事
這道落差對 AI 發展意味著什麼
Karpathy 沒有提出解方,他做的是把問題攤在檯面上。但這個視角對產業有意義。
如果多數人對模型能力的認知停在很淺的層次,那麼關於 AI 的公共討論、監管、甚至產品設計,都可能建立在失準的前提上。一端覺得無所不能,另一端覺得言過其實,兩種印象都與實際情況有距離。
對開發者與使用者而言,這也提醒一件事:你熟悉的工具操作,在更廣的人群裡可能還是新鮮事。落差本身就是一種需要被納入考量的現實。
後續值得留意的地方
這是一則個人觀察,不是有數據支撐的研究,該用這把尺去衡量它:它提出的是問題,不是結論。之後值得看的是,免費版與行動端能不能真正把寬口那一端的人帶進來,以及這種落差會不會反映在政策與市場的判斷上。