
關於 Cerebrium
What Is Cerebrium
Cerebrium 是給需要快速回應的 AI 工作負載用的基礎架構。你把 Python 程式碼打包成容器、部署上去,Cerebrium 就把它變成一個會自己擴縮的端點。平台支援 CPU 與 NVIDIA GPU,瞄準的是冷啟動與延遲直接決定產品能不能用的工作:語音代理、串流輸出模型,以及高流量推論。
速度來自兩件事。容器一到三秒就能啟動,而一套叫做 Content-Aware Storage 的機制只會拉取新執行個體真正需要的檔案,不必下載整份映像檔。遇到較吃重的工作,記憶體與 GPU 檢查點會替執行中的行程拍快照,下次啟動時模型就能跳過匯入與 CUDA 編譯。Cerebrium 說檢查點能大幅縮短冷啟動,這項功能目前仍在測試階段。
收費看用量,不看席次。工作負載執行時佔用的 vCPU、記憶體與 GPU,你按秒付費,按秒計費讓支出緊貼實際的工作量。Hobby 方案可免費開始,運算費用另計;Standard 每月 100 美元再加運算費,席次與應用都無上限。需要保留容量、大量折扣或 ML 工程協助的團隊,則走 Enterprise。運算跑在 Google Cloud、AWS 與 Azure 上,Cerebrium 會把工作導向最合適的一方。
Getting Started
- 用 pip install cerebrium 安裝 CLI,macOS 也可用 Homebrew,Linux 則有 binary 安裝包。
- 執行 cerebrium login,接著開啟儀表板建立 API key 並找到你的專案 ID。
- 執行 cerebrium init my-first-app,建立含 main.py 與 cerebrium.toml 的專案。
- 用 cerebrium run main.py::run 測試程式碼,再用 cerebrium deploy 上線。
- 透過部署後的 api.cerebrium.ai 網址呼叫端點,或設定自訂網域。
產品資訊
快速了解 Cerebrium 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 要上線推論 API 的 AI 工程師:部署一個容器就得到會擴縮的 REST 端點,不必管伺服器或 Kubernetes。CLI 打理整個部署循環。
- 流量起伏大的團隊:請求暴增時容量跟著長,停了就縮回去,深夜不會為閒置 GPU 付錢。按秒計費只算真正跑過的部分。
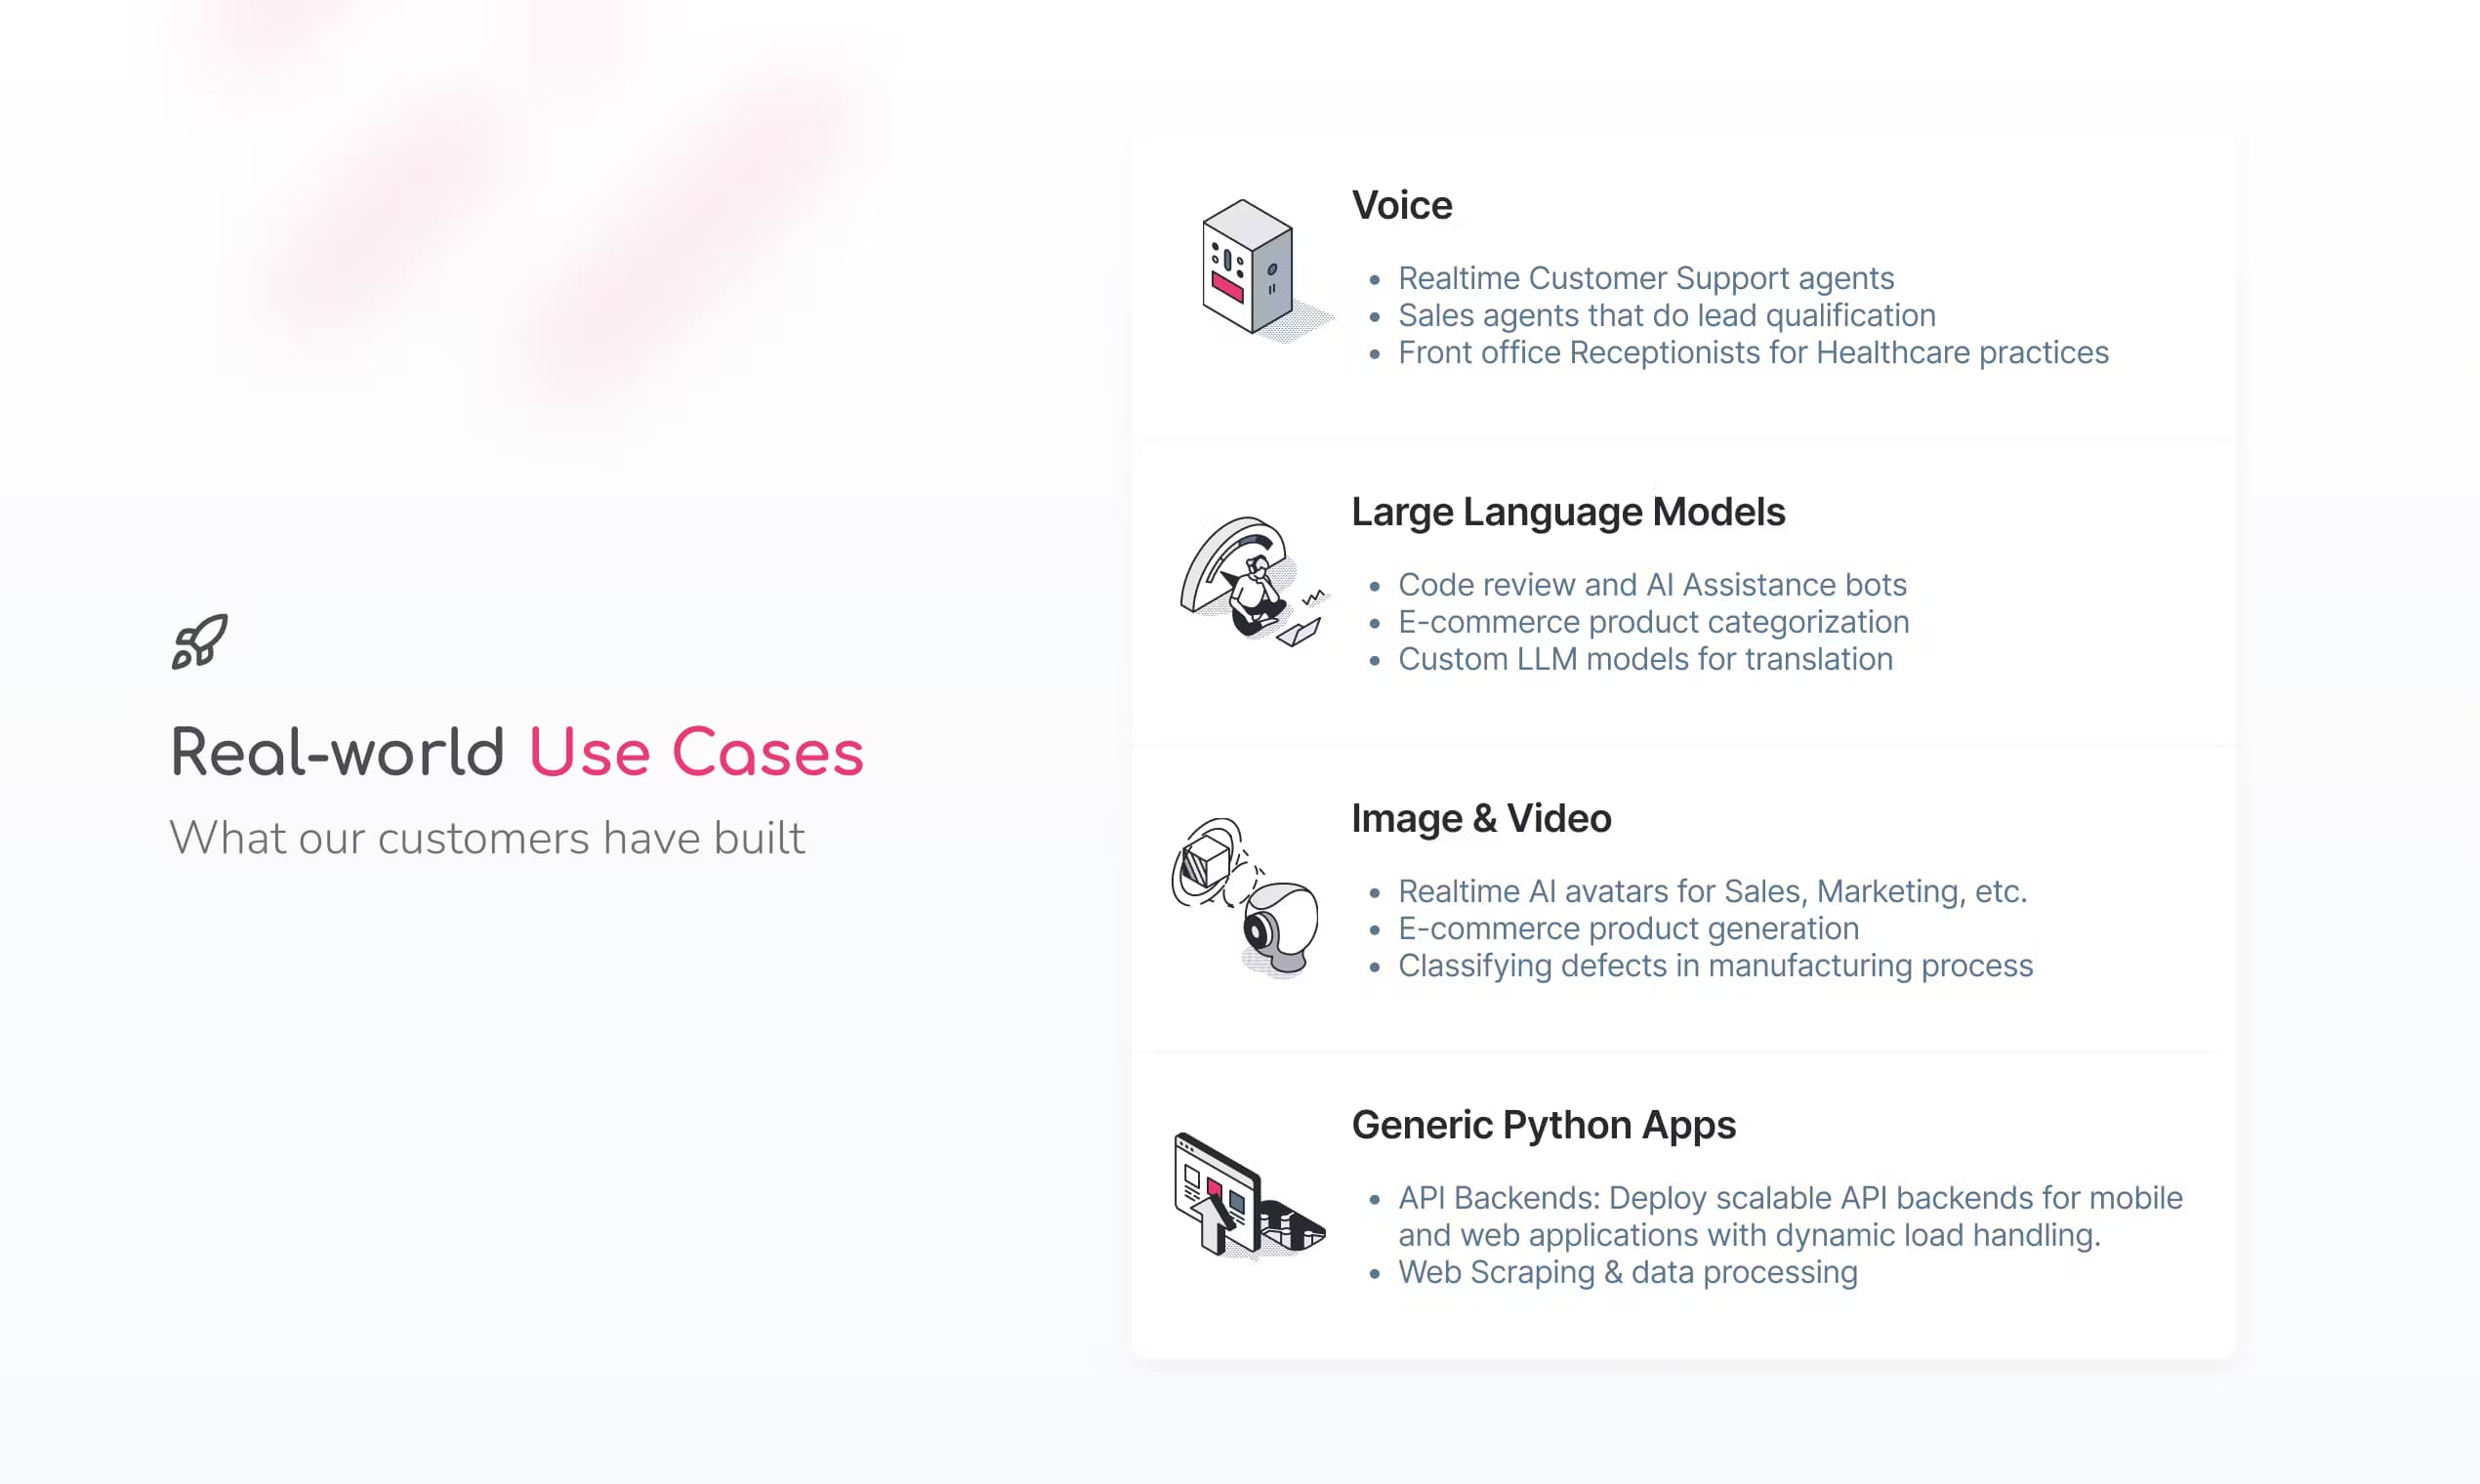
- 做語音與串流應用的開發者:低冷啟動加上串流端點,讓回應落在來電者預期的停頓之內。WebSocket 則處理雙向語音。
- 有資料落地規範的企業:多區域部署把工作負載固定在指定區域,平台也符合 SOC 2、HIPAA、GDPR 與 ISO 合規要求。
任務
- 服務開放權重模型:相容 OpenAI 的 vLLM 端點,讓既有用戶端以串流回應和你的模型對話。
- 生成圖像與影片:GPU 端點跑 SDXL 這類擴散流程,並以同一套 REST 模式回傳結果。
- 轉錄長音訊:Whisper 類工作以非同步方式執行,回傳 run_id,跑完再把結果送到 webhook。
- 打造即時語音代理:Pipecat 或 LiveKit 的技術堆疊跑在 GPU 上,以低延遲接聽來電。
- 執行嵌入與重排序:高吞吐服務在單一端點後面處理向量工作,依副本數擴縮。
情境
- 電話客服機器人在對方還在講話時就回應:模型在停頓結束前完成這一輪。
- 上線當天的流量暴衝:額外容器幾秒內上線,人潮散去後又消失。
- 一批過夜的轉錄工作:任務以非同步排隊,完成後把結果回傳。
- 使用者分散各地的全球應用:部署到多個區域,所有人的來回時間一起縮短。
主要功能
不到一秒的容器啟動
Cerebrium 用一到三秒啟動容器,靠的是 Content-Aware Storage 只拉取需要的檔案,加上記憶體與 GPU 檢查點跳過匯入、模型載入與 CUDA 編譯。啟動快在即時應用裡最關鍵,因為第一次請求太慢,使用者只會當成產品壞了。
無伺服器 GPU 與 CPU
你在 cerebrium.toml 設定 GPU 型號與數量、vCPU 核心與記憶體,可選 NVIDIA 的 H100、A100、L40s 等卡。執行個體隨流量擴縮,冷清的一小時花費不多,忙碌的一小時也不會失控。你只按秒付實際配置的資源。
多區域部署
同一份部署能跨多個區域跑,換取更低的延遲與更高的可用性,也能為資料落地固定在單一區域。Cerebrium 跑在 Google Cloud、AWS 與 Azure 上,宣稱 99.999% 可用性,並在某個區域掛掉時以容錯切換把流量改導。
彈性的端點型態
應用可以供應 REST API、以 server-sent events 推送的串流端點、處理雙向語音的 WebSocket,或任何相容 ASGI 的網頁伺服器。這樣的廣度讓同一個平台既能接簡單的 JSON 呼叫,也能跑即時語音工作階段。
自動擴縮與批次處理
你可以設定副本數、擴縮指標與運算等級,再依實際流量調整並行度與批次。搭配 vLLM 或 LitServe 的原生批次能拉高 GPU 吞吐,讓高負載下每一次請求的成本下降。
持久儲存
儲存磁碟區在部署之間保留模型權重與檔案,CLI 提供上傳、下載與列表指令,每個專案最多可擴到 1TB。權重在每次啟動間留存,容器不用每次重抓。
安全與隔離
每個工作負載跑在強化的 gVisor 沙箱上,容器隔離夠強又不至於犧牲太多效能。平台符合 SOC 2、HIPAA、GDPR 與 ISO,密鑰會加密並以環境變數方式提供。
CI/CD 與 GitHub 整合
應用能連結 GitHub 儲存庫,推送或合併就觸發部署,流程中用服務帳號金鑰。漸進式部署設定會在固定時間窗內把流量從舊版本移到新版本,降低壞版本上線的風險。
優缺點
優點
- 第一次請求一到三秒就到,即時與語音應用不會在啟動時卡住。
- GPU、CPU 與記憶體都按秒計費,成本緊貼實際工作,也讓 AI 推論基礎架構變得可負擔。
- 免費 Hobby 方案與 100 美元的 Standard 方案,讓試用與小型應用都很便宜。
- 多區域部署與合規涵蓋範圍,適合有全球使用者或受監管資料的團隊。
- 支援 REST、串流、WebSocket 與自帶 Docker 或 ASGI 伺服器,符合多數技術堆疊。
缺點
- 記憶體與 GPU 檢查點仍在測試階段,最大的冷啟動改善還沒完全定案。
- 定價頁沒有列出固定的每 GPU 費率,你只能用計算機估算或索取報價。
- AWS 與 GCP 的抵用金不能折抵,這點讓已經押注這兩朵雲的團隊意外。
- 保證 GPU 容量需要每月最低消費,小型專案因此用不上。
常見問題
Cerebrium 是為即時與高效能 AI 工作負載設計的無伺服器 GPU 平台。你部署一個容器,它就變成會擴縮的端點,跑在 CPU 或 NVIDIA GPU 上,按秒計費。
相關內容
探索與 Cerebrium 相關的工具、技能與文章。
Cerebrium 替代方案

Base Code
Base44 (Wix) · 程式設計 · 生產力Base Code 是 Base44 推出的共享雲端開發環境。團隊在對話中描述對既有 GitHub 儲存庫的修改,看著預覽確認結果,再以 Pull Request 交回工程團隊。

Google EmbeddingGemma 2
Google DeepMind · 寫作 · 圖片 · 程式設計Google EmbeddingGemma 2 是 7.4 億參數的開源模型,能把文字、程式碼、圖片、音訊與影片畫面轉成同一個 768 維空間裡的向量,在手機與筆電上就能執行。

GitGlow
GitGlow · 程式設計 · 生產力GitGlow 是桌面版 Git 用戶端,把你自己的程式碼與 AI 代理程式的變更集中在同一份審查裡,讓你在交付前看清楚機器上究竟要送出什麼。