
EnergeticAI
EnergeticAI open-source project · 程式設計
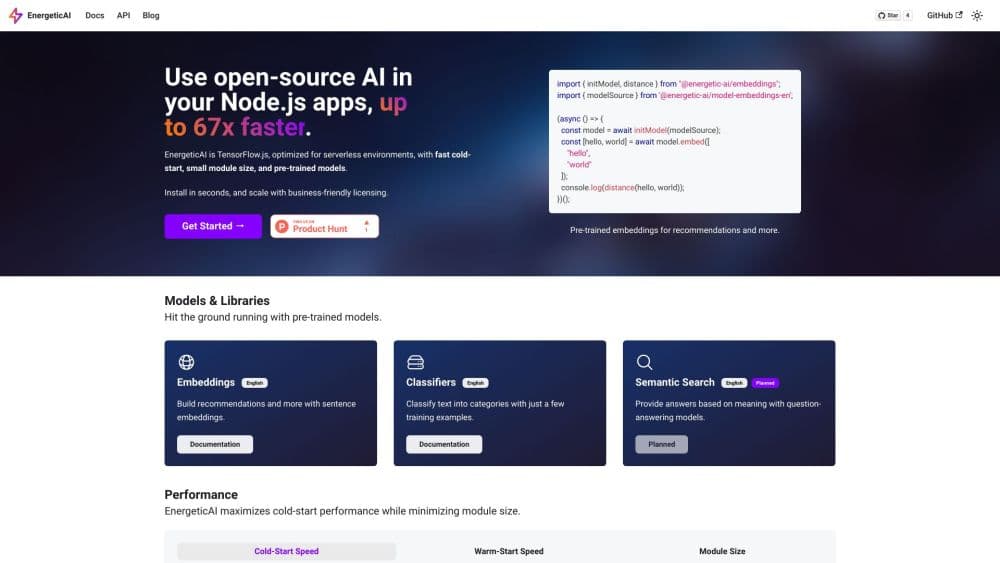
EnergeticAI 是為無伺服器函式打造的 TensorFlow.js 開源發行版,讓 Node.js 應用在約 50 毫秒的冷啟動內跑完嵌入模型或文字分類器。
關於 EnergeticAI
What Is EnergeticAI
EnergeticAI 是 TensorFlow.js 的精簡版,針對 AWS Lambda、Vercel Functions、Netlify Functions 這類無伺服器函式重新打包。它解決的是一個很實際的部署問題。原始函式庫未壓縮時佔 146 MB 到 513 MB,常常在程式碼還沒開始執行前就撞上套件大小上限。模型權重還會在第一次呼叫時才下載,冷啟動因此被推到兩秒以上。
專案只留下推論需要的部分。模組大小降到約 3 MB,依團隊自己的測試,冷啟動推論接近 50 毫秒,核心套件則可以直接取代 @tensorflow/tfjs-core。也就是說,你手上既有的程式碼與模型多半不必改寫就能跑。
限制和優點一樣明顯。預訓練模型只涵蓋英文嵌入與文字分類,語意搜尋仍標示為規劃中,全部運算走 WebAssembly,沒有 GPU 加速。npm 上的版本是 2023 年 6 月發布的 0.2.0,請把它當成穩定但沉寂的專案,而不是持續擴張的平台。
Getting Started
- 安裝 Node 18 以上版本,然後裝入核心套件與你要用的模型庫:
npm install @energetic-ai/core @energetic-ai/embeddings @energetic-ai/model-embeddings-en。 - 從模型庫匯入
initModel與對應的模型來源,每個函式實例載入一次權重。 - 對字串陣列呼叫
model.embed()取得向量,或改用分類器套件,用幾十筆標註樣本訓練。 - 用內建的
distance比較向量,再把分數接進你的排序、過濾或分流邏輯。 - 部署到無伺服器平台後檢查套件大小,因為這個上限正是大家改用 EnergeticAI 的原因。
產品資訊
快速了解 EnergeticAI 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 部署到無伺服器平台的 Node.js 開發者:這個函式庫就是為了撐過 TensorFlow.js 過不去的套件上限,時間該花在功能上,而不是打包技巧。
- 獨立開發者與小型團隊:沒有推論帳單,也不用申請 API 金鑰,側專案在流量真的進來之前一直是零成本。
- 資料規範嚴格的團隊:推論在你自己的函式裡完成,文字不離開自家基礎設施,隱私文件也不必多列一家供應商。
- 要加入第一個 AI 功能的後端工程師:預訓練模型就能處理常見情境,不需要訓練流程、GPU 或隨時待命的機器學習專家。
任務
- 用嵌入向量做商品推薦:目錄索引一次,每次請求即時算出頁面向量,再依距離排序。
- 用幾十筆標註樣本訓練文字分類器,替客服工單或表單內容分流。
- 靠向量距離把重複的評論、回饋或重複刊登的商品歸在一起,不必手寫關鍵字規則。
- 在幾百份文件上疊一層輕量語意搜尋,前提是你接受專用的語意搜尋模型還在規劃中。
情境
- 在免費或低價方案上部署,套件上限卡得死,3 MB 的模組決定你能不能上線。
- 推論的內容不能送到外部 API,例如內部工單、臨床紀錄或受合約保護的客戶資料。
- 在筆電上先把 AI 功能做出來,同一份程式碼直接推上正式環境,不必為了某家供應商的 SDK 重寫模型層。
主要功能
為無伺服器而生的打包方式
整個專案都繞著函式平台的限制設計。模組縮到約 3 MB,能塞進 Lambda 與邊緣環境常見的上限,而原始 TensorFlow.js 往往直接超出。模型權重跟著套件一起走,不必在第一次呼叫時下載,冷容器因此不用等網路就能回應。
冷啟動速度
官網宣稱在無伺服器函式中的推論速度可達 TensorFlow.js 的 67 倍,測試方式是在 M1 Max 的 MacBook Pro 上初始化模型,並對一段五句文字算出嵌入。實際數字會隨平台與輸入長度變動。方向倒是很清楚:幾十毫秒而不是好幾秒,而這正是請求會不會逾時的關鍵。
預訓練嵌入模型
嵌入套件把字串轉成可以比較、分群或排序的向量。英文模型獨立成一個權重套件,你只裝需要的語言。想做出推薦或文字相似度,這是最快的路徑,完全不用自己訓練。
少量樣本的文字分類器
分類器套件在執行時用一小批標註樣本訓練,適合只有 20 或 50 筆資料、拿不出完整資料集的分流與標記工作。標註留在你的儲存庫裡,每次部署重新訓練,行為就跟著程式碼一起版控。
直接相容 TensorFlow.js
核心模組對應 @tensorflow/tfjs-core 的 API,既有的 import 與模型程式碼通常照樣能跑。你可以先拿一個端點試,確認沒問題再換掉整個服務,嘗試成本因此很低。
WebAssembly 後端
推論走 WebAssembly,處理短輸入夠快,而且任何 Node 主機都能跑,不需要原生編譯。它沒有 GPU 加速,大批次與長文件的速度會比 CUDA 機器慢上一截。
優缺點
優點
- 套件從幾百 MB 降到約 3 MB,很多時候這是模型能不能放上無伺服器方案的唯一條件。
- 依專案測試,冷啟動接近 50 毫秒,使用者請求不會卡在模型載入。
- Apache 2.0 授權,預訓練模型也挑過授權條款,商業使用相對單純。
- 沒有逐次呼叫費用,資料也不必送出你的函式,這點和託管式嵌入 API 差別很大。
- 核心套件可以直接放進既有 TensorFlow.js 程式碼,遷移通常只是換一個依賴。
缺點
- 預訓練模型只有英文,多語產品得自備權重並另外測試。
- 沒有 GPU 支援,大批次處理偏慢,文件一多,小函式每次請求可能要好幾秒。
- 模型種類很少:目前只有嵌入與分類器,語意搜尋還在規劃中。
- npm 上停留在 2023 年 6 月的 0.2.0,等於採用一個更新緩慢的專案,請固定版本,出問題時直接讀原始碼。
常見問題
它讓開源 AI 模型跑在無伺服器函式裡。常見用途包括商品推薦、文字分類、重複內容偵測,以及在不便載入完整機器學習堆疊的 Node.js 後端做語意搜尋。
相關內容
探索與 EnergeticAI 相關的工具、技能與文章。
EnergeticAI 替代方案

Base Code
Base44 (Wix) · 程式設計 · 生產力Base Code 是 Base44 推出的共享雲端開發環境。團隊在對話中描述對既有 GitHub 儲存庫的修改,看著預覽確認結果,再以 Pull Request 交回工程團隊。

Google EmbeddingGemma 2
Google DeepMind · 寫作 · 圖片 · 程式設計Google EmbeddingGemma 2 是 7.4 億參數的開源模型,能把文字、程式碼、圖片、音訊與影片畫面轉成同一個 768 維空間裡的向量,在手機與筆電上就能執行。

GitGlow
GitGlow · 程式設計 · 生產力GitGlow 是桌面版 Git 用戶端,把你自己的程式碼與 AI 代理程式的變更集中在同一份審查裡,讓你在交付前看清楚機器上究竟要送出什麼。