
General Compute
General Compute · 程式設計
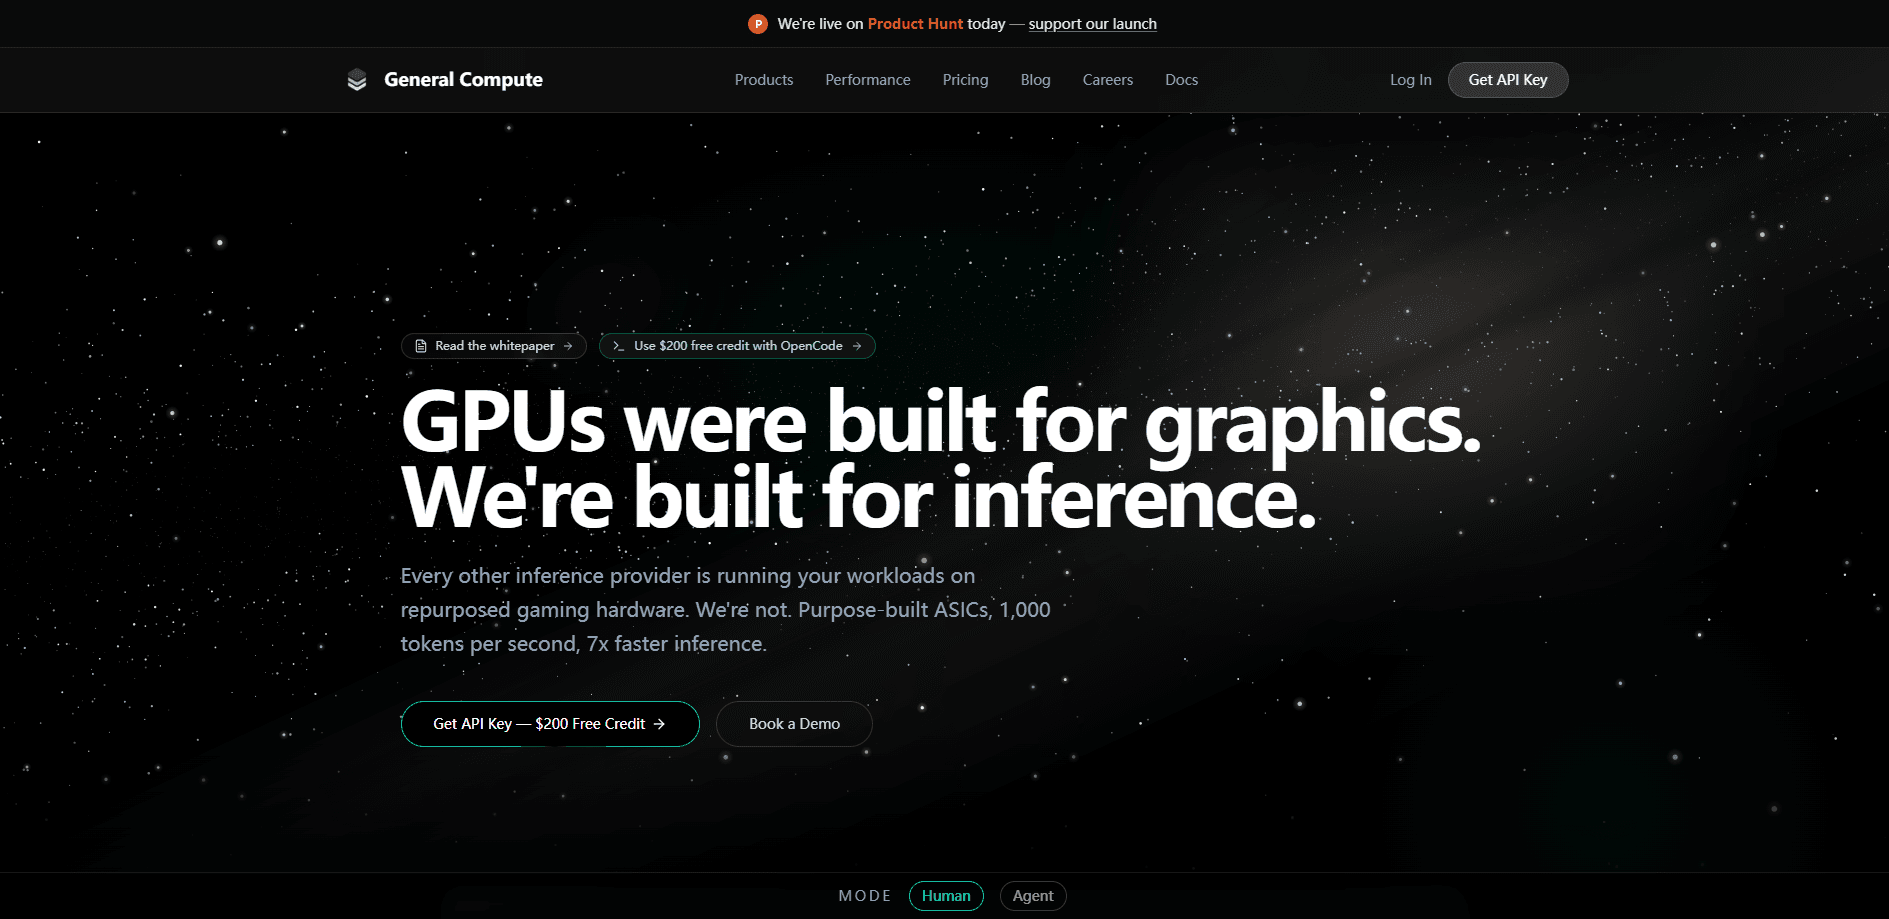
General Compute 是一套為單一任務打造的 AI 推論雲端:用比純 GPU 供應商更快的速度提供大型語言模型。它在 SambaNova、Cerebras、Positron 與 d-Matrix 的專用解碼晶片上執行相容於 OpenAI 的端點,而前處理則留在 NVIDIA B300 機架上。新帳號可獲得 100 美元免費額度,需要保留容量或私有權重的團隊也可以改簽專屬合約。 價格同樣透明。推論 API 價格依每百萬權杖計費,自助方案不收每月席位費。沒有隱藏的平台費用。
關於 General Compute
什麼是 General Compute
General Compute 是一間推論供應商,把 LLM 工作負載分散到兩種硬體上。前處理這個吃重運算的開場階段跑在 GPU 上。解碼這個受記憶體限制、一次產生一個權杖的部分,則跑在專門為此打造的 ASIC 加速器上。它的主張很直白:解碼速度才是讓代理執行感覺緩慢的原因,而增加更多 GPU 運算並不能解決問題。
產品以 REST API 的形式呈現,你可以把現有的 OpenAI SDK 指向它。換掉基底網址與 API 金鑰,你的工具呼叫、JSON 模式與串流就會繼續運作。可用的模型包括 MiniMax M2.7、DeepSeek V3.2、DeepSeek V3.1 與 GPT-OSS 120B。
主要的限制在於成熟度。General Compute 是年輕的供應商,其招牌速度數據來自自家測試。如果你需要一套有十年歷史、涵蓋每個區域與所有合規認證的雲端,這不是。如果你想要快速的權杖生成與簡單的移轉途徑,值得一看。
開始使用
- 在 app.generalcompute.com 建立帳號,領取 100 美元免費額度。
- 從儀表板產生 API 金鑰,複製你的基底網址。
- 換掉 import 與金鑰,把 OpenAI SDK 指向 General Compute 端點。
- 在請求中挑選像
minimax-m2.7或deepseek-v3.2這樣的模型 ID。 - 執行第一次呼叫,然後從隨用量計費方案擴大使用量。
產品資訊
快速了解 General Compute 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- AI 開發者:任何已經在用 OpenAI SDK 的人,只要換掉基底網址與金鑰,幾分鐘內就能移轉,不必重寫。
- 代理開發者:執行長時間多步驟代理迴圈的團隊受益最大,因為解碼延遲會在數百次呼叫中累積。
任務
- 對延遲敏感的對話:需要低首權杖時間與快速逐權杖輸出的串流回應。
- 結構化代理工作流程:工具呼叫與 JSON 模式讓代理能針對解析後的輸出採取行動,不必額外寫黏合程式碼。
- 私有模型代管:擁有自訂 LoRA 或微調檢查點的團隊,可以把自家權重部署在私有模型 ID 後面。
情境
- 為新的 AI 功能製作原型:100 美元免費額度能支應初期測試,不必先跟業務談。
- 大規模生產推論:保留的解碼容量在流量尖峰時溢出到配對的 GPU 機隊,因此突發流量不會讓硬體閒置。
主要功能
專用解碼晶片
多數推論雲端把一切都跑在 GPU 上。General Compute 把解碼步驟送到為此設計的晶片,包括正式上線的 SambaNova SN50,以及最快方案所用的 Cerebras 晶圓級硬體。該公司表示,這在多兆參數模型上每位使用者每秒可提供 1,000 至 2,000 個權杖,相較之下,B300 機架跑 230B MoE 每秒不到 320 個權杖。這個差距就是產品存在的全部理由。 差別很大。解碼受記憶體限制,所以堆疊 GPU 幾乎推不動它。
相容於 OpenAI 的 API
這套 API 使用與 OpenAI 相同的端點、參數與串流語意。你保留自己的協調器、工具定義與重試邏輯。在多數程式碼庫中,移轉只是改一行。就是這麼簡單。對已經深入使用 OpenAI SDK 的團隊來說,這就是週末專案與一整季重工之間的差別。
多樣的模型,包括推理模型
型錄涵蓋通用與推理模型。MiniMax M2.7 以 192k 上下文視窗處理對話與生成。DeepSeek V3.2 與 V3.1 為數學、程式碼與分析加入內建的思維鏈推理。GPT-OSS 120B 則為開源權重愛好者補齊名單。
帶上你自己的模型
你可以部署私有權重,無論是 LoRA、GGUF 檔案或完整微調。General Compute 把檢查點放進容器,在 us-west-2 接上加速器,並把它暴露在私有模型 ID 後面。你的自訂模型接著就像任何其他模型參數一樣運作,串流與工具呼叫都包含在內。對擁有專有權重的團隊而言,這個模型代管選項正是把目光投向消費級 API 之外的理由。
具備 root 權限的專屬機架
除了自助 API,你還可以在一份含 SLA 的合約下,簽下專屬的前處理與解碼容量。你得到具備 root 權限的裸機、跨三家供應商的價格保護配額,以及在合約期間內把前處理與解碼當成單一服務來協調。
多供應商容量
配額分散在 SambaNova、Cerebras、Positron 與 d-Matrix 之間,所以你不會被綁在單一晶片供應商上。保留的解碼容量可以在流量暴增時溢出到配對的 B300 機隊,讓起伏不定的工作負載不至於擱置一座閒置機架。
優缺點
優點
- 依該公司自家測試,在大型模型上有純 GPU 雲端比不上的解碼速度。
- 相容於 OpenAI 的 API 讓多數團隊不必重寫程式碼就能移轉。
- 工具呼叫、JSON 模式與推理支援在整個型錄都可用。
- 多供應商硬體加上 100 美元免費額度,降低了試用的成本。
- 帶上自家模型的支援涵蓋 LoRA、GGUF 與完整微調。
缺點
- 招牌速度數據來自 General Compute 自家測試,並非獨立驗證,所以在測試自己的工作負載前,請把它們當成供應商說法。
- 目前所有正式流量都跑在單一美國區域,如果你需要其他地區的資料落地,或美國以外的低延遲,這點就很重要。
- 保留與企業方案採自訂價格,所以不跟業務談就無法估算專屬容量的成本。
- 隨用量計費方案只有盡力而為的可靠性,合約式 SLA 保留給企業。
常見問題
它是一套用來執行大型語言模型的 AI 推論雲端,尤其是像多步驟代理迴圈這種延遲會累積、解碼吃重的工作負載。你透過相容於 OpenAI 的 API 呼叫它,而不是自己管理 GPU。
相關內容
探索與 General Compute 相關的工具、技能與文章。
General Compute 替代方案
Forefront
Forefront · 程式設計Forefront 是一個用來打造開源 AI 的網頁平台。你可以用自己的資料微調主流的開源語言模型、評估它們的表現,再透過 API 執行,或匯出後自行架設。想要封閉式平台的便利、卻堅持要自己擁有模型與資料的開發者,就是這裡的目標客群。

Startkit
StartKit.AI · 程式設計Startkit 是一套用來打造 AI SaaS 與 AI 包裝產品的樣板。可以把它想成一個 AI 新創樣板,把枯燥的部分都先接好了:驗證、Stripe 與 Lemon Squeezy 付款、用量限制、交易型電子郵件,以及一套能與 OpenAI、Anthropic、Groq 或 Llama 溝通的 AI API 啟動套件。你複製儲存庫、設定價格,然後專心在產品中使用者真正願意付費的部分。它建構於 React 與 Tailwind 之上的 Next.js,所以大部分的樣板程式碼對你來說並不陌生。
Testim
Tricentis · 程式設計Testim 是專為網頁、行動與 Salesforce 應用程式打造的 AI 測試自動化平台,用來建立並執行端到端測試。它靠機器學習在介面變動時維持測試穩定,團隊因此少花時間修補壞掉的定位器。對於一款今天就能開始使用的自動化測試工具來說,這表現不算差。你透過在瀏覽器錄製動作來建立測試,需要更多控制時再補上 JavaScript。對忙碌的 QA 團隊來說,這是個可靠的選擇。