

HunyuanVideo-Avatar
Tencent Hunyuan · 圖片 · 影片
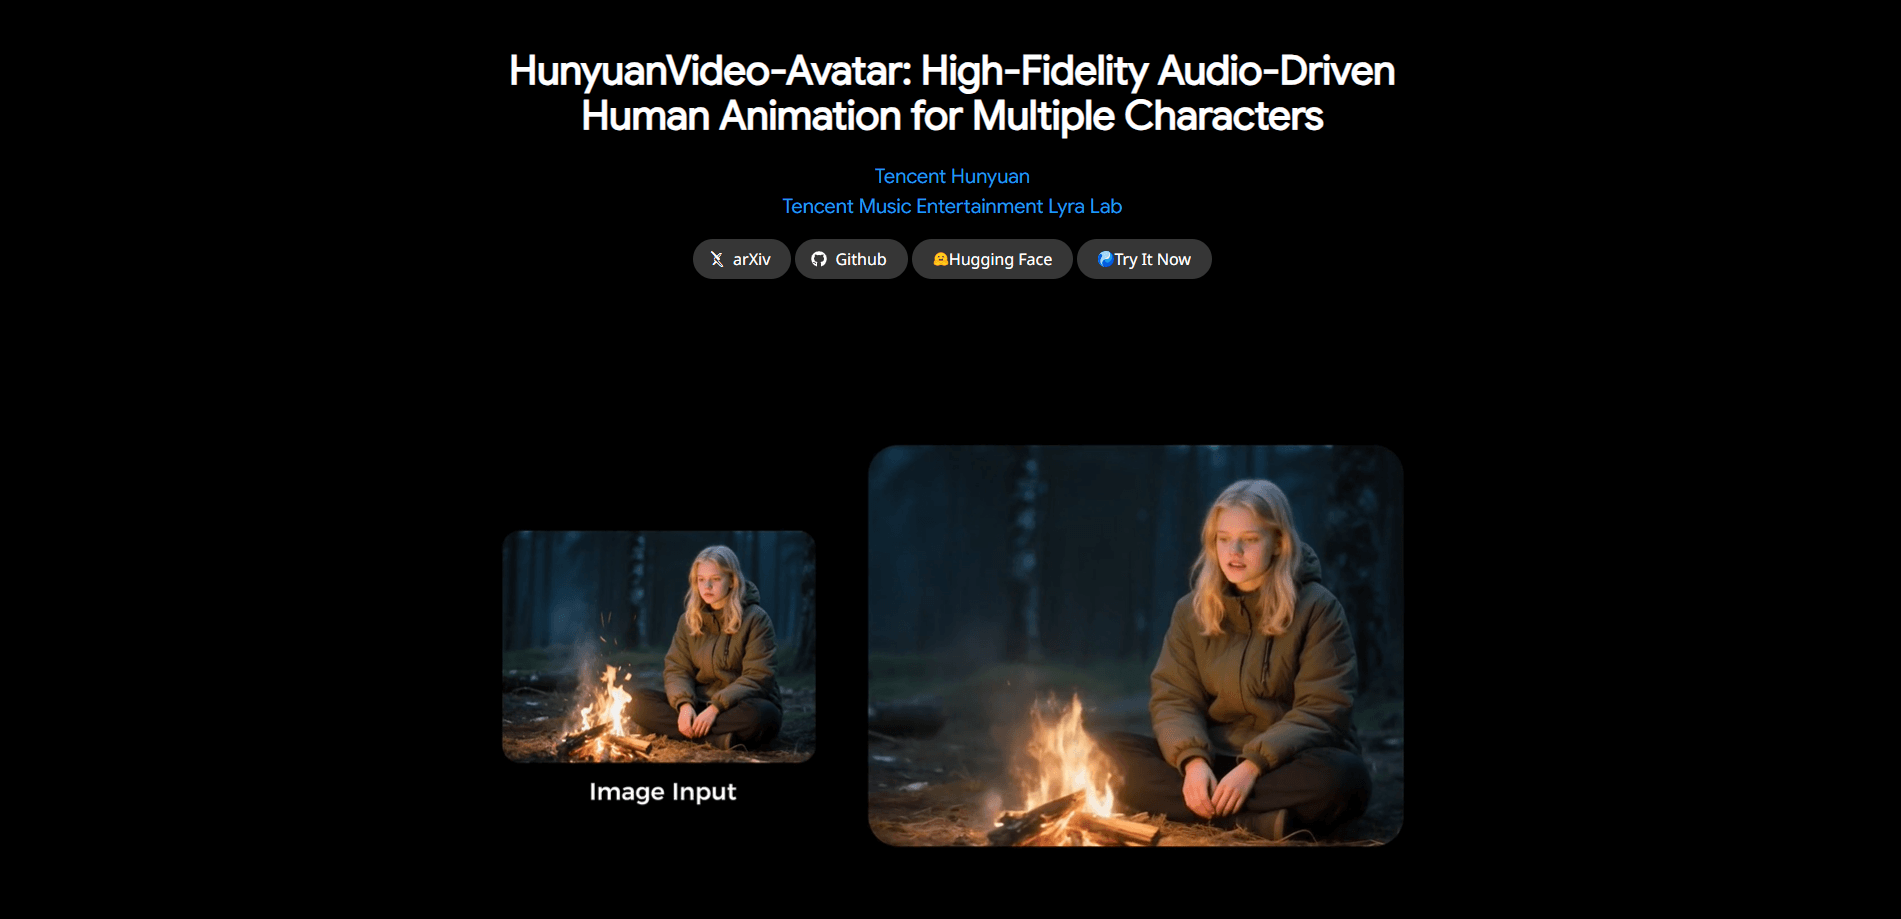
HunyuanVideo-Avatar 是騰訊的開源模型,只要一張圖片加一段音訊,就能生成會說話或唱歌的影片,還能控制情緒、讓多人同框。
關於 HunyuanVideo-Avatar
What Is HunyuanVideo-Avatar
HunyuanVideo-Avatar 是一款音訊驅動人體動畫的開源模型,由騰訊混元聯手騰訊音樂天琴實驗室的 MuseV 團隊打造,於 2025 年 5 月發表。你給它一張人像和一條音軌,它就會回傳一段影片,其中臉部會動、唇形跟著語音,人物的身分從第一格到最後一格都保持一致。
大多數唇形同步工具只顧嘴巴。這款模型驅動整個畫面,從頭肩一直到全身,還會從一張參考圖讀取情緒,所以同一段影片可以做得開心,也可以做得嚴肅。它也能處理同一個場景裡的多個人,各自綁定自己的音軌,這正是早期模型容易把幾張臉糊在一起的地方。輸出最高到 720p,官方體驗頁把音訊上傳限制在約 14 秒。
它不是人人都能一鍵上手的網頁工具。模型以程式碼和權重形式發布,得自己下載並執行,所以想直接使用,你需要一張 NVIDIA 顯示卡和一套正常的 Python 環境。騰訊混元官網有代管的體驗版,但更深入的多人功能放在開源版本裡。你動畫化的任何臉孔或聲音,相關權利與同意都由你自己負責,不是模型。
Getting Started
- 前往官方 GitHub 儲存庫並複製下來,接著架好一套 Python 3.10 環境,搭配支援 CUDA 的 NVIDIA 顯示卡。
- 安裝 README 列出的 PyTorch 與 FlashAttention 相依套件,再下載預訓練權重。
- 挑一張清晰、正對鏡頭的人像當作人物圖片,並準備一段乾淨的語音或歌唱音訊。
- 執行推論腳本,依你的硬體與記憶體選擇單卡或多卡模式。
- 檢視算出的影片,需要的話調整解析度或畫面裁切,然後匯出成果。
產品資訊
快速了解 HunyuanVideo-Avatar 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 短影音創作者:一張照片加一段音訊就能變成可發布的短片,於是不必出動攝影團隊,就能做出主播或唱歌角色。不過最好還是準備一台搭載新款 NVIDIA 顯示卡的機器。
- 開發者與研究人員:程式碼和權重都開源,這讓它成為可微調、可嵌進更大流程的底座,而不是一個封閉服務。
- 電商與直播團隊:會動的主播能在螢幕上念產品資訊或優惠,每次改版都省下真人拍攝的成本。
- 插畫與 3D 藝術家:模型能驅動寫實臉孔、插畫、3D 算圖甚至動物角色,所以風格化的角色一樣有自然的唇形。
任務
- 把人像變成說話影片:你上傳一張臉和一條聲音,模型就做出唇形與表情跟著音訊走的影片。
- 製作唱歌短片:餵它一首歌加一張照片,角色就會用對應的嘴形和動作演唱。
- 控制情緒:加一張情緒參考圖,模型就會改變角色的表情,於是悲傷和開心的音訊讀起來不一樣。
- 讓兩人場景動起來:多人模式給每張臉各自的音軌,所以一段對話不必手動拼接。
- 打造自己的流程:開發者能把模型接進自己的工具,因為權重是在本機執行的。
情境
- 快速更新產品影片:新的腳本加新的聲音就能更新店面影片,不必另外約拍攝。
- 做另一個語言的版本:把音訊換成另一種語言,同一張臉照樣演出,省下重拍主播的功夫。
- 把播客變成影片:一段雙人錄音變成影片,每位主持人的嘴形各對各的音軌。
- 試做虛擬人概念:創作者在投入正式製作前,先測風格化角色的外觀與動態。
主要功能
One Image Plus Audio
核心原理說起來簡單,做起來很難:你交出單一張人像和一條音軌,模型就回傳一段影片,讓角色用對得上的唇形和自然的肢體動作說話或唱歌。它接受各種尺寸與解析度的圖片,所以特寫裁切和全身照都能當輸入。這正是省下一天拍攝的功能,因為一張靜態照片就能替代一場實際演出。
Emotion-Controllable Expression
音訊情緒模組會讀取情緒線索,再把它們帶到角色臉上,於是表情跟著音訊的情緒走,而不是一成不變。一張參考圖能引導這份情緒,意思是同一句台詞給不同參考,就能聽起來開心或嚴肅。看過僵硬虛擬人念稿的人都知道,就是這一塊讓成品活了起來。
Multi-Character Dialogue
多人模式讓好幾個人共用一個場景,各自由自己的音訊驅動,這正是早期模型難以分開處理的地方。一套臉部感知音訊轉接器會遮罩每張臉,讓某個角色的聲音不會竄到別人嘴裡。這把雙主持人播客或一來一往的訪談變成單一影片,而不必再拼兩段素材。這也是它勝過單純換臉工具的最大理由。
Multi-Style and Multi-Scale Characters
模型在寫實臉孔、插畫、3D 算圖與擬人角色上表現一致,所以風格化的吉祥物也能得到跟真人主播一樣的唇形與動態處理。它還能產出人像、上半身與全身等不同取景,這在單一說話頭不夠用時格外重要。輸入端少一點妥協,就代表你能保留專案的畫風,而不是遷就工具。
High-Dynamic Video Output
生成的短片在前景和背景都帶有動態,不只是把一張臉貼在靜止畫面上。角色會動、場景會變,成果最高能維持在 720p。代價是吃資源:高動態生成正是模型胃口大開、猛吃顯示卡記憶體的原因,所以最熱鬧的場景需要你手上最好的卡。
Open Code and Weights
推論程式碼與模型權重都公開釋出,依騰訊條款授權個人與商業使用。你可以在自己的硬體上執行全部流程、檢視它怎麼運作,並用自己的資料微調。這份開放對不想把臉孔與聲音送到第三方服務的團隊最為吸引,也是模型迅速在研究社群傳開的原因。
優缺點
優點
- 一張照片加一段音訊就夠,靜態圖片能取代一場實際演出。
- 音訊情緒模組讓角色帶著跟著聲音走的情緒,而不是固定表情。
- 多人支援讓每位說話者各用各的音訊,省下手動拼接素材的功夫。
- 模型能跑寫實、插畫、3D 與動物角色,你的畫風得以保留。
- 開源的程式碼與權重讓團隊在本機執行並微調,不必租用封閉服務。
缺點
- 自己跑需要一張 NVIDIA 顯示卡,而最高品質建議用 96GB 的卡,這把絕大多數消費級機器排除在外。
- 代管體驗頁把音訊限制在約 14 秒,做即時工作也偏慢,所以長片得靠本機環境。
- 在一般硬體上算圖很慢,因此沒有強力顯卡時,大型專案想快速交件並不實際。
- 開源版本沒有主打公開 API,開發者得自己打造服務層。
常見問題
HunyuanVideo-Avatar 是騰訊一款音訊驅動人體動畫的開源模型。它取一張人像圖片和一段音訊,產出角色唇形與表情對得上、會說話或唱歌的影片,還能處理場景裡多於一個角色。它出自騰訊混元與騰訊音樂天琴實驗室的 MuseV 團隊,於 2025 年 5 月推出。
相關內容
探索與 HunyuanVideo-Avatar 相關的工具、技能與文章。
HunyuanVideo-Avatar 替代方案

X Ray Interpreter
X-ray Interpreter · 圖片X Ray Interpreter 是一款以網頁為基礎的 AI 放射科工具,能把 X 光、電腦斷層、磁振造影、超音波與 PET 影像變成白話報告。你上傳一張掃描影像,片刻之間就得到初步的 X 光判讀結果,之後若有需要解釋的地方,還能繼續追問。它的定位是第二意見與學習輔助,而非醫療診斷。

Aieasypic
AIEasyPic · 圖片AIEasyPic 是一款 AI 圖片生成器,能在幾秒內把單純的文字提示變成完成的藝術作品。你也可以用自己照片訓練自訂模型、在現有圖片中替換臉部,並從文字建立短影片片段,全部都能在瀏覽器中完成。它適合想要快速視覺素材的休閒創作者,也適合想打造個人模型、又不想碰任何程式的業餘玩家。

Chargen
Chargen · 圖片Chargen 是一款 AI 角色生成器與世界觀建構工具,專為《龍與地下城》與其他桌上角色扮演遊戲打造。它能將一句構想變成手繪風格的肖像,在同一場工作階段中生出 NPC、怪物、地圖與遭遇,並把每隻生物的細節放在手邊。桌上角色扮演美術這部分靠一套名為 Gold 的點數系統運作,而文字生成器則對所有人保持免費。