
Kyutai TTS
Kyutai · 語音與語言
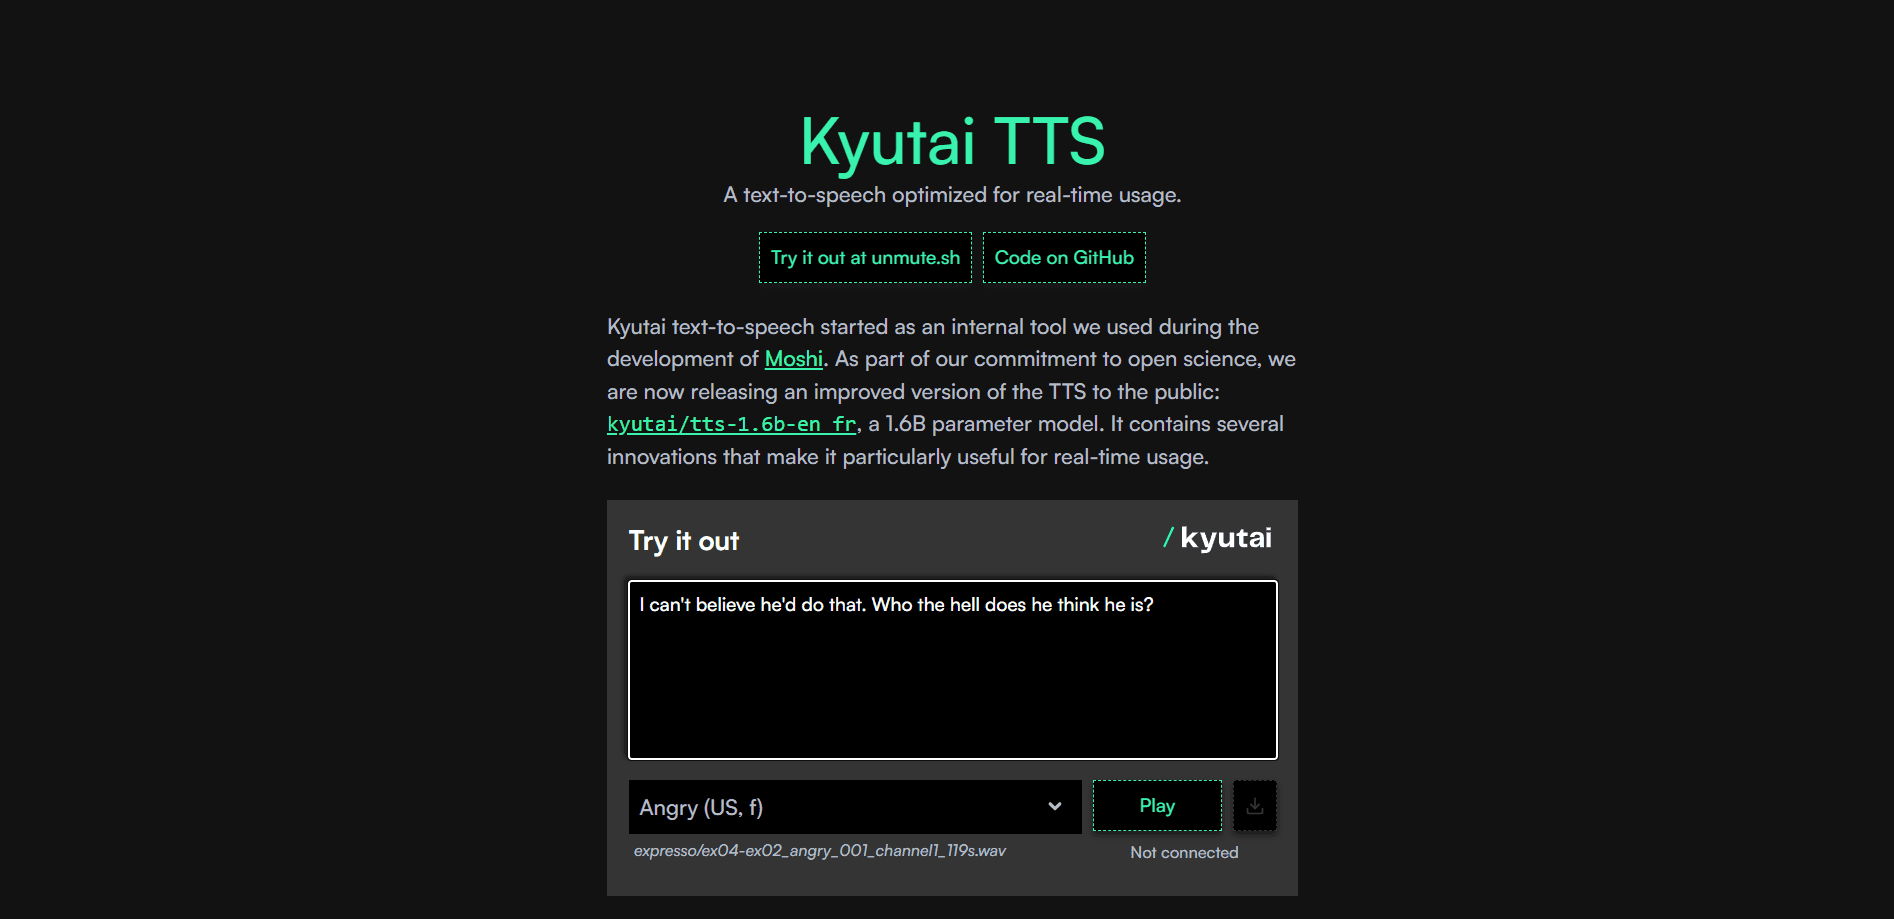
Kyutai TTS 是一款開源的串流文字轉語音模型,也是 Kyutai 旗下的 Kyutai 音訊模型之一,不必等到整段文字備妥就開始產生音訊,讓語音助理與即時應用的延遲維持在低檔。
關於 Kyutai TTS
About
什麼是 Kyutai TTS
Kyutai TTS 是一款為串流而設計的文字轉語音模型。它會把文字唸出來,但不會等你把整句打完。只要拿到開頭幾個字,它就開始說話,這一點把它和離線引擎區隔開來,後者非得拿到完整句子才會發出聲音。
Kyutai 是法國的一間開放科學實驗室,資金來自 Iliad 集團、CMA CM 集團與 Schmidt Sciences。實驗室為了自家的 Moshi 語音對話系統打造了 Kyutai TTS 1.6B,這是一款開源 TTS 模型,也是 Kyutai 旗下多款音訊模型之一,之後把權重公開釋出。這個版本瞄準低延遲語音合成,多數引擎得讀完整段文字才做得到。想找語音工具的人,可以用它做一個會說話的助理、產生旁白,或替應用加上語音,而且不用按字數付費。
關鍵在於它怎麼換來這種速度。模型以 250 萬小時的公開音訊訓練,在 GPU 上跑得最好,所以它不是一個月費標示清楚的即開即用雲端服務。你得下載權重、備好環境,自己動手執行。目前有兩個版本:這裡介紹的 1.6B 串流模型,以及較新的 Pocket TTS,一款為 CPU 機器打造的小型模型。
開始使用
- 註冊免費的 Hugging Face 帳號,並在 Kyutai TTS 頁面接受模型授權。
- 用 pip 安裝 moshi 這個 Python 套件,若要在正式環境提供服務則安裝 moshi-server。
- 在 Python 裡載入 checkpoint 與 Mimi 音訊編解碼器,再把模型指向一段文字提示。
- 以區塊方式產生音訊做串流播放,或直接對檔案執行取得離線輸出。
- 從 tts-voices 倉庫挑一個現成聲音,或提供自己的聲音向量。
產品資訊
快速了解 Kyutai TTS 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 打造語音助理的開發者:Kyutai TTS 支援串流輸出與低延遲,貼合互動式應用。你需要一張 GPU,還要熟悉 Python。
- 研究人員與學生:權重、論文與 Colab 筆記本都公開,你能研究或微調一款現代語音模型,不必買授權。
- 預算有限的獨立開發者:沒有按分鐘計費。你只付自己手上那台機器的成本,很適合個人專案與原型。
任務
- 即時口語回應:模型在文字還沒齊全前就開口,語音代理人聽起來不會卡頓。
- 為固定角色複製聲音:你可以用預先算好的聲音向量給助理一個穩定音色,不必重新訓練。
- 批次產生旁白:可以把一長串文字排進佇列讓模型產出音訊,因為它在單張 GPU 上批處理效率不錯。
情境
- 驅動對話式語音代理人:搭配語音轉文字模型與 LLM,讓助理聽、想、說形成自然的循環。
- 為應用加上無障礙功能:把書面內容轉成語音,給偏好用聽的使用者,文章與介面提示都涵蓋在內。
- 驗證多語產品:1.6B 模型會說英語與法語,你能先測試兩個市場再決定全面推出。
主要功能
串流輸出勝過離線 TTS
Kyutai TTS 一拿到提示的開頭幾個字就開始說話。離線引擎得等整段文字,白白多出好幾秒延遲。對語音助理來說,這個差距就是自然你來我往與尷尬停頓之間的分界。
立基於 delayed streams modeling
模型來自 Kyutai 對 delayed streams modeling 的研究,一套處理文字與語音之間串流任務的方法。它沿用 Moshi 的多串流架構,讓文字流與音訊流對齊,生成過程穩定又快速。
以向量複製聲音
只要餵入 tts-voices 倉庫裡預先算好的聲音向量,就能給模型指定音色。Kyutai 選擇這條路而非開放複製,有它的道理。官方指出開源模型的浮水印很容易被移除,把複製限制在既有向量上是比較安全的做法。
批次處理撐起高吞吐量
模型以請求為單位批次處理,不是一次應付一個聲音。Kyutai 公布每單位算力約可產生 75 倍音訊,訓練時也用了 CFG 蒸餾,引導輸出時不必把批次加倍。
英語與法語語音
1.6B 模型出廠就涵蓋英語與法語。相較某些商用引擎,這個範圍偏窄,但對雙語產品夠用,也讓模型小到能自己架設。
多種部署方式
模型有三種跑法。PyTorch 版本適合研究與實驗,Rust 伺服器透過 websocket 扛正式流量,量化版本則能在消費級機器上跑。
優缺點
優點
- 開放權重且授權寬鬆,沒有按字數計費這回事。
- 串流設計把延遲壓到足以應付即時對話。
- 在單張 GPU 上批次處理效率好,同時服務大量使用者時能壓低成本。
- 背後有已發表的論文、Colab 筆記本與聲音倉庫,不必從零起步。
缺點
- 沒有代管的 API,伺服器得自己架、自己維護。
- 建議搭 GPU,這排除了即時負載下的低價主機方案。
- 只支援英語與法語,其他語言得換別的模型。
- 聲音複製侷限在預先算好的向量,無法自由模仿。
常見問題
可以。模型權重以 CC-BY 4.0 釋出,你能免費下載與執行。要付的只是執行時所用的硬體。
相關內容
探索與 Kyutai TTS 相關的工具、技能與文章。
Kyutai TTS 替代方案

Foley
Hanamori Labs, LLC · 語音與語言 · 生產力 · AI 助理Foley 是一款語音待辦清單,把一句話變成歸檔好的任務,專案、日期與時間都先填好,接著再幫你依現有清單排出一整天的順序。

HireKey
HireKey · 語音與語言 · 生產力 · AI 學習HireKey 是由前科技業招募主管打造的 AI 求職副駕駛。它分析職缺契合度、客製化履歷、帶你練習面試,並把每份申請整理在同一處。

Fluence
Yay Software (Yannick Huchard) · 寫作 · 語音與語言 · 生產力Fluence 是 Android 上的文件閱讀器,能朗讀 PDF、EPUB、Word 檔與網路文章,逐句跟著語音標示,並在手機上直接回答你對內容的提問。