
Middleware Observability Platform
Middleware · 程式設計
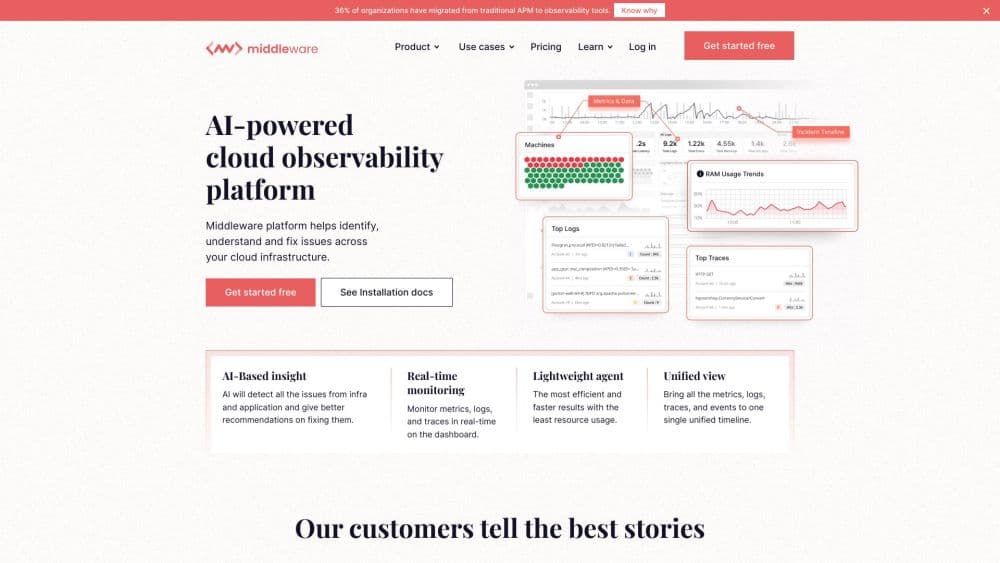
Middleware 是雲端可觀測性平台,把日誌、指標、追蹤與真實使用者的工作階段收在同一條時間軸上,再由 AI 代理找出事故根因並提出修正建議。
關於 Middleware Observability Platform
About
Middleware 是什麼
Middleware Observability Platform 是一套雲端監控服務,服務對象是在 Kubernetes、虛擬機與托管資料庫上跑應用程式的工程團隊。你不必分開購買指標工具、日誌工具與應用程式效能監控工具,只要安裝一個代理程式,全部資訊就出現在同一個畫面。事情出錯時,這條共用時間軸特別管用:一支變慢的 API 呼叫、一行錯誤日誌、一段使用者工作階段的重播,會因為同一個請求脈絡並排顯示。
背後的公司是同名的 Middleware,2022 年由待過 Netflix、DigitalOcean、Google 與 Cisco 的工程師創立。資料透過主機代理程式、各語言 SDK 與第三方整合進來,平台也支援 OpenTelemetry,你手上既有的收集器與代理程式不用整批換掉就能餵資料。計價按用量計算,賣點是整體持有成本,而不是一份給採購部門看的功能清單。
限制最好一開始就弄清楚。它是託管服務,除非加購自帶雲端,資料會離開你的網路。深度的合規流程與長天數保留屬於客製合約。AI 代理比核心監控晚上線,變更管制嚴格的團隊,應該先看過自動建立 pull request 這項功能再決定要不要開。
開始使用
- 到 app.middleware.io 建立帳號,可用 Google、GitHub、電子郵件、Okta SSO 或 Microsoft Entra ID 登入。
- 打開安裝頁面,複製專案對應的 MW_API_KEY 與 MW_TARGET。
- 挑選你的環境:Kubernetes DaemonSet、Linux 主機代理程式、Java/Python/Node.js 等語言的 SDK,或 AWS、Azure、Prometheus、Datadog 等整合。
- 部署代理程式,確認幾分鐘內資料就進到儀表板。
- 針對團隊在意的訊號建立檢視與告警,再開啟 OpsAI 偵測,補上沒有寫規則的異常。
產品資訊
快速了解 Middleware Observability Platform 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- DevOps 與 SRE 團隊:基礎設施、容器、應用程式追蹤與日誌都在同一個地方,事故當下要開的分頁少很多。前提是團隊裡得有人熟悉自家架構,訊號才讀得準。
- 預算有限的初創團隊:按用量計價,加上可用到 100 GB 資料的免費方案,對簽不起六位數監控合約的小團隊來說比較實際。
- 正在做 LLM 功能的後端開發者:Token 用量、延遲與每次提示的成本和一般追蹤放在一起,某支 AI 端點悄悄變貴時,會跟其他服務一樣出現在同一個畫面。
任務
- 找出慢速端點的原因:追蹤、關聯日誌與基礎設施指標排在同一條時間軸,你可以從出問題的請求往回推,不必先猜該查哪個系統。
- 維持 Kubernetes 叢集健康:叢集儀表板、CRD 監控與容器指標,讓你在節點開始驅逐 Pod 之前就看到它過熱。
- 觀察資料庫查詢:MySQL、PostgreSQL、MongoDB、Cassandra 與 Aurora 的逐筆查詢分析,指出哪些語句吃掉 CPU、慢查詢從哪裡來。
- 從外部確認 API 是否可用:合成檢查依排程發出 HTTP、UDP、DNS 與 WebSocket 請求,比使用者更早知道問題。
情境
- 凌晨兩點的正式環境事故:告警響起時,時間軸上已經有失敗的追蹤與相關錯誤日誌,OpsAI 會指出可能的原因並附上程式碼變更。
- 上線週的流量高峰:真實使用者監控顯示行動端哪裡變慢,基礎設施儀表板則說明瓶頸在應用程式、資料庫還是節點。
- 每月成本檢視:日誌按寫入的 GB 計價,雜訊來源能在管線階段就丟掉,帳單因此只跟真正搜尋的量連動。
主要功能
OpsAI 偵測與修復代理
OpsAI 同時監看應用程式、基礎設施、資料庫、容器、日誌與 LLM 專案,再把這些訊號互相對照。價值在告警之後那一步:它指出可能根因、提出修正,還能開一張 pull request 附上變更。錯誤偵測本身不收費,根因分析按 Token 計價,因此你可以保留告警,又不必每個事故都跑 AI。
應用程式效能監控
APM 模組即時記錄追蹤,並跟著一筆請求從 API 端點一路走到它碰到的資料庫。連續剖析顯示哪個函式在燒 CPU,這跟慢速追蹤回答的是不同問題:追蹤告訴你時間花在哪,剖析告訴你哪段程式碼花掉的。流量地圖與相依性檢視則是在對非工程背景的人說明故障時派得上用場。
搭配 QueryGenie 的日誌監控
日誌可以從任何 JSON 來源進來,你不必先改格式再送出。搜尋支援屬性比對、模糊比對與正規表示式,部署期間也能暫停與恢復即時檢視。QueryGenie 把一句自然語言轉成查詢,對不常寫結構化查詢的人幫助不小。敏感資料遮蔽與自訂屬性擷取在入庫前完成,日誌帶著客戶資料時這一點特別重要。
基礎設施與 Kubernetes 監控
基礎設施監控與 Kubernetes 監控共用同一套代理程式。自動 instrumentation 涵蓋主機、Kubernetes 叢集、Linux 節點與雲端服務,不必每台機器寫腳本。叢集健康、CRD 與網路策略收在同一份檢視,容器化工作負載還有 ECS 層級的細節。把 CPU 飆高和它造成的延遲對起來,是這套產品原本就為之設計的流程,也是團隊最先有感覺的部分。
真實使用者監控與工作階段重播
真實使用者監控記錄網站與行動應用程式訪客實際遇到的情況,並把一次緩慢的頁面載入接到造成它的後端追蹤。工作階段重播讓你一邊看操作畫面、一邊對照網路資料,不用請使用者描述他看到了什麼。隱私控制會將欄位匿名化並限制擷取範圍,在持有個資的產品裡也還用得住。
合成測試與瀏覽器測試
合成檢查從多個地點依排程發出 HTTP、UDP、DNS 與 WebSocket 請求,附上完整的請求與回應內容。瀏覽器測試則腳本化一段使用者旅程,例如登入後結帳,並在多種瀏覽器與裝置設定檔上執行。兩者合起來補上伺服器端監控看不到的缺口:服務從外面到底連不連得上、能不能用。
資料庫與 LLM 可觀測性
資料庫監控深入到 MySQL、PostgreSQL、MongoDB、Cassandra 與 Aurora 的逐筆查詢,把 CPU、記憶體、磁碟與吞吐量和查詢一起看。LLM 模組追蹤提示、代理與多步驟流程的延遲、Token 用量、成本、回應品質與錯誤,並把一次昂貴或失敗的 AI 呼叫接回產生它的追蹤與工作階段。
優缺點
優點
- 一個代理程式、一個畫面涵蓋日誌、指標、追蹤、基礎設施、真實使用者監控、合成測試與 LLM 資料,事故當中不用換工具。
- 以 OpenTelemetry 為基礎的收集方式,既有收集器、Datadog 代理程式與 Prometheus 設定都能直接餵資料,不必拆掉現有架構。
- 按用量計價,免費方案提供 100 GB 資料與不限人數,成本跟著遙測量走,而不是跟著人數走。
- 資料管線可在入庫前丟掉吵雜的日誌來源,帳單與搜尋結果同時受到控制。
- OpsAI 的錯誤偵測免費,建議的程式碼變更走 pull request,審查者仍然握有決定權。
缺點
- 屬於託管平台,除非以客製合約加購自帶雲端,資料會離開你的網路。
- 免費方案只保留 14 天資料,按用量方案預設 30 天;需要在稽核後回看一整年的團隊會覺得不夠。
- 自動修復與程式碼建議在受監管環境裡有實際風險,許多團隊初期會選擇關閉。
- LLM 可觀測性比核心 APM 與日誌晚上線,深度整合的數量預期會少於耕耘更久的競品。
常見問題
Middleware 監控基礎設施、容器、Kubernetes、應用程式追蹤、日誌、資料庫、真實使用者工作階段、合成檢查與 LLM 應用程式。全部落在同一條時間軸上,以請求脈絡串起來,你可以從使用者的抱怨一路查到真正造成問題的那筆查詢。
相關內容
探索與 Middleware Observability Platform 相關的工具、技能與文章。
Middleware Observability Platform 替代方案

Base Code
Base44 (Wix) · 程式設計 · 生產力Base Code 是 Base44 推出的共享雲端開發環境。團隊在對話中描述對既有 GitHub 儲存庫的修改,看著預覽確認結果,再以 Pull Request 交回工程團隊。

Google EmbeddingGemma 2
Google DeepMind · 寫作 · 圖片 · 程式設計Google EmbeddingGemma 2 是 7.4 億參數的開源模型,能把文字、程式碼、圖片、音訊與影片畫面轉成同一個 768 維空間裡的向量,在手機與筆電上就能執行。

GitGlow
GitGlow · 程式設計 · 生產力GitGlow 是桌面版 Git 用戶端,把你自己的程式碼與 AI 代理程式的變更集中在同一份審查裡,讓你在交付前看清楚機器上究竟要送出什麼。