
Polarity
Polarity · 程式設計
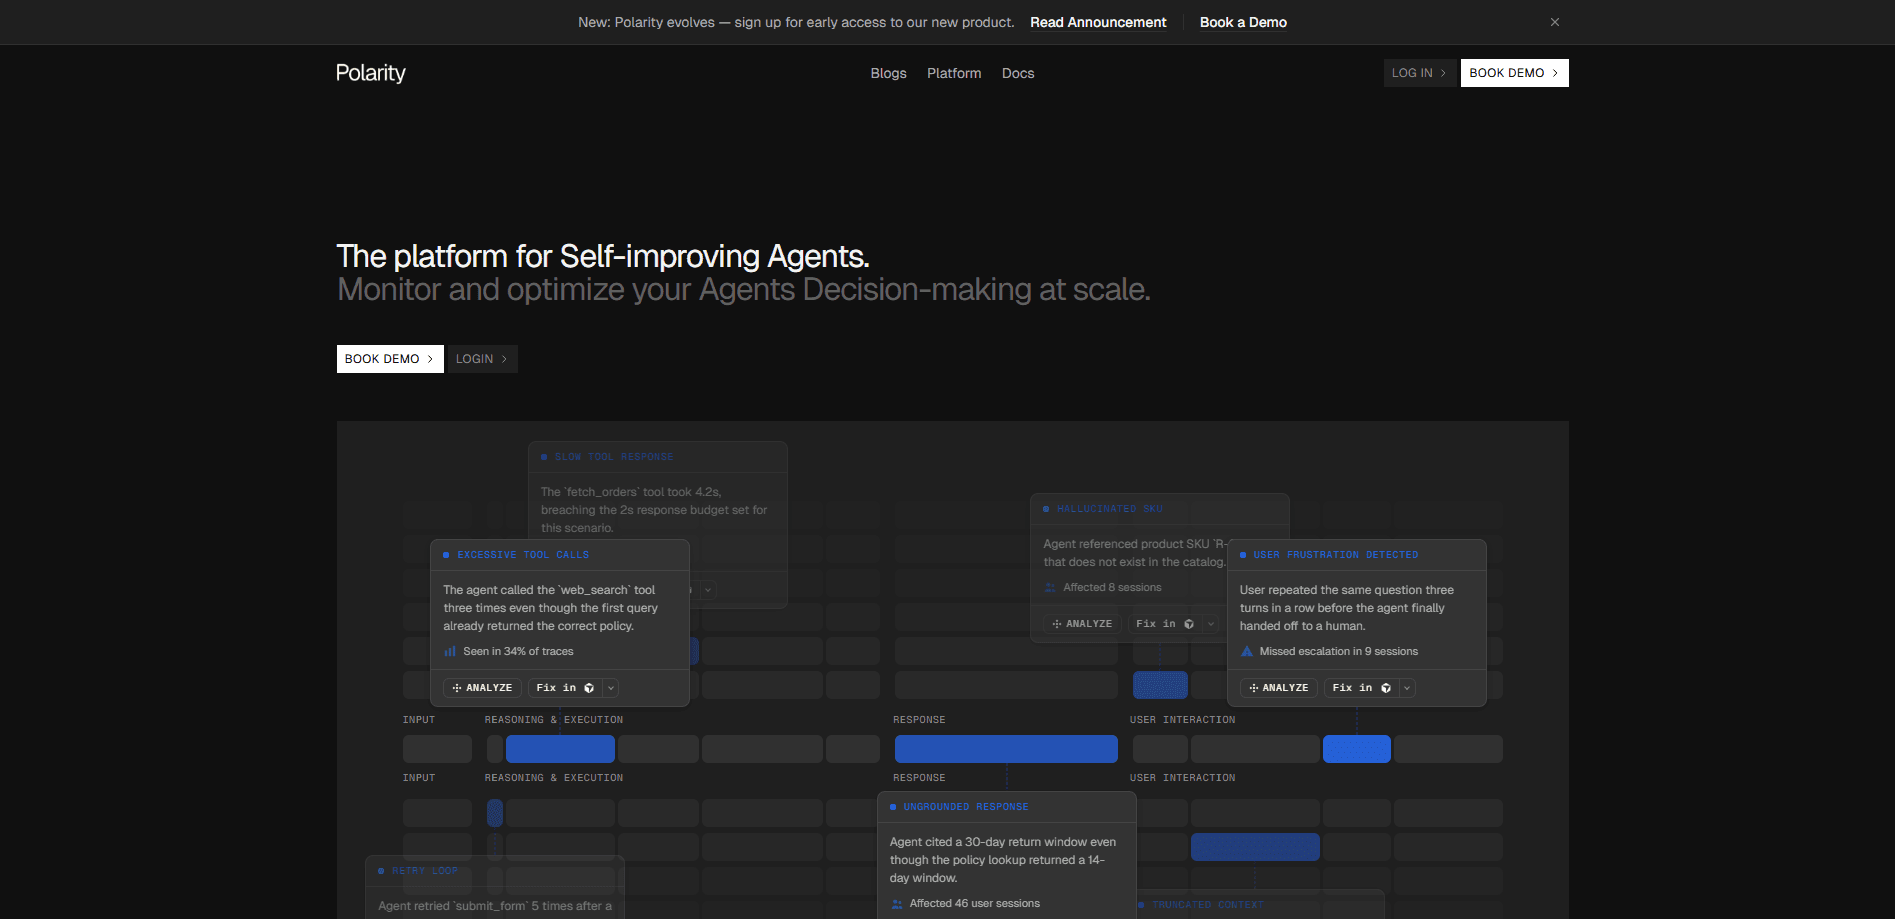
Polarity 是一個針對 AI 代理的沙箱式評估與監控平台。它會在隔離的 Docker 環境中執行你的代理,並接上真實的後端服務,依據不變條件與禁止規則為代理的行為評分,同時衡量它的行為在反覆執行之間有多少變動。把它想成一款代理評估工具,把實際行為當成測試本身。當某次執行失敗時,基於種子的重現能讓你重建當時的確切條件並除錯,而不是靠猜測。
關於 Polarity
Polarity 是什麼
Polarity 是一套為出貨 AI 代理的團隊打造的評估平台。它不用寫好的模擬腳本測試代理,而是在接上真實後端服務的 Docker 沙箱中執行代理,讓代理看到與正式環境相同的 API、資料庫與工具。這樣的設定很重要,因為多數代理出錯並非來自一個糟糕的回答。問題出在代理做了沒有人希望它做的動作。
平台同時檢查兩件事。第一,每次執行是否遵守你設定的規則,Polarity 把規則分成必須永遠成立的不變條件,以及絕對不能觸發的禁止規則。第二,行為有多穩定。把同一個任務跑在多個複本上,會浮現單次通過完全掩蓋掉的不確定性。這個區別很重要,因為一個這次通過、下次失敗的代理,正是那種在所有人停止盯著它之後悄悄弄壞正式環境的類型。
主要的限制在於適用範圍。Polarity 是開發者工具,不是消費級應用,所以你必須先把代理打包好,並讓沙箱能連到後端服務,才會得到價值。還沒有自動化測試架構的團隊,前幾天會花在接線設定上。
開始使用
- 登入 Polarity 網站,為你想評估的代理建立一個專案。
- 把專案指向你的代理,並定義它需要的後端服務,讓沙箱啟動時帶著與正式環境相同的相依項目。
- 把你的不變條件與禁止規則寫成每次執行都要被評分的檢查項目。
- 在一個或多個複本上執行任務,看看行為是保持穩定,還是每次嘗試之間產生偏移。
- 打開任何失敗案例,從它的種子重現,並在上線前修掉根本原因。
產品資訊
快速了解 Polarity 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- AI 工程團隊:當你已經在正式環境運行代理,且需要可重複的方式在使用者之前抓到回歸問題時很實用。
- 平台與基礎架構工程師:適合樂於定義服務、規則與沙箱設定,而不是點著精靈一步步走的團隊。
- QA 與可靠性負責人:適合任何必須證明代理明天表現和今天一樣的人。
任務
- 為代理行為評分:把「感覺代理沒問題」轉換成每次執行都必須滿足的明確不變條件與禁止規則。
- 抓出不確定性:複本執行會暴露單次成功通過所掩蓋的變異。
- 為失敗除錯:基於種子的重現會重建失敗的那次執行,讓你能追出真正出錯的地方。
- 上線前的代理回歸測試:在提示或模型變更後重跑你的規則集,看看什麼壞掉了。
情境
- 把新代理推上正式環境:在真實使用者碰到它之前,先給你代理遵守界線的證據。
- 為代理的間歇性失敗除錯:重現那一次確切失敗的執行,而不是手動重做一次。
- 換模型後稽核代理:重跑整套測試,並比較兩個版本的行為。
主要功能
搭配真實服務的沙箱執行
Polarity 在給 AI 代理用的 Docker 沙箱中執行每個代理任務,而不是在模擬的測試台上。沙箱接上真實的後端服務,所以代理在評估期間會與真正的 API 和資料儲存互動。這表示你評分的行為更接近使用者實際會遇到的狀況。
不變條件與禁止規則評分
每次執行都會依兩種規則評分。不變條件描述每次執行都必須成立的狀況,而禁止規則列出絕對不能發生的動作。把它們寫下來會逼團隊對「正確」的定義達成一致,而這往往才是更難的部分。
不確定性衡量
代理不會每次都表現得一模一樣,單次通過能證明的東西少之又少。Polarity 把同一個任務跑在多個複本上並比較結果,讓你看見代理在嘗試之間偏移多少。高變異通常是一段脆弱提示或不穩定工具的第一個徵兆。
基於種子的重現
當某次執行失敗時,Polarity 可以從它原本的種子重現。重現會重建產生該失敗的相同條件,把一個間歇性 bug 變成你能檢視、修正與驗證的東西。對習慣手動追查不穩定代理的團隊來說,這是省下最多時間的功能。
為已部署代理提供的監控
評估不會在程式碼審查就結束。代理開始運行後,Polarity 也會負責 AI 代理監控,用你在測試時使用的同一套規則為實際行為評分。你會在正式環境抓到規則違反,而不是從使用者那裡聽說。
優缺點
優點
- 沙箱中的真實服務讓評分反映正式環境行為,而不是簡化過的模擬。
- 不變條件與禁止規則評分為正確行為給出清楚且可測試的定義。
- 複本執行讓不確定性變得可見,這是多數單次評估工具會漏掉的。
- 基於種子的重現縮短了間歇性失敗的除錯循環。
- 監控把同一套規則從測試延伸到正式環境。
缺點
- 沒有免費方案,價格也未公開,所以你得先聯絡業務才能判斷成本。
- 它是開發者工具,所以能否得到價值取決於你的代理與服務是否已打包成可在沙箱中運行。
- 相較於以模擬為基礎的評估工具,儲存並運行真實後端服務會拉高設定工作量與基礎架構成本。
- 對只想要快速展示的團隊來說並不理想。Polarity 預設你已經在做測試。
常見問題
它評估並監控 AI 代理。你定義規則,Polarity 在搭配真實服務的 Docker 沙箱中執行你的代理,依據那些規則為每次執行評分,並讓你重現失敗案例。那這樣能帶給你什麼?代理上線時少一點意外。
相關內容
探索與 Polarity 相關的工具、技能與文章。
Polarity 替代方案
Forefront
Forefront · 程式設計Forefront 是一個用來打造開源 AI 的網頁平台。你可以用自己的資料微調主流的開源語言模型、評估它們的表現,再透過 API 執行,或匯出後自行架設。想要封閉式平台的便利、卻堅持要自己擁有模型與資料的開發者,就是這裡的目標客群。

Startkit
StartKit.AI · 程式設計Startkit 是一套用來打造 AI SaaS 與 AI 包裝產品的樣板。可以把它想成一個 AI 新創樣板,把枯燥的部分都先接好了:驗證、Stripe 與 Lemon Squeezy 付款、用量限制、交易型電子郵件,以及一套能與 OpenAI、Anthropic、Groq 或 Llama 溝通的 AI API 啟動套件。你複製儲存庫、設定價格,然後專心在產品中使用者真正願意付費的部分。它建構於 React 與 Tailwind 之上的 Next.js,所以大部分的樣板程式碼對你來說並不陌生。
Testim
Tricentis · 程式設計Testim 是專為網頁、行動與 Salesforce 應用程式打造的 AI 測試自動化平台,用來建立並執行端到端測試。它靠機器學習在介面變動時維持測試穩定,團隊因此少花時間修補壞掉的定位器。對於一款今天就能開始使用的自動化測試工具來說,這表現不算差。你透過在瀏覽器錄製動作來建立測試,需要更多控制時再補上 JavaScript。對忙碌的 QA 團隊來說,這是個可靠的選擇。