
Reference To Video
Reference To Video · 圖片 · 影片
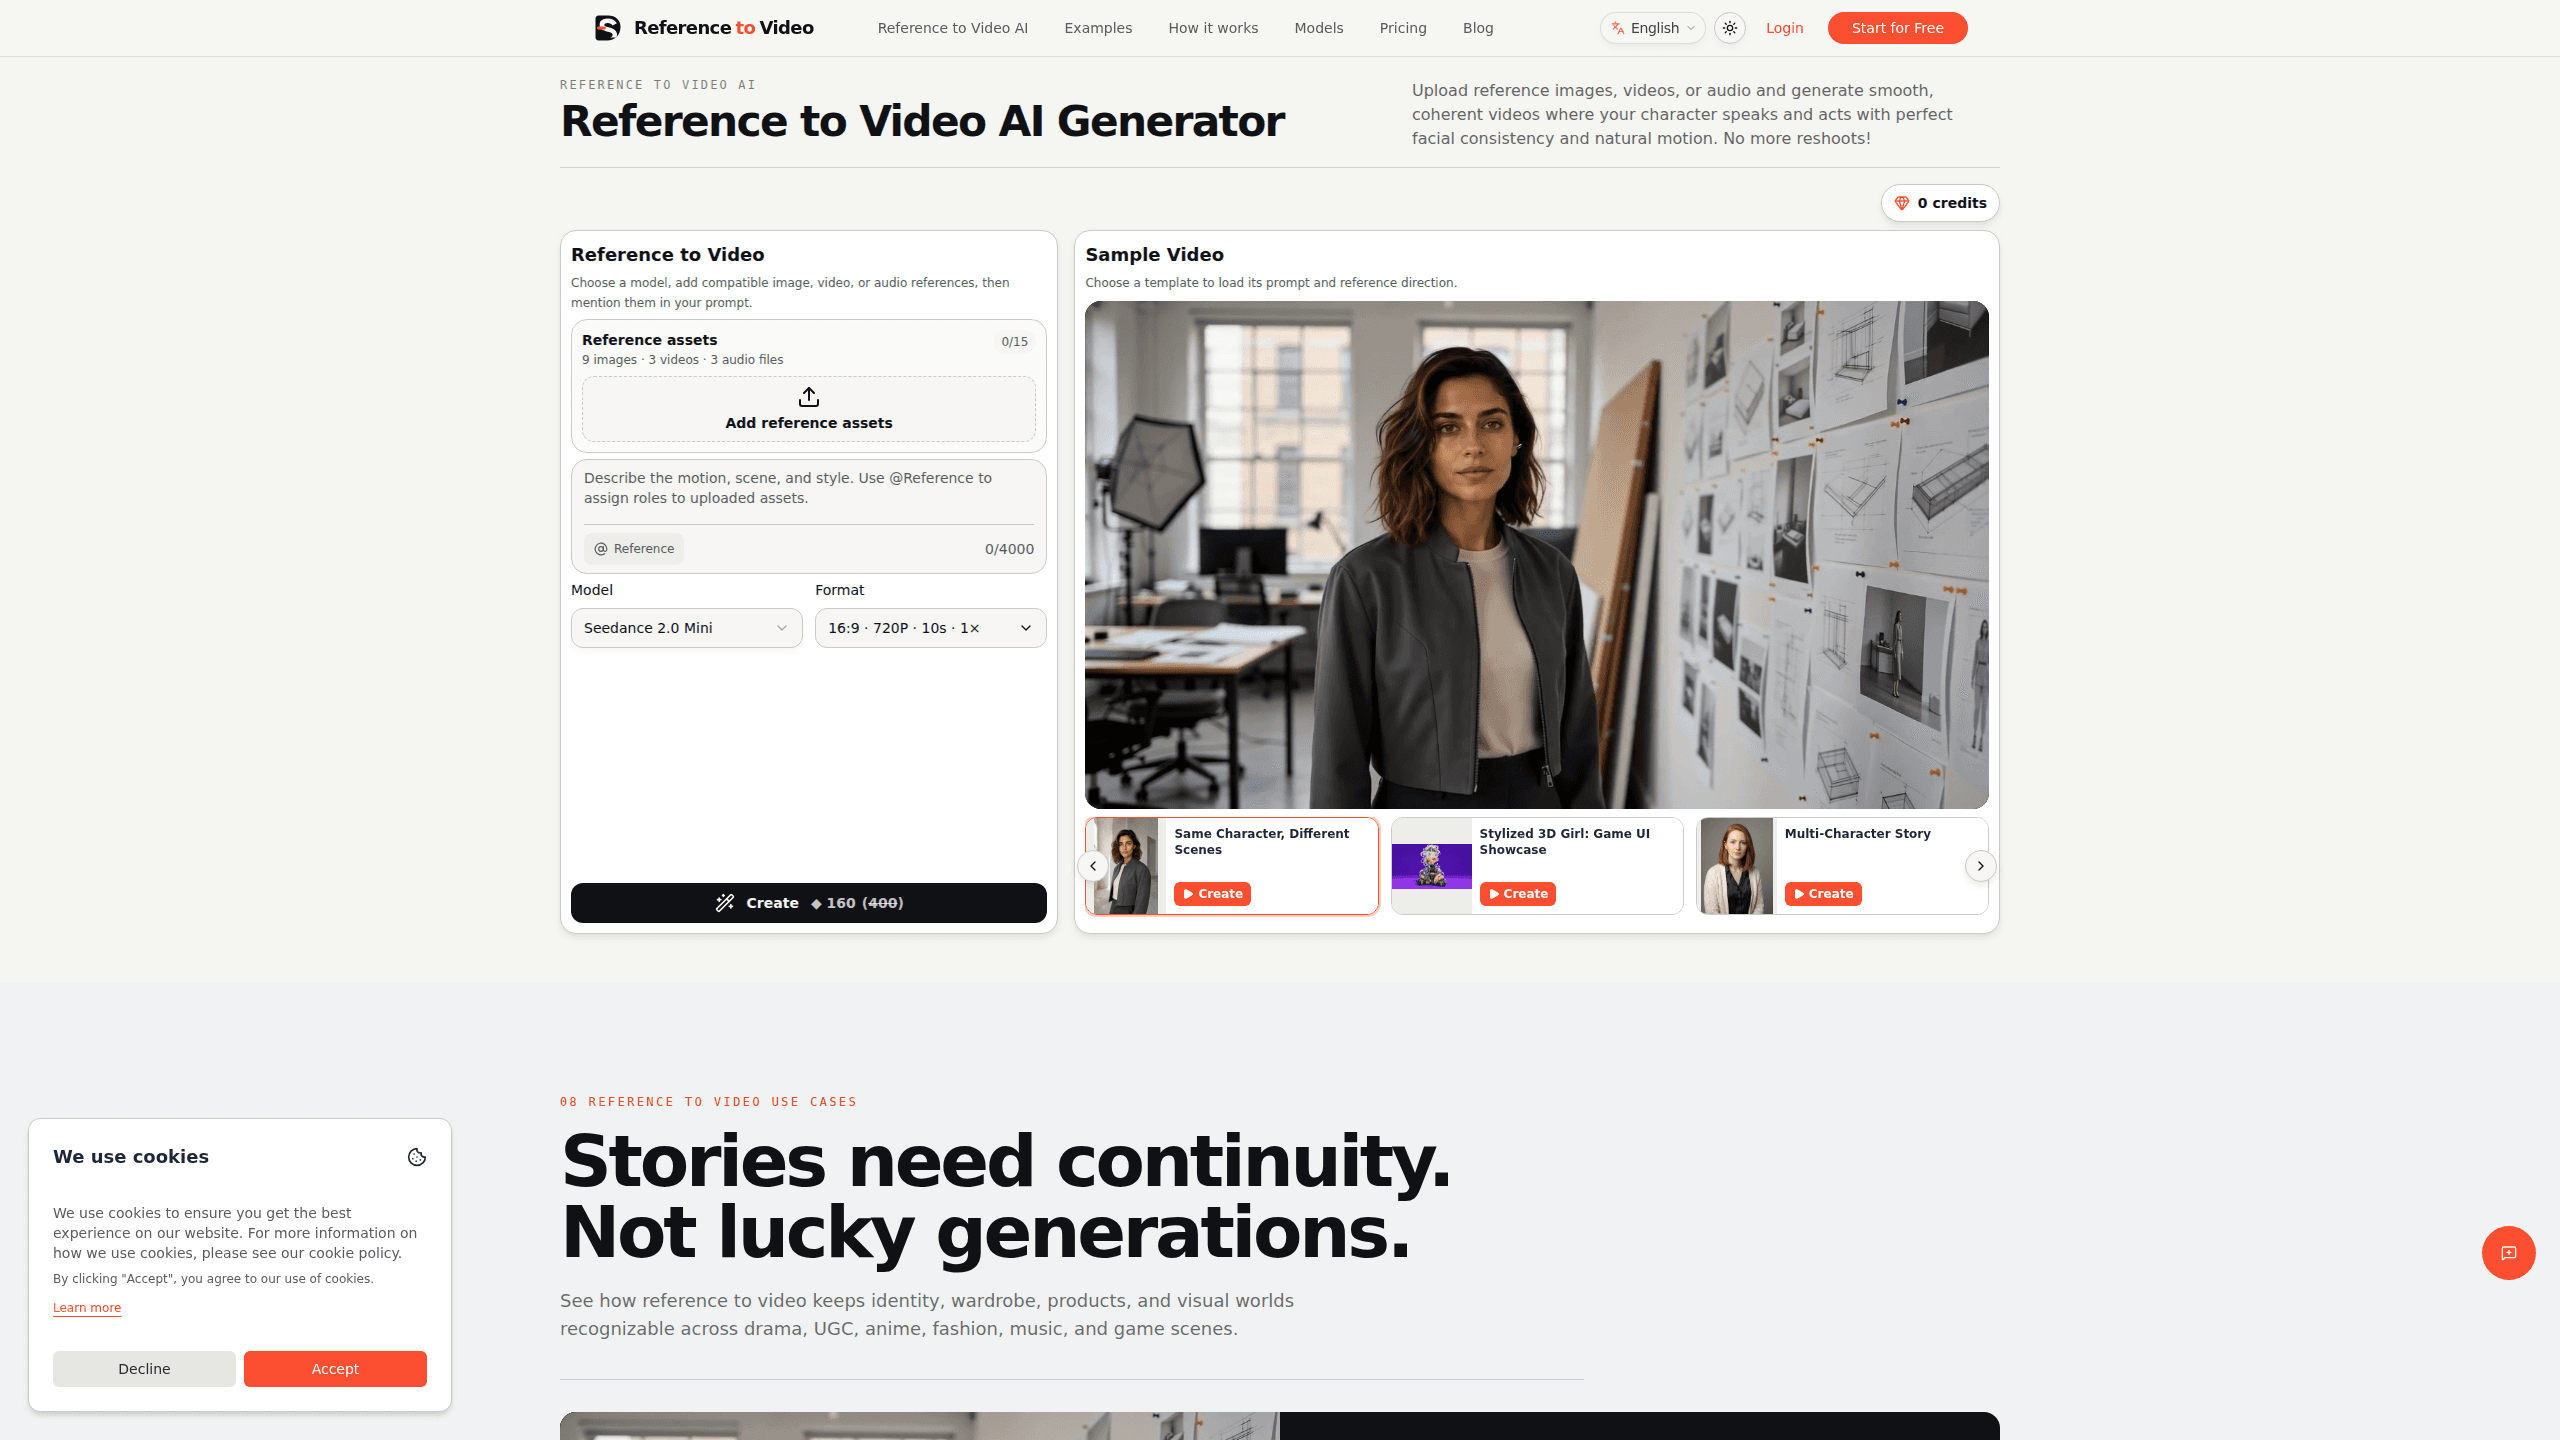
Reference To Video 是一款 AI 影片生成器,會用你餵給它的參考素材打造新鏡頭。它本質上是圖片轉影片的 AI 工具,但走得比這個標籤所暗示的更遠。你不必輸入一段長提示詞、再祈禱模型記得某張臉、某個產品或某個運鏡,而是上傳一張圖片、一段短影片或一段音訊,讓每個來源各定義結果的一部分。角色圖片鎖定外觀,影片參考帶入動作與鏡頭語言,音軌則決定聲音與節奏。這正是角色一致的 AI 影片真正需要的东西。它的目標客群是連載影集創作者、AI 網紅、產品團隊,以及把跨鏡頭連續性視為核心的動畫或時尚流程。
關於 Reference To Video
Reference To Video 是什麼
Reference To Video 是一套網頁式的 AI 影片生成流程,建立在一個想法上:來源素材應該是創作上的證據,而不只是靈感。一般圖片轉影片工具把每次生成都當成全新開始,於是臉會飄移、外套會變樣,或產品標籤跳到畫面的錯邊。這款工具則把這些細節固定住,同時讓場景、動作與取景改變。
產品依功能把參考素材分組。角色身分涵蓋臉部、髮型與身體比例。產品外觀涵蓋形狀、顏色、材質與包裝。一段短影片負責動作、演出節奏與鏡頭方向。場景與風格參考則把地點、光線語言或色調帶進新鏡頭。音訊參考在接受它的模型上引導對白、聲音、音樂與節拍時序。
最重要的限制是模型相依性。Reference To Video 位在 Seedance 2.0、MiniMax H3 等第三方模型前面,而每個模型接受的參考組合都不同。介面只顯示所選模型真正能用的控制項,所以你在某次工作階段能做的事,未必能搬到另一次。它也不是畫面格完美連續的保證,官網自己也這麼說。
開始使用
- 打開 referencetovideo.net,挑選你想用的模型,因為可用的參考欄位會隨模型改變。
- 上傳你的參考素材。從最小而有用的一組開始:一張圖片負責外觀、一段短影片負責動作,只有當聲音對鏡頭重要時才加上音訊。
- 在簡報中給每個參考素材一個明確任務,讓模型知道哪些必須保持可辨識、哪些可以改變。
- 為新鏡頭寫提示詞:主體動作、鏡頭運動、場景、時序,以及各參考素材該如何結合。
- 生成、檢視輸出,然後調整提示詞或替換參考素材,直到鏡頭站得住腳。
產品資訊
快速了解 Reference To Video 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 連載影集與短劇創作者:當同一個角色得在街道、咖啡館與屋頂出現而不換臉時很有用。需要一張乾淨的角色圖片來錨定身分。
- UGC 與電商團隊:為產品廣告而打造,瓶身、盒子或標籤在每個剪接都得一模一樣。當產品參考是在素色背景上拍攝時效果最好。
- 動畫、VTuber 與原創角色創作者:在場景或姿勢改變時,讓風格化設計保持一致。要求一張能清楚呈現角色的參考圖片。
- 時尚與 AI 網紅團隊:在一連串造型中保護服裝的身分。條件是:你選的模型必須接受影片參考來處理動作。
任務
- 把靜態角色設定表變成動態鏡頭:圖片守住臉部,影片參考提供手勢與節奏。
- 重現難以描述的運鏡:拿一段環繞、推近或手持片段當參考,而不是用文字寫出鏡頭指示。
- 讓演出者對上音軌:音訊參考設定對白、音樂與節拍時序,讓動作落在拍點上。
- 建立彼此串連的產品宣傳:一張產品圖片重複用在許多新場景,維持包裝一致。
情境
- 製作某個常態影集的下一集:同一批卡司在新地點回歸,不必重拍。
- 為單一產品推出季節廣告變化版:改變場景,同時讓品項保持可辨識。
- 草擬音樂影片的段落:演出者參考與音訊參考一起驅動動作與節奏。
- 在投入完整製作前,先在新場景測試吉祥物或風格化的品牌角色。
主要功能
以參考為先的生成
每個來源都被當成製作決策,而不是風格提示。圖片定義外觀、影片定義動作、音訊定義聲音,所以每個上傳都有單一明確任務。這正是它與純文字轉影片工具的分野,後者得靠一段提示詞同時扛起臉、服裝、運鏡與節拍。
角色身分控制
當你把角色移進新場景時,臉部、髮型、身體比例與獨特特徵仍保持可辨識。你把一張角色圖片交給工具,描述新的場景與動作,然後期待這個人看起來還是同一個人。如果參考圖片模糊、太小或角度怪異,這招就行不通。
產品外觀控制
產品的形狀、顏色、材質、包裝與標籤位置都會帶進新鏡頭。對宣傳工作來說,這比臉部一致性更重要,因為顏色錯了的瓶子會毀掉整支廣告。工具在環境於周遭改變時保住品項。先在上市鏡頭上試試。
來自影片的動作與鏡頭方向
一段短影片能驅動手勢、時序、身體動作與演出能量。它也能帶入真正難以描述的鏡頭行為。拿平移、環繞或手持動作當參考,通常比把這些指示寫出來更有效。文字在這裡很弱。一段兩秒片段勝出。
場景、風格與音訊參考
你可以把地點、光線語言、色調或視覺世界帶進新組成的鏡頭,而在接受音訊的模型上,引導對白、聲音、音樂、節拍與動作時序。把場景參考與音訊參考結合,能讓一段影片同時繼承它的外觀與節奏。
兩種多模態流程
官網把工作分成圖片加影片流程,以及圖片加影片加音訊流程,這是多模態影片生成在實務上的清楚範例。圖片錨定外觀,影片引導動作與鏡頭,當簡報需要時音訊負責聲音與同步。Seedance 2.0 以 720P 處理要求較高的多參考任務,MiniMax H3 則負責有音訊支援的 768P 路徑。挑選時把簡報放在心上。
依模型調整的控制項
因為模型能力會變動,生成器只顯示所選模型支援的設定。這讓你不用去設定模型根本用不了的音訊欄位。取捨是真實的:同一組參考在換模型後行為可能不同,所以在建立簡報前先選好模型。
優缺點
優點
- 參考素材在整個鏡頭中持續有效,而不是在前幾格之後就淡掉。
- 每個輸入都有明確角色,讓結果更容易檢視與修正。
- 把外觀、動作與音訊分開,比單一文字提示詞有更多控制權。
- 運鏡可以向影片參考借用,而不必用文字描述。
- 介面會隱藏不支援的控制項,你不會跟毫無作用的設定纏鬥。
缺點
- 輸出品質與可用參考欄位取決於模型,所以同一工作階段內的結果並不一致。
- 它不會逐格複製來源,這可能讓期待精確連續性的人失望。
- 價格與方案細節不公開在網頁上,你得進 App 內查看。
- 官網表示 API 存取並無文件說明,這擋住了想把生成寫成腳本的團隊。
常見問題
它用你上傳的參考素材生成新的 AI 影片鏡頭。圖片、影片或音訊片段各定義結果中一個特定部分,你再據此描述新場景。重點是跨鏡頭的連續性,不必大量剪輯。
相關內容
探索與 Reference To Video 相關的工具、技能與文章。
Reference To Video 替代方案

X Ray Interpreter
X-ray Interpreter · 圖片X Ray Interpreter 是一款以網頁為基礎的 AI 放射科工具,能把 X 光、電腦斷層、磁振造影、超音波與 PET 影像變成白話報告。你上傳一張掃描影像,片刻之間就得到初步的 X 光判讀結果,之後若有需要解釋的地方,還能繼續追問。它的定位是第二意見與學習輔助,而非醫療診斷。

Aieasypic
AIEasyPic · 圖片AIEasyPic 是一款 AI 圖片生成器,能在幾秒內把單純的文字提示變成完成的藝術作品。你也可以用自己照片訓練自訂模型、在現有圖片中替換臉部,並從文字建立短影片片段,全部都能在瀏覽器中完成。它適合想要快速視覺素材的休閒創作者,也適合想打造個人模型、又不想碰任何程式的業餘玩家。
Chargen
Chargen · 圖片Chargen 是一款 AI 角色生成器與世界觀建構工具,專為《龍與地下城》與其他桌上角色扮演遊戲打造。它能將一句構想變成手繪風格的肖像,在同一場工作階段中生出 NPC、怪物、地圖與遭遇,並把每隻生物的細節放在手邊。桌上角色扮演美術這部分靠一套名為 Gold 的點數系統運作,而文字生成器則對所有人保持免費。