
Reflection 70B
HyperWrite · 寫作 · 聊天機器人
Reflection 70B 是 HyperWrite 的權重開放模型。以 Llama 3.1 70B 為基礎,這個可自我修正的 LLM 會在回答前檢查自己的推理。
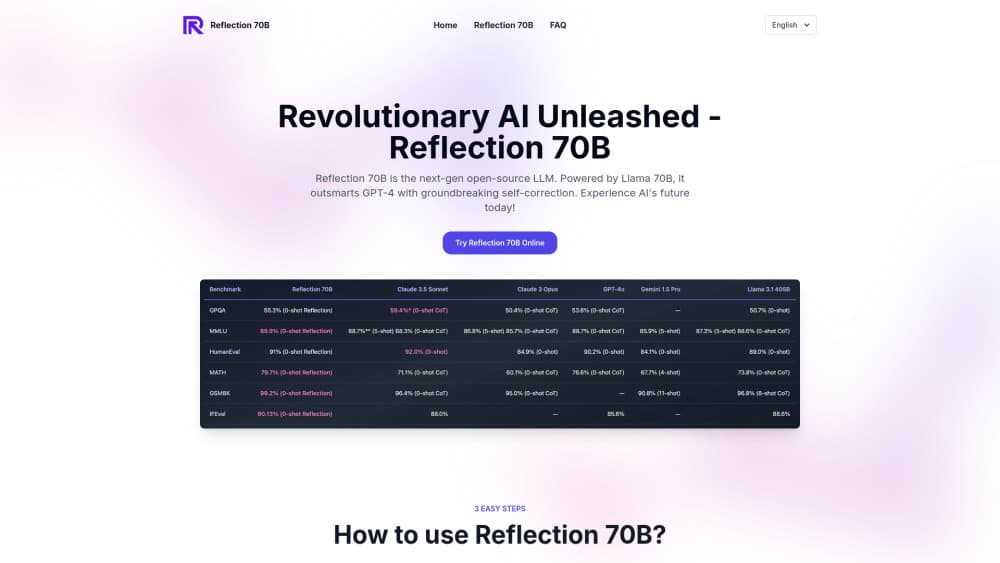
關於 Reflection 70B
什麼是 Reflection 70B
Reflection 70B 是 HyperWrite 推出的推理導向語言模型,於 2024 年 9 月初發布,建立在 Meta 的 Llama 3.1 70B Instruct 之上。它的賣點是一套叫 Reflection-Tuning 的訓練方法,教模型在定下最終答案前,先找出自己思維鏈裡的錯誤並修正。模型把思考內容寫進 <thinking> 標籤,把最終答案寫進 <output> 標籤,只要推理途中抓到錯誤,就補上一段 <reflection> 區塊。
這個想法瞄準了一個真實痛點。一般 LLM 會胡編亂造,卻很少察覺自己在胡編。Reflection 70B 被訓練成會察覺。根據 HyperWrite 的說法,這個模型在 MMLU、MATH、IFEval 與 GSM8K 等評測上擊敗了 GPT-4o,甚至勝過 Llama 3.1 405B。這些數字在發布時引來極大關注。
那股初期熱潮沒能撐過第三方檢驗。包括 Artificial Analysis 在內的獨立評測者無法重現那些亮眼分數。後續測試發現,發布在 Hugging Face 上的版本表現比它原本依據的單純 Llama 3.1 70B 還差。也有使用者指控託管的 API 悄悄把請求轉給 Claude。HyperWrite 的 Matt Shumer 承認,這個模型沒達到它所宣稱的評測成績。
所以誠實的結論是分裂的。Reflection-Tuning 這套做法確實有意思。模型實際交付的樣貌,卻從未追上自己的行銷話術。像這樣權重開放的模型發布仍值得研究,即使發布時的說詞把它誇過了頭。
開始使用
- 在 Hugging Face 打開模型頁面(mattshumer/Reflection-70B)或鏡像站,接受授權條款。
- 下載權重,或跳過本地安裝,改由託管的推論服務供應商來執行。
- 用你跑任何 Llama 模型時同樣的程式碼載入它,因為它共用 Llama 的對話模板。
- 餵給它推理用的系統訊息,讓它依序輸出思考、反思與答案三個區段。
- 想看模型在哪裡改變心意,就讀那些
<reflection>標籤。
產品資訊
快速了解 Reflection 70B 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- AI 研究者:可當成自我修正訓練的案例研究,也能藉此思考評測宣稱該如何驗證
- 打造本地推理工具的開發者:開放權重讓你檢查權重,並把它接進現有的 Llama 管線
- 對反思提示好奇的玩家:思考、反思與輸出的結構很好讀,也很好學
任務
- 數學與邏輯題:逐步推理的格式適合多步驟應用題,前提是你不介意多花的 token
- 自檢管線原型開發:一個能標出並修正自身錯誤的模型實例
- 對照研究:測試自我修正在自己工作負載上是否真能提升準確率的好參考點
情境
- 執行推理模型但不把資料送進封閉 API:權重由你自己託管
- 研究評測陷阱:這個模型的來歷清楚說明了獨立評測為何重要
- 用小預算玩反思提示:免費權重加上便宜推論,讓小規模測試變得很容易
主要功能
Reflection-Tuning
Reflection-Tuning 是讓這個模型得名的技術。它不是只用最終答案來訓練,而是訓練模型審視自己的推理並在生成途中改寫。實際運作時,模型先產出思考草稿,檢查一遍,再把判斷有錯的部分改掉,然後才給出答案。這個順序就是整套想法的核心:先修正,再定案。
結構化的思考與輸出標籤
模型用特殊 token 把內部作業與答案分開。推理放進 <thinking> 標籤,最終回覆放進 <output> 標籤。這樣的分隔讓草稿過程保持可見,當你想追查模型為何得出某個結論,或想藏起思考只秀答案時,都很方便。
行內自我修正
模型一察覺錯誤,就在思考裡送出一段 <reflection> 區塊。你可以讀那段區塊,精確看出推理在哪裡轉了彎。對於只有單一正解的任務,這個看得見的轉折往往比答案本身更有用,因為它顯示模型抓到了自己的失手,而不是把它埋起來。
Llama 相容性
由於它建立在 Llama 3.1 70B Instruct 之上,並保留標準的 Llama 對話格式,Reflection 70B 能直接放進已支援 Llama 的工具與管線。如果你之前部署過 Llama 模型,載入程式與服務設定幾乎不必改就能沿用。這份相容性正是大家一開始能輕鬆測試它的原因。
高精度推理導向
模型瞄準的是重視準確勝過速度的任務,例如多步驟數學與邏輯。它把推理拆成獨立步驟,並花更多 token 反覆核對。代價是延遲。答案要等更久才到,token 成本也上升,因為反思意味著在拿到最後一行之前得先寫更多文字。
權重開放
權重公開可用,所以你能在自己的硬體上跑這個模型、微調它,或研究反思訓練怎麼改變了它的行為。權重開放也代表你不會被單一廠商的定價或速率限制綁死,如果你想在任何規模下測試這個模型,這點很重要。
優缺點
優點
- 權重開放,可下載、可檢視、可自行託管
- 以 Llama 3.1 70B 為基礎,能沿用現有的 Llama 工具鏈與服務堆疊
- 透過思考、反思與輸出標籤,自我修正看得見
- 本地執行免費,不想管 GPU 時也有便宜的託管推論
缺點
- 獨立評測從未證實發布時的效能宣稱
- 部分 Hugging Face 版本據稱分數低於單純的 Llama 3.1 70B
- 冗長的思考與反思步驟會增加延遲與 token 成本
- 託管 API 引來把流量轉給 Claude 的指控,重創信任
常見問題
它是 HyperWrite 的開源語言模型,建立在 Llama 3.1 70B Instruct 上,採用一套叫 Reflection-Tuning 的訓練方法,在回答前檢查並修正自己的推理。
相關內容
探索與 Reflection 70B 相關的工具、技能與文章。
Reflection 70B 替代方案

Emailwritr
Emailwritr · 寫作 · 行銷Emailwritr 是一款 AI 電子郵件文案工具,為想要從既有名單中創造更多營收的聯盟行銷者、課程創作者與線上事業而打造。這款 AI 郵件撰寫工具不靠空白頁面或通用的聊天機器人提示,而是依照知名直效文案寫手的框架,產出歡迎序列、上市活動、購物車挽回郵件與促銷系列。你連接自己的自動回覆器、回答幾個關於優惠的問題,它就替你把文案寫好。

Swms
Swms AI · 寫作 · 生產力 · 商業Swms 是一款 AI 安全合規工具,能把一段對工作的簡單描述變成可直接使用的安全文件。你描述專案、工種與已知危害,它就會在數秒內寫出一份安全作業方法聲明、工作危害分析、安全作業程序、RAMS 或安全資料表。它還內建 Oscar,一個能用任何語言回答職場安全問題的聊天助理。建築、礦業、運輸與倉儲團隊都用它來減少那些原本會吃掉大半工作天的文書作業。

Prosp
Prosp · 寫作 · 語音與語言 · 行銷Prosp 是一款 AI LinkedIn 開發信工具,專為代理商與業務團隊打造,會針對每位潛在客戶以你自己的聲音撰寫訊息與語音訊息,讓他們真的回覆。你連接帳號、尋找潛在客戶,讓 AI 大規模草擬並發送個人化訊息,全部在一個收件匣完成。它是為大量進行陌生開發的人設計的。這就是它全部的賣點。每一個接觸點仍然必須感覺像真人。