
AgentQL
TinyFish · Coding
AgentQL ist eine Abfragesprache und ein Parser von TinyFish. Das Werkzeug findet Seitenelemente über ihre Bedeutung, damit Scraper und Agenten auch nach HTML-Änderungen weiterlaufen.
Über AgentQL
About
Was ist AgentQL
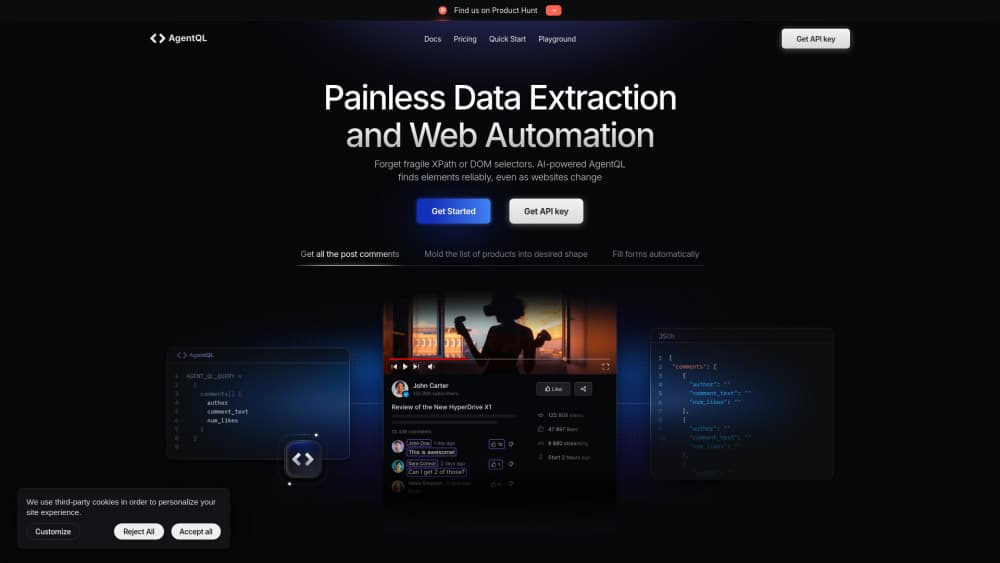
AgentQL ist für KI-Webscraping gebaut. Die AgentQL-Abfragesprache verbindet einen Parser mit einer KI-Schicht, um Webseiten zu lesen und zu steuern. Statt XPath oder CSS-Selektoren schreiben Sie die gewünschten Felder in fast normaler Sprache, etwa products[] { name price }, und der Dienst liefert JSON in genau dieser Form. Die KI liest den Kontext um jedes Element, deshalb findet die Abfrage die Daten auch dann, wenn ein Relaunch das Markup verschiebt.
Das Produkt deckt zwei Aufgaben ab. Beim Scraping gibt query_data strukturierte Datensätze zurück. Für die Automatisierung liefern query_elements und get_by_prompt Playwright-Locators, mit denen Sie klicken, tippen oder scrollen. TinyFish bietet SDKs für Python und JavaScript, einen REST-Endpunkt ohne Browser, eine Chrome-Erweiterung zum Debuggen und einen MCP-Server für Agenten-Frameworks.
Der Preis für diesen Komfort ist die Abhängigkeit von einem gehosteten Dienst. Jede Abfrage läuft über die AgentQL-API mit Ihrem Schlüssel, nach dem Gratiskontingent kostet jeder Aufruf Geld, und zur Laufzeit brauchen Sie eine Netzverbindung. Canvas-Oberflächen, ungewöhnliche Layouts und Seiten mit aggressiver Bot-Abwehr können weiterhin scheitern. Prüfen Sie Ergebnisse in der Produktion stichprobenartig.
Erste Schritte
- Legen Sie ein Konto auf agentql.com an und kopieren Sie einen API-Schlüssel aus dem Entwicklerportal.
- Installieren Sie das SDK mit
pip install agentqlodernpm install agentql. - Schreiben Sie eine Abfrage mit den benötigten Feldern und ergänzen Sie Typen wie
price(integer), wenn das Format zählt. - Rufen Sie
query_datazum Extrahieren oderquery_elementszum Interagieren in einem Playwright-Skript auf. - Testen Sie die Abfrage im Playground oder in der Browser-Erweiterung, bevor Sie sie im großen Stil starten.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von AgentQL.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Python- und JavaScript-Entwickler
- Daten- und Growth-Teams ohne eigenen Scraping-Entwickler
- Entwickler von KI-Agenten
Aufgaben
- Preise und Kataloge beobachten
- Leads und Verzeichnisse erfassen
- Formulare ausfüllen und Bestellungen abschließen
- Sprachmodelle mit sauberen Seitendaten füttern
Szenarien
- Ein Relaunch bricht den Scraper
- Eine Abfrage für mehrere ähnliche Seiten
- Recherche auf Seiten mit Anmeldung
Wichtigste Funktionen
Semantische Selektoren
AgentQL findet Elemente über Bedeutung und Umfeld, nicht über die Position im DOM. Ein Feld namens product_price erkennt den Preis auch dann, wenn die Klasse wechselt oder der Block weiter unten steht. Abfragen bleiben dadurch bei A/B-Tests und langsamen Layoutänderungen stabil, und dieselbe Abfrage funktioniert auf Seiten verschiedener Teams.
Schema aus der Abfrage
Die Abfrage ist zugleich der Ausgabevertrag. Verschachteln Sie Objekte, markieren Sie Listen mit Klammern und ergänzen Sie Hinweise wie price(integer) oder product_price(include currency symbol), um das Format zu steuern. Sie erhalten JSON in genau der geschriebenen Form, sodass strukturierte Datenextraktion ohne Reinigungsschritt auskommt.
Playwright-Integration
Die SDKs für Python und JavaScript umhüllen Playwright-Seiten und ergänzen die Methoden query_data, query_elements und get_by_prompt. Die vollständige Browser-API bleibt für Navigation, Screenshots und Datei-Uploads verfügbar. Zurückgegebene Locators verhalten sich wie normale, bestehende Test-Helfer laufen also weiter.
REST-API ohne Browser
Ein REST-Endpunkt liefert Seitendaten aus einer URL, ohne einen Browser zu starten. Das passt zu geplanten Jobs und Serverless-Funktionen, in denen ein Chromium-Download nicht sinnvoll ist. Sie senden URL und Abfrage und bekommen das Ergebnis in einer Anfrage zurück.
Debugger im Browser
Eine Chrome-Erweiterung öffnet auf jeder Seite eine Seitenleiste, in der Sie eine Abfrage entwerfen und passende Elemente sofort markiert sehen. Der Weg vom Selektor zur Gewissheit wird kurz, was bei unruhigen Seiten am meisten hilft.
MCP-Server
Der quelloffene MCP-Server bringt die AgentQL-Extraktion in Assistenten und Agenten-Laufzeiten, die das Model Context Protocol sprechen. Mit npx installieren, Schlüssel eintragen, und der Agent ruft eine URL als Werkzeug auf. Klebecode entfällt.
Vor- und Nachteile
Vorteile
- Abfragen lesen sich wie die gewünschten Daten, neue Teammitglieder ändern sie ohne Selektor-Erfahrung.
- Semantisches Matching senkt den Wartungsaufwand, der einen großen Teil des Scraping-Budgets frisst.
- Der kostenlose Starter-Plan enthält 50 API-Aufrufe pro Monat, genug für einen Praxistest vor der Zahlung.
- Die Playwright-Anbindung deckt Extraktion und Interaktion im selben Skript ab.
- REST-API und MCP-Server bedienen Jobs ohne Browser und Agenten-Workflows.
Nachteile
- Aufrufe werden abgerechnet: 0,02 US-Dollar pro Aufruf im Starter- und 0,015 US-Dollar im Professional-Plan nach dem Inklusivvolumen, ein Crawl über 100.000 Seiten kostet also echtes Geld.
- Stunden im entfernten Browser werden separat berechnet, mit 0,12 oder 0,10 US-Dollar pro Stunde, lange Sitzungen für Webautomatisierung werden teurer als gedacht.
- Alles hängt an der gehosteten API: keinen Offline-Modus, und ein Ausfall stoppt die Pipeline.
- KI-Matching ist nicht deterministisch: Ungewöhnliche Layouts liefern manchmal Teil- oder verschobene Felder, Produktionsjobs brauchen Prüfung und Wiederholungen.
Häufige Fragen
Für zwei Aufgaben: Daten von Webseiten extrahieren und einen Browser steuern. Teams nutzen es für Preisüberwachung, Lead-Sammlung, Formularausfüllung und saubere Daten für KI-Agenten.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu AgentQL.
Alternativen zu AgentQL

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.