

Firecrawl
Firecrawl (Mendable AI) · Coding · Sonstiges
Firecrawl ist eine Web-Daten-API, die Seiten in sauberes Markdown oder strukturiertes JSON umwandelt, damit KI-Agenten das Live-Web durchsuchen, crawlen und lesen können.
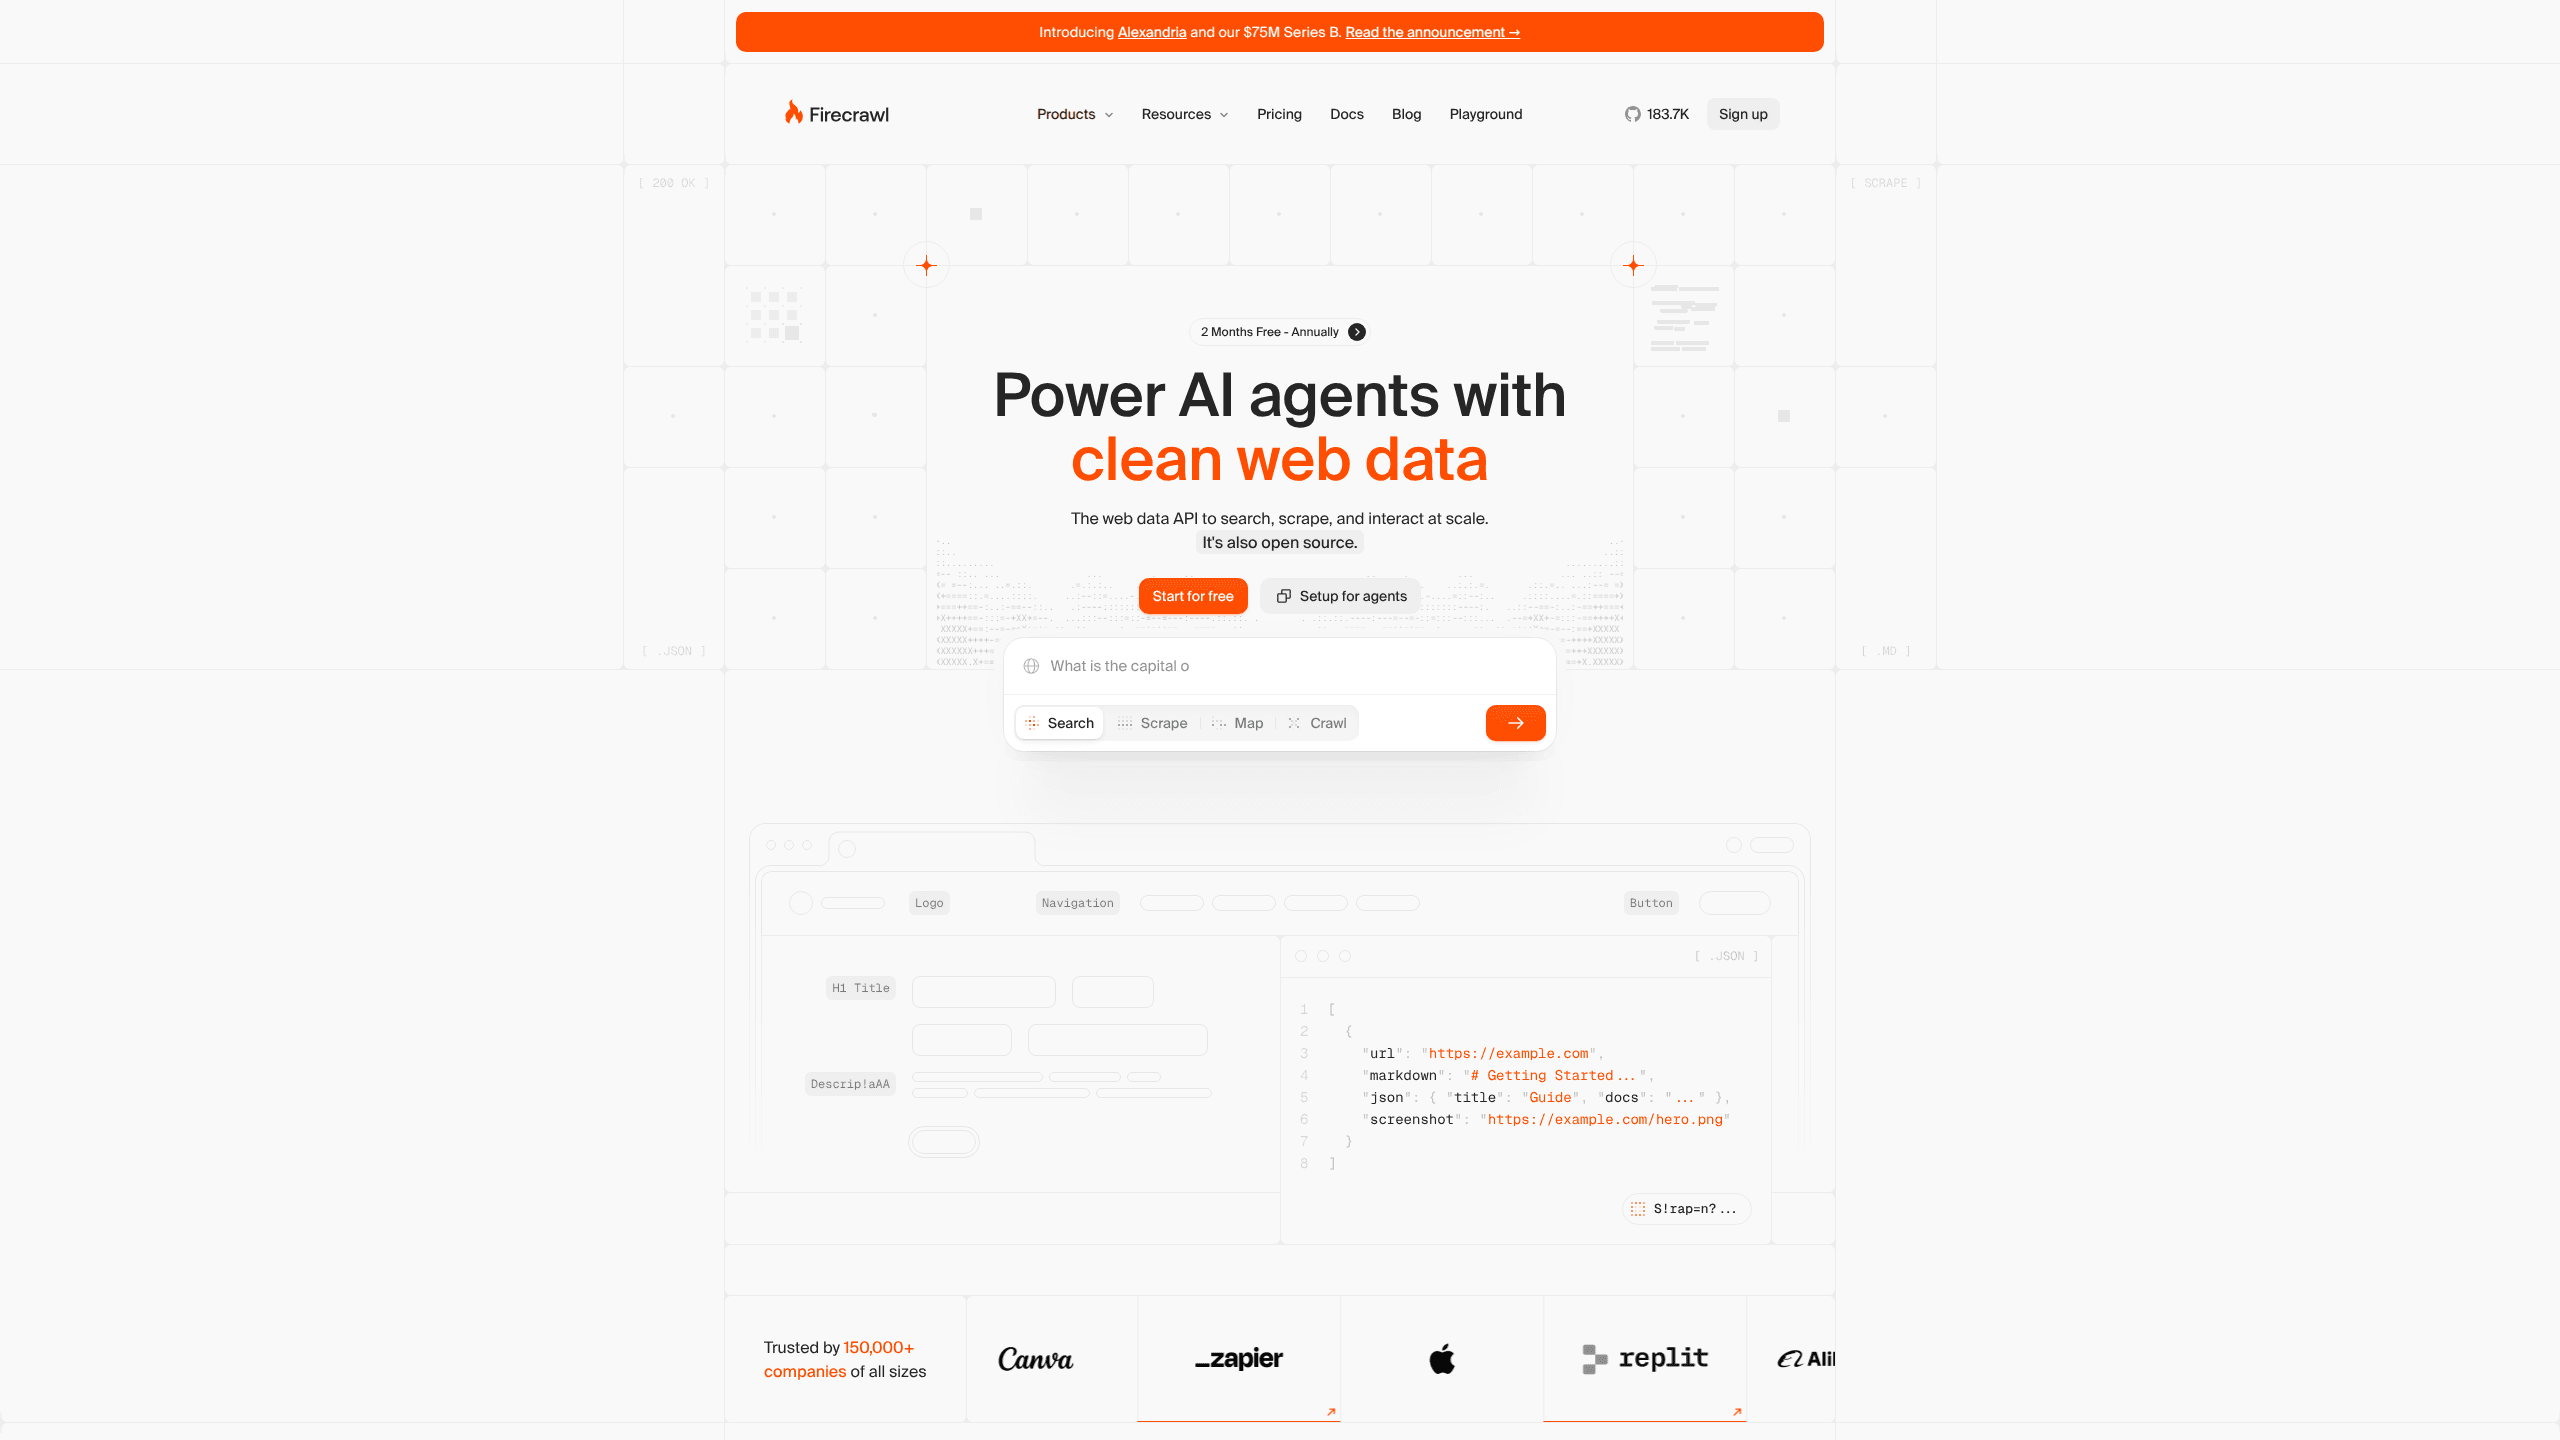
Über Firecrawl
About
Was ist Firecrawl
Firecrawl nimmt eine URL und gibt nur den Teil der Seite zurück, der zählt. Die Anfrage läuft über einen Browser, Menüs, Werbung und Cookie-Hinweise fallen weg, und die Antwort kommt als Markdown, HTML oder JSON, das ein Sprachmodell ohne Nachbearbeitung liest. Wer eine Website in Markdown umwandeln will, ohne einen eigenen Parser zu schreiben, bekommt hier eine fertige Web-Scraping-API.
Die meisten Teams versorgen damit Suchsysteme, Agenten und Recherchewerkzeuge mit aktuellen Inhalten. KI-Web-Scraping in Eigenregie verlangt einen Renderer, wechselnde Proxys und einen HTML-Reiniger. Hier liegt das alles hinter einer API zum Crawlen von Websites. Dasselbe Konto deckt Suche, einzelne Seiten, komplette Crawls, URL-Erkennung, Dokumente, Browseraktionen und geplante Überwachung ab.
Das Projekt ist Open Source unter AGPL-3.0, dazu gibt es einen gehosteten Dienst für alle, die keine Browser und Proxys betreiben wollen. Credits gelten über alle Endpunkte hinweg, und ein Crawl kostet mehr als ein einzelner Abruf. Prüfen Sie das Budget, bevor Sie den Dienst auf eine große Seite richten.
Erste Schritte
- Legen Sie ein Konto auf firecrawl.dev an oder senden Sie eine Testanfrage ohne Schlüssel. Der Zugang ohne Schlüssel ist im Tempo begrenzt, reicht aber für einen ersten Blick.
- Kopieren Sie den Schlüssel aus dem Dashboard und speichern Sie ihn als FIRECRAWL_API_KEY.
- Schicken Sie ein POST an /v2/scrape mit der URL und den gewünschten Formaten, etwa markdown und json.
- Installieren Sie ein SDK (pip install firecrawl-py oder npm install firecrawl) oder verbinden Sie den MCP-Server mit Claude, Cursor oder VS Code.
- Ergänzen Sie Aufrufe von crawl, map oder monitor, wenn Sie eine ganze Website, eine URL-Liste oder Hinweise auf Änderungen brauchen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Firecrawl.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler, die Suchpipelines oder Agenten bauen
- Entwickler, die in Claude Code, Cursor oder VS Code arbeiten
- Analyse- und Rechercheteams
Aufgaben
- Produktdokumentation in eine Wissensbasis für einen Chatbot verwandeln
- Preise und Angebote aus JavaScript-lastigen Shops holen
- Typisierte Datensätze gewinnen
- Wettbewerberseiten verfolgen
Szenarien
- Ein RAG-Prototyp, der diese Woche echte Seiten braucht
- Ein Support-Bot, der das Hilfeportal nach jedem Release neu liest
- Ein interner Agent, der sich in ein Lieferantenportal einloggt
Wichtigste Funktionen
Seiten als Markdown oder strukturiertes JSON ausgeben
Der scrape-Endpunkt liefert den Hauptinhalt ohne Menüs und Werbung, als Markdown, HTML, Linkliste, Screenshot oder JSON nach Ihrem Schema. Strukturierte Datenextraktion läuft über denselben Aufruf, sodass die Ergebnisse in speicherbare Felder fallen. PDFs und DOCX gehen denselben Weg, gemischte URL- und Dokumentlisten landen also in einem Datensatz. Die Ausgabe wird zwischengespeichert, was Wiederholungskosten bei selten geänderten Seiten senkt.
Suche mit dem vollen Seiteninhalt
Search schickt die Anfrage ins Live-Web und gibt den vollständigen Text jedes Treffers zurück, nicht nur Titel und Auszug. Filter nach Domain, Datum oder Land sind möglich, ebenso hervorgehobene Passagen oder eine Zusammenfassung. Ein Aufruf reicht dem Agenten als Kontext, eine zweite Extraktionsrunde entfällt.
Eine ganze Website crawlen
Crawl startet bei einer URL und folgt Links nach Ihren Regeln: Tiefe, Pfadmuster, Seitenlimit und Sitemap-Nutzung. Jobs laufen im Hintergrund und melden ihren Fortschritt, eine Seite mit 5.000 Unterseiten blockiert die Anwendung also nicht. Pro Seite kommt ein Datensatz als Markdown oder JSON zurück.
Die Struktur vor dem Crawl erfassen
Map liefert die URL-Struktur einer Domain in Sekunden, hilfreich wenn der Aufbau der Seite unbekannt ist. Filtern Sie die Liste nach dem Aufruf und schicken Sie nur die nötigen Seiten in den Crawl. Das ist billiger, als alles zu durchsuchen, um zu sehen, was existiert.
Seiten über einen gehosteten Browser bedienen
Interact öffnet eine echte Browsersitzung und führt Klicks, Eingaben, Scrollen und Logins aus. Damit erreichen Sie Seiten, die Inhalte erst nach einem Klick oder einer Anmeldung laden. Die Sitzungen sind für kurze Aufgaben gedacht, nicht für einen Browser, der den ganzen Tag offen bleibt.
Seiten auf Änderungen überwachen
Monitor prüft eine Seite, einen Crawl oder eine Suche im gewählten Takt. Ändert sich der Inhalt oder taucht ein neues Ergebnis auf, schickt Firecrawl einen Webhook, eine E-Mail oder eine Slack-Nachricht. Für Preise, Richtlinienseiten und Release Notes ersetzt das eine Sammlung aus Cron-Jobs und Diff-Skripten.
Vor- und Nachteile
Vorteile
- Sieben Endpunkte mit einem Schlüssel: search, scrape, crawl, map, parse, interact und monitor.
- Sauberes Markdown direkt aus der Ausgabe, ohne Menüs und Templates vor dem Modell.
- Open Source unter AGPL-3.0, also selbst hostbar oder vorab im Code lesbar.
- Offizielle SDKs für Python, Node.js, Go und Rust, dazu CLI und MCP-Server.
- Kostenloser Tarif mit 1.000 Credits pro Monat und einer ersten Anfrage ohne Schlüssel.
Nachteile
- Die Credit-Kosten hängen von Endpunkt und Optionen ab, ein großer Crawl kann einen Tarif schneller leeren als erwartet.
- Im kostenlosen Tarif laufen 2 Anfragen gleichzeitig und 10 pro Minute bei scrape, für Stapelarbeit zu wenig.
- Interact ist nicht für dauerhafte Sitzungen gebaut, ein stundenlang angemeldeter Agent braucht ein anderes Werkzeug.
- Selbst hosten heißt eigene Browser und Proxys betreiben, und bei Änderung und Weitergabe des Codes greift die AGPL.
Häufige Fragen
Firecrawl gibt KI-Anwendungen einen Weg ins Web. Es wandelt Seiten, PDFs und Dokumente in Markdown oder JSON um und ergänzt diese Extraktion um Suche, Crawl und Änderungsüberwachung.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Firecrawl.
Alternativen zu Firecrawl

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.