
Future AGI
Future AGI · Coding
Future AGI ist eine Plattform zum Bewerten, Nachverfolgen und Absichern von KI-Anwendungen. Sie testet Prompts, simuliert Agenten und findet Halluzinationen, bevor sie Nutzer erreichen.
Über Future AGI
What Is Future AGI
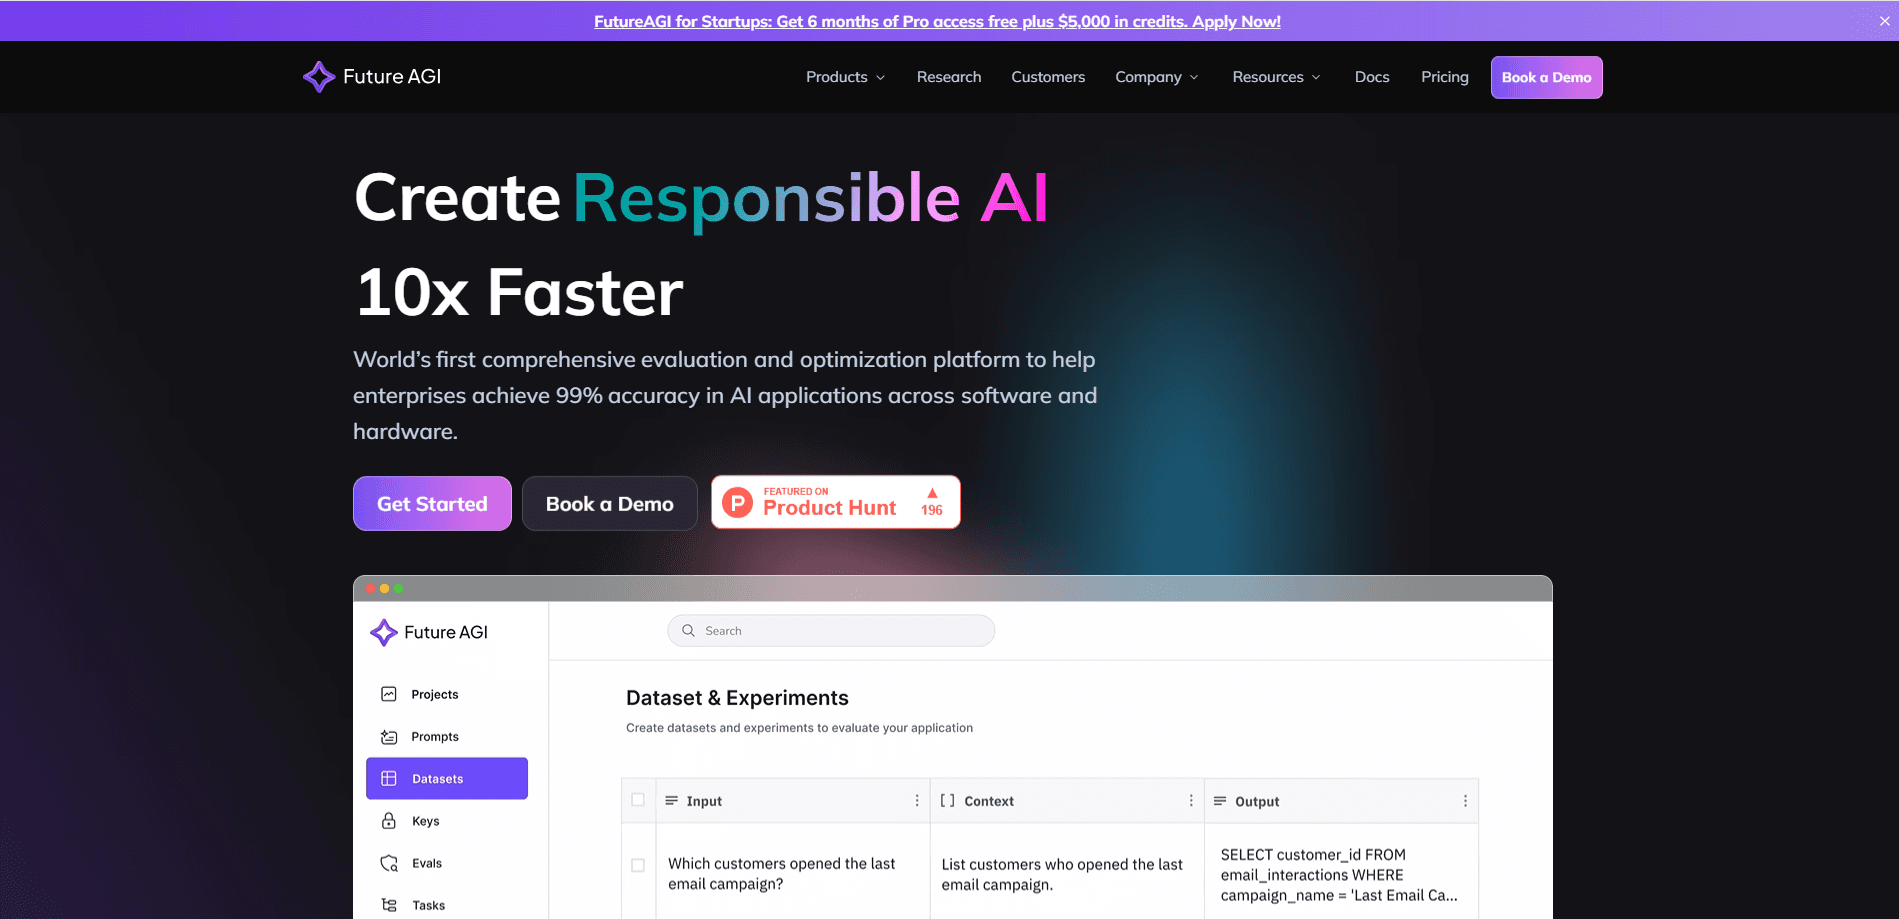
Future AGI ist eine Plattform für KI-Engineering, die sich um eine Aufgabe dreht: finden, was in einer Anwendung mit Sprachmodellen schiefgeht, bevor es der Nutzer merkt. Sie bündelt Evaluierung, Observability, Guardrails und Prompt-Verbesserung in einem Produkt, und jeder Baustein startet mit einem kostenlosen Tarif. Teams nutzen sie, um Modellausgaben zu bewerten, jeden Schritt eines Agenten nachzuvollziehen, unsichere Inhalte zu blockieren und Prompts an echten Daten zu schärfen.
Das Problem ist leicht zu beschreiben und schwer zu lösen. Sprachmodelle halluzinieren, weichen von der Anweisung ab und lassen Daten durchsickern, und diese Fehler zeigen sich in einer Demo fast nie. Future AGI legt die Werkzeuge zum Aufspüren an eine Stelle, statt ein Team einen Tracer, eine Evaluierungsbibliothek und eine getrennte Moderations-API zusammenflicken zu lassen. Bekannt ist die Plattform vor allem für LLM-Observability, den Teil, der festhält, was die Anwendung getan hat, und für KI-Tracing, das jede Anfrage Schritt für Schritt aufzeichnet, neben den Bewertungen, die die Qualität des Ergebnisses beurteilen. Der LLM-as-Judge-Ansatz übernimmt dabei die Rolle des Richters. Laut Unternehmen nutzen sie über 2.400 Teams, und die Evaluierungs-SDKs sind auf GitHub als Open Source verfügbar.
Zwei Grenzen sollte man vorher kennen. Der kostenlose Tarif erneuert sich monatlich und deckelt das Tracing bei 50 GB mit 30 Tagen Aufbewahrung, sodass eine laufende Produktionslast ihn schnell sprengt. Und die stärkste agentische Evaluierung läuft über bezahlte KI-Credits, die immer kostenlosen Teile sind also die heuristischen Prüfungen und die Richter mit eigenem Schlüssel.
Getting Started
- Registrieren Sie sich auf app.futureagi.com und legen Sie ein Projekt für Ihre Anwendung an
- Installieren Sie das traceAI-SDK und richten Sie es auf Ihre Modellaufrufe, um Traces zu sammeln
- Fügen Sie eine Evaluierung hinzu, um Ausgaben zu bewerten: Wählen Sie eine Vorlage oder schreiben Sie einen eigenen Richter-Prompt
- Schalten Sie die Guardrails auf Ihrem Gateway ein, um personenbezogene Daten und Injections in Echtzeit zu blockieren
- Sehen Sie den Fehler-Feed durch und folgen Sie den Empfehlungen, um Prompts zu korrigieren und neu zu laufen
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Future AGI.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Engineering-Teams
- ML- und Evaluierungsingenieure
- Produktteams mit KI-Funktionen
- Einzelentwickler und kleine Startups
Aufgaben
- Prompt-Tests
- Halluzinationserkennung
- Agenten-Tracing
- Inhaltsprüfung
- Regressionstests
Szenarien
- Ein Support-Bot antwortet in Produktion falsch
- Zwei Modellversionen vergleichen
- Prüfung vor dem Start eines neuen Agenten
- LLM-Kosten senken
- Kontrolle personenbezogener Daten
Wichtigste Funktionen
Evaluierung mit LLM-Richter und Code-Evals
Future AGI bewertet Modellausgaben auf mehreren Wegen, sodass Sie den passenden für jede Prüfung wählen. Heuristiken wie BLEU, ROUGE und Regex sind kostenlos und unbegrenzt. Code-Evals und die gehosteten Turing-Richtermodelle kosten pro Lauf KI-Credits, während ein eigener Schlüssel für den Richter auf der Plattform nichts kostet. In einem Aufruf startet das Toolkit eine breite Palette von Metriken für Text, Bild und Audio, von Grundlagen- und Halluzinationsprüfungen bis zu Tool-Korrektheit und dem Abfluss personenbezogener Daten.
Tracing und Observability
Das traceAI-SDK erfasst Traces, Spans und Sitzungen von Ende zu Ende, sodass Sie genau sehen, was die Anwendung bei einer Anfrage getan hat. Es bringt über 30 Bibliotheken und 11 Span-Typen mit, dazu über 70 Filter und eine Volltextsuche zum Durchsuchen von Läufen. Sitzungen, Endnutzer und eine Agenten-Grafikansicht binden jeden Aufruf an die Personen und Abläufe dahinter zurück. Anpassbare Dashboards und Alarm-Monitore mit Slack und E-Mail runden das Bild ab.
Guardrails und Inhaltsschutz
Die Guardrails sitzen vor dem Modell und prüfen den Verkehr in beide Richtungen. Fünfzehn regelbasierte Prüfungen, die personenbezogene Daten, Geheimnisse und eigene Muster abdecken, sind immer kostenlos, während das ML-Moderationsmodell (Gemma 3n) pro Prüfung KI-Credits verbraucht. Sie können sie im Blockier-, Überwachungs- oder Protokollmodus betreiben und Score-Schwellen setzen, und 15 externe Integrationen wie Lakera, Presidio und Llama Guard stehen bereit, wer schon auf diese Werkzeuge setzt.
Agenten-Simulation mit Personas
Die Simulation testet einen Agenten gegen Menschen statt gegen Prompts. Sie wählen aus über 28 fertigen Personas oder schreiben Ihre eigene, und die Plattform führt Text- oder Sprachgespräche mit Ihrem Agenten über Skript-, Datensatz- und Grafikszenarien. Transkripte und Sitzungsvergleiche zeigen, wo der Agent den Faden verlor, und die automatische Szenarienerstellung entwirft aus einer Beschreibung neue Testfälle. Sprach- und Textminuten werden getrennt abgerechnet.
KI-Gateway und Command Center
Das Command Center ist ein KI-Gateway zwischen Ihrer Anwendung und den Modellanbietern. Es leitet über mehr als 15 Anbieter wie OpenAI, Anthropic, Gemini und Bedrock, mit neun Lastverteilungsstrategien, automatischem Failover und Retry. Exaktes und semantisches Caching kürzt wiederkehrende Aufrufe, und Ratenlimits, Budgets und virtuelle Schlüssel halten die Ausgaben im Zaum. Der kostenlose Tarif deckt 100.000 Anfragen und 100.000 Cache-Treffer pro Monat.
Datensätze, Experimente und Prompt-Werkbank
Datensätze bleiben in jedem Tarif dauerhaft gespeichert und unterstützen 14 Spaltentypen, mit sechs Wegen sie anzulegen, von der Handeingabe bis zum Import aus CSV, PDF und HuggingFace. Experimente lassen einen Datensatz gegen mehrere Modelle oder Prompts laufen und vergleichen die Ergebnisse an einer Stelle. Die Prompt-Werkbank ergänzt Versionierung, Labels und Ordner, dazu einen visuellen Agenten-Playground und einen Prompt-Playground, in dem Sie ohne Plattformkosten zwischen über 100 Modellen wechseln.
Fehleranalyse mit Falcon AI
Falcon AI liest Ihre Traces und zieht die Muster heraus, die ein Mensch übersieht. Es bündelt Fehler über vier Bewertungsdimensionen, erzeugt Erkenntnisse dazu, was weiter schiefgeht, und vergibt automatisch Tags, damit Sie nach Fehlerart filtern. Das Ergebnis ist eine Reihe von Empfehlungen und Sofortkorrekturen, die an die auslösenden Traces gebunden sind, der kürzeste Weg von einem gescheiterten Lauf zu einer Prompt-Korrektur.
Vor- und Nachteile
Vorteile
- Der kostenlose Tarif deckt Tracing, Evals, Gateway und Simulation ohne Kreditkarte
- Das Evaluierungs-SDK ist Open Source, die Bewertungslogik lässt sich also prüfen statt als Blackbox zu gelten
- Eine Plattform umfasst Tracing, Evals, Guardrails und Prompt-Arbeit, das senkt die Zahl der Anbieter
- Evaluierungen mit eigenem Schlüssel kosten nichts, was den Preis für Teams mit eigenem Modellzugang niedrig hält
- Die 15 eingebauten Guardrails sind in jedem Tarif kostenlos, samt Erkennung von Daten und Geheimnissen
Nachteile
- Das kostenlose Tracing endet bei 50 GB mit 30 Tagen Aufbewahrung, die Produktion wächst also schnell hinaus
- Die stärkste agentische Evaluierung läuft über bezahlte Credits, die immer kostenlosen Teile sind also die einfacheren Prüfungen
- Die Sprachsimulation wird getrennt abgerechnet und gibt monatlich nur 60 kostenlose Minuten
- Der Preis richtet sich nach Nutzung über sechs Dimensionen, die Endrechnung ist damit schwerer vorherzusagen als bei einem Festtarif
Häufige Fragen
Future AGI ist eine KI-Evaluierungsplattform und zugleich mehr als das. Sie deckt Evaluierung, Tracing, KI-Guardrails und Prompt-Verbesserung in einem Produkt ab, sodass Sie Modellausgaben bewerten, die Schritte eines Agenten verfolgen, unsichere Inhalte blockieren und Prompts an echten Daten schärfen. Die Evaluierungs-SDKs sind Open Source und die Plattform läuft im Web, mit Python- und TypeScript-Clients.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Future AGI.
Alternativen zu Future AGI

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.