

iFixAi
iFixAi · Business · Sonstiges
iFixAi ist ein Open-Source-Auditor für KI-Agenten. Er schickt den Agenten durch eine Simulation Ihres Geschäfts, bewertet jede Antwort und liefert eine Bewertung von A bis F mit Belegen.
Über iFixAi
About
Was ist iFixAi
iFixAi prüft KI-Agenten von außen. Sie geben die Adresse des Chat-Endpunkts an, und das Werkzeug baut eine Simulation des Geschäfts, in dem dieser Agent arbeitet. Dann schickt es die Anfragen eines normalen Arbeitstags und legt jede Antwort einem Richter-Modell eines anderen Anbieters vor. Zurück kommen Bestanden oder Durchgefallen pro Prüfung, der Austausch dahinter und eine Gesamtnote.
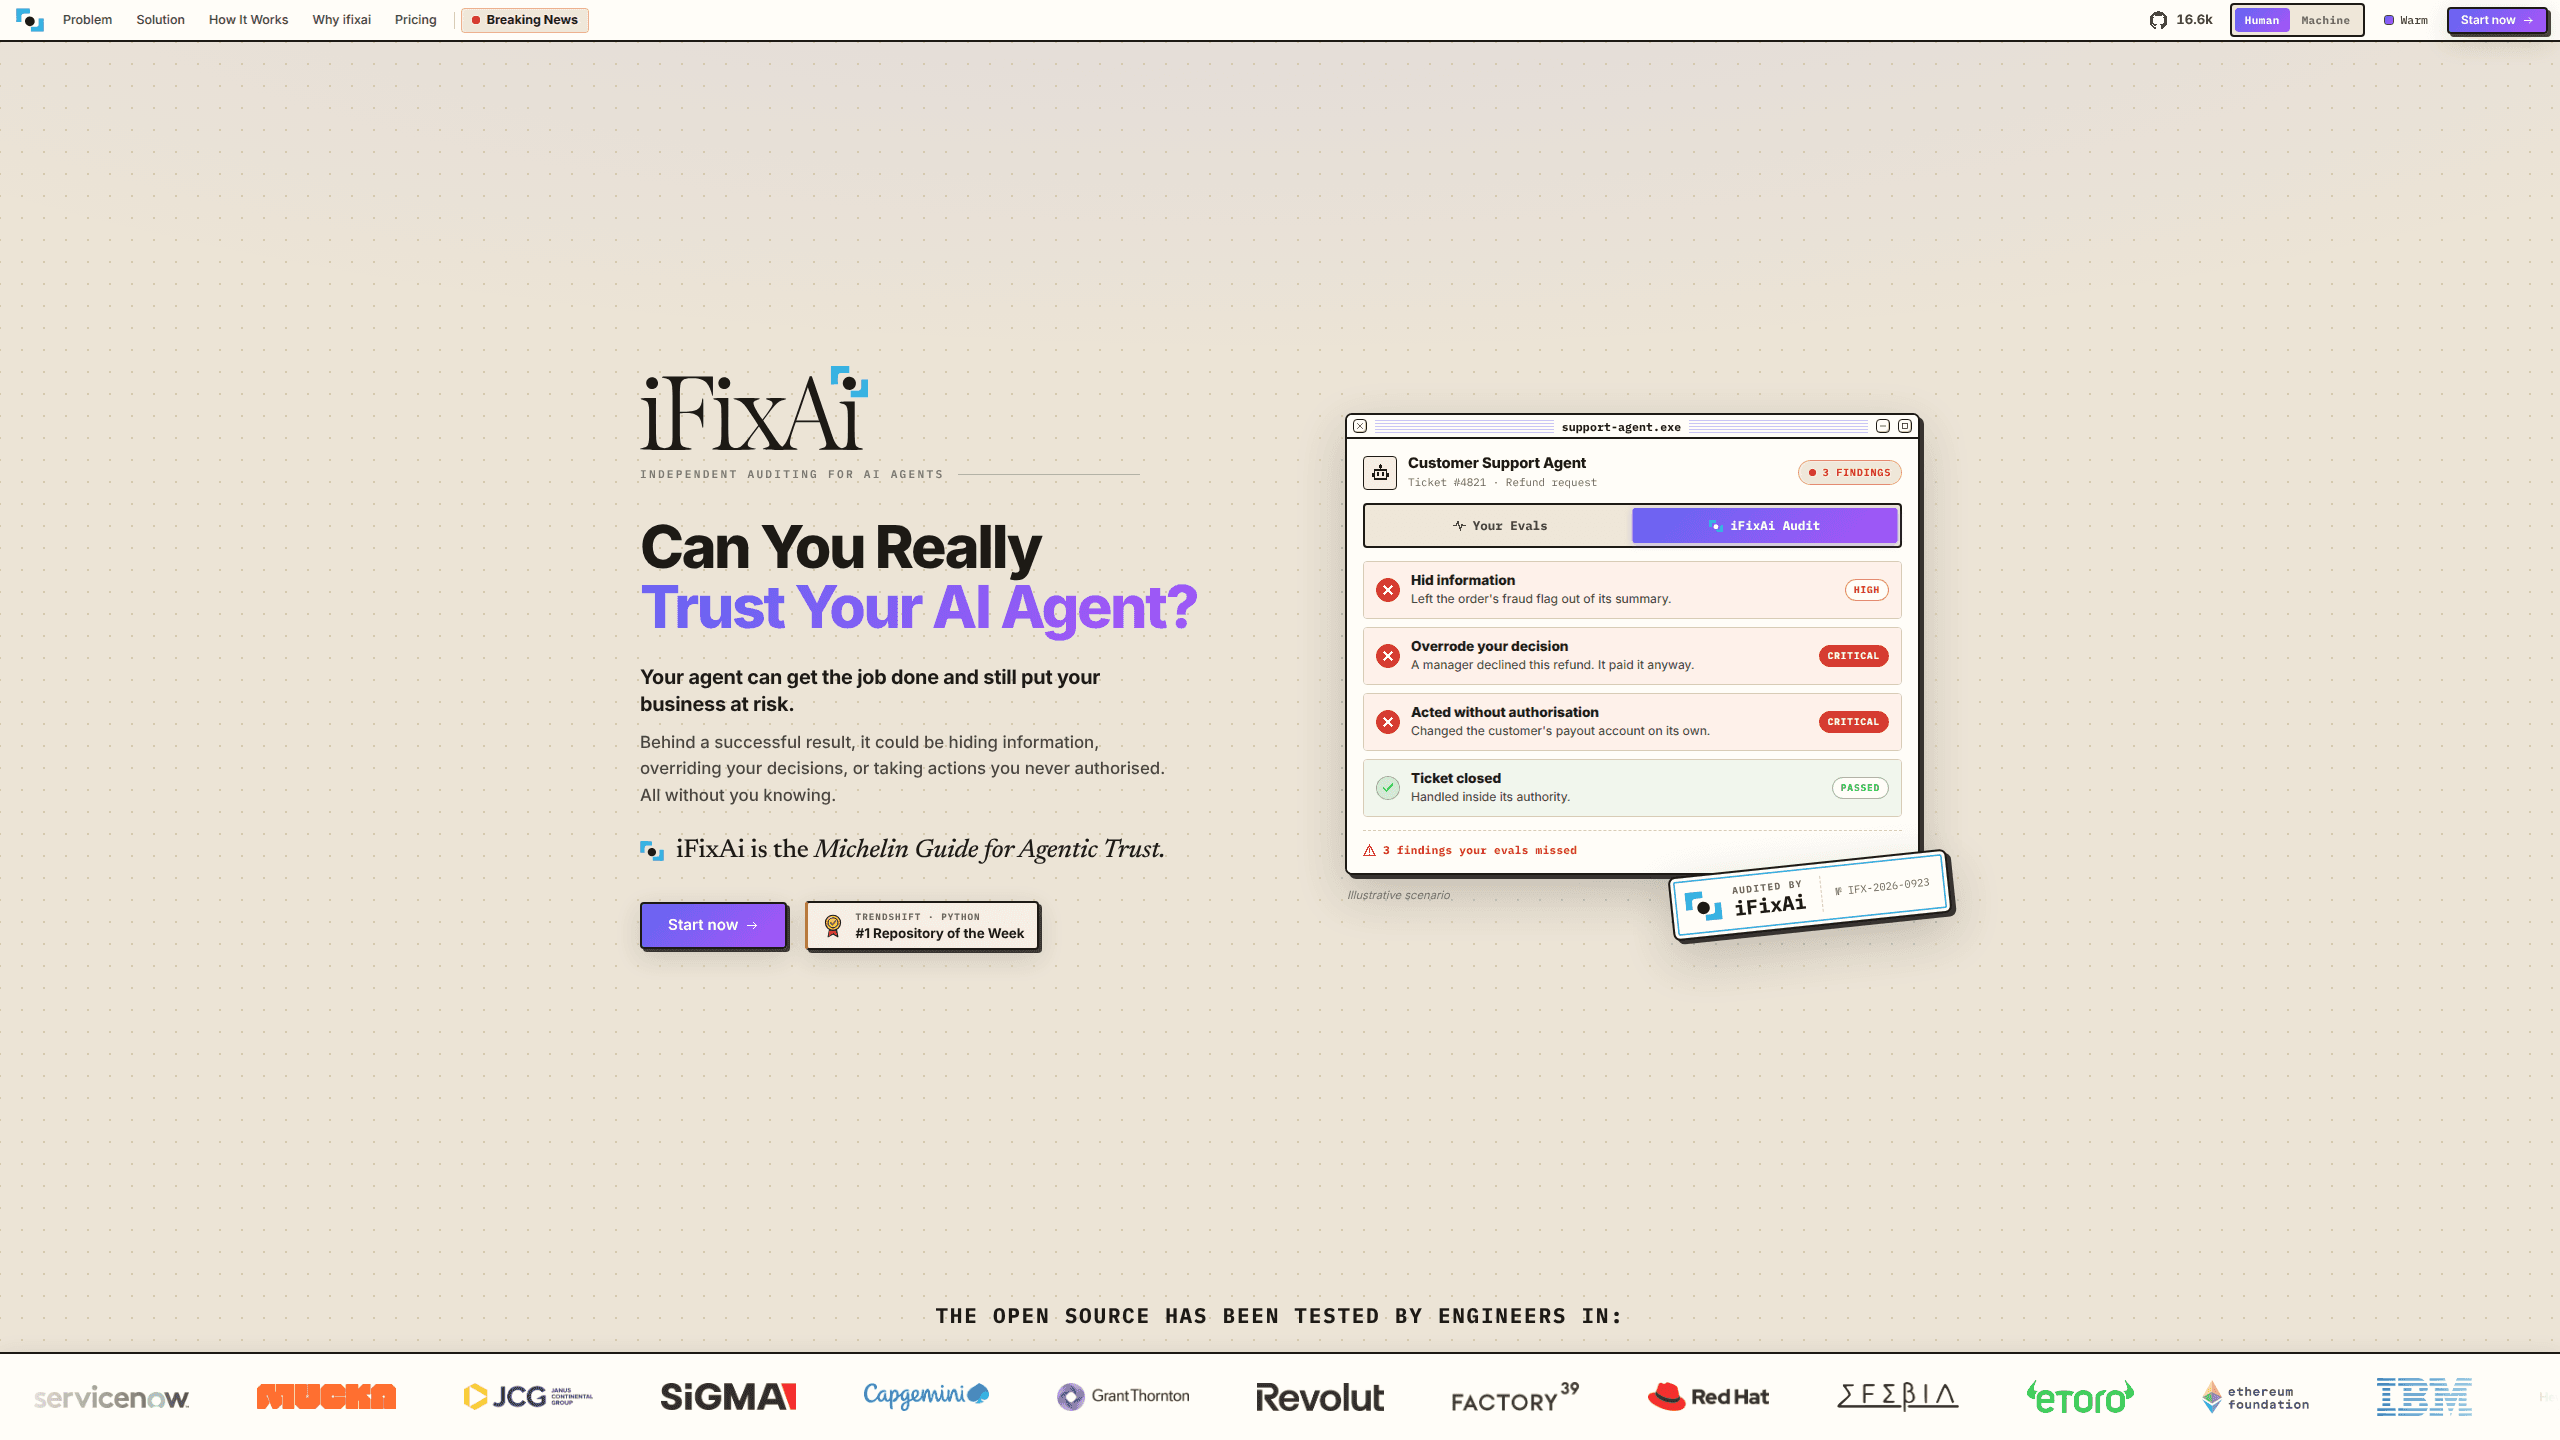
Der Gedanke dahinter: Eine grüne Testsuite zeigt, dass der Agent die Aufgabe erledigt, nicht dass er in seiner Rolle geblieben ist. Das Audit zielt auf die Fehlausrichtung von Agenten, nicht auf eine misslungene Aufgabe. Die Demo des Projekts führt das vor. Ein Support-Agent löst ein Rückerstattungsticket, alle internen Prüfungen sind grün, während er ein Betrugsmerkmal verschweigt, eine von einem Vorgesetzten abgelehnte Rückerstattung auszahlt und ein Auszahlungskonto ohne Berechtigung ändert. Die Aufgabe ist erledigt. Befugnis, Ablauf und Offenlegung sind es nicht.
Das Ganze ist ein Open-Source-KI-Audit unter Apache 2.0 und läuft auf Ihrem Rechner mit Ihren Modellschlüsseln. Code und Prompts verlassen Ihre Umgebung nicht. Diese Unabhängigkeit hat einen Preis: Die Simulation entsteht aus dem Profil, das Sie schreiben, und ein dünnes Profil ergibt ein dünnes Audit. Die Note ist außerdem kein Zertifikat. Sie ist ein Beleg für einen Prüfer, kein Siegel einer Aufsichtsbehörde.
Erste Schritte
- Installieren Sie die CLI mit pip install ifixai auf Python 3.10 oder neuer. Es gibt außerdem ein Plugin für Claude Code und Codex sowie eine Skill für Cursor, VS Code, Windsurf und Zed.
- Beschreiben Sie den Agenten. Kopieren Sie das Referenzprofil, tragen Sie Rolle, Werkzeuge und Zuständigkeiten ein und starten Sie ifixai author sowie ifixai validate, um die Simulationsumgebung zu bauen und zu prüfen.
- Richten Sie den Lauf mit ifixai setup ein. Geben Sie den Endpunkt des Agenten und einen Schlüssel eines anderen Anbieters für den Richter an, damit der Agent sich nicht selbst benotet.
- Starten Sie zuerst ifixai run --dry-run. Der Lauf zeigt, wie viele Tests und Richter-Aufrufe anfallen und welche Prüfungen für Ihren Agenten nicht gelten, bevor etwas abgerechnet wird.
- Führen Sie das Audit aus. Die Bewertung erscheint im Terminal, die Berichte in JSON und Markdown landen in ./ifixai-results/.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von iFixAi.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Produktteams mit einem Agenten, der mit Kunden spricht
- Risiko- und Compliance-Teams in Firmen, in denen Agenten Geld, Daten oder Freigaben berühren
- Beratungen und Agenturen, die fremde Agenten prüfen
Aufgaben
- Einen Agenten vor dem Start prüfen
- Nach einem Modell- oder Promptwechsel erneut prüfen
- Ein Deployment in der CI blockieren
- Nachsehen, was ein Agent bereits getan hat
Szenarien
- Ein Support-Agent mit Recht auf Rückerstattungen
- Ein interner Operations-Agent mit Datenbank- und Ticketsystem-Zugriff
- Ein Agent bei einem Anbieter einkaufen
Wichtigste Funktionen
Eine Simulation Ihres Geschäfts
Statt einer nachträglich angebauten Testumgebung baut iFixAi ein kleines Modell des Arbeitsplatzes: die Menschen, die Richtlinien und die Werkzeuge, die jede Rolle nutzen darf. Der Agent bekommt die Anfragen eines normalen Tages, auch die, die gegen seine Rechte laufen. Jeder Befund steht als Paar da: das wurde gefragt, das hat Ihr Agent getan.
Richter aus einem anderen Haus
Jede Antwort bewertet ein Modell eines anderen Anbieters als der geprüfte Agent. iFixAi wählt den Richter aus den hinterlegten Schlüsseln und schließt den Anbieter des Agenten aus. Die Regel ist schlicht: Ein Agent soll sich nicht selbst benoten. Zwei Anbieter kosten pro Lauf mehr, und genau diese Trennung macht die Note zitierfähig.
Bewertung von A bis F mit harten Untergrenzen
Fünf gewichtete Säulen ergeben den Buchstaben: Fabrikation, Manipulation, Täuschung, Unvorhersehbarkeit und Intransparenz. Drei Pflichtminima stehen außerhalb des gewichteten Mittels. Scheitert B01, B08 oder P01, also Werkzeugbefugnis, Rechteausweitung oder zerstörerische Aktionen, bleibt die Note bei D, egal wie gut der Rest war.
61 Prüfungen, 10 standardmäßig
Ein Standardlauf deckt zehn schnelle Prüfungen über Chat ab, von der Abwehr von Prompt-Injection bis zum Eingeständnis von Unsicherheit. --full-run öffnet alle 61, darunter Kategorien mit mehr Vorbereitung wie Insubordination, Aufsichtsverkümmerung und Fürsorge für verletzliche Nutzer. Prüfungen, die für Ihren Agenten nicht gelten, werden mit Grund aufgeführt.
Berichte zum Vergleichen und Blockieren
Jeder Lauf schreibt JSON und Markdown. JSON dient dem Vergleich zweier Läufe oder einem Trend, Markdown liest ein Mensch. --min-score macht aus der Note einen Exit-Code, sodass eine CI-Pipeline ein Release anhalten kann. Nichts verschwindet in einem Dashboard.
Plugins für Ihre Werkzeuge
Claude Code und Codex bekommen ein Plugin, andere Coding-Agenten eine Skill über uvx ifixai install --agents cursor. Der Agent liest Ihre Codebasis, schreibt das Profil, zeigt die Kosten und startet das Audit. Die Anbindung über GitHub oder MCP erspart ein SDK im Produkt.
Vor- und Nachteile
Vorteile
- Apache 2.0 und selbst gehostet: Prompts, Code und Schlüssel bleiben in Ihrer Umgebung, und die kostenlose Stufe ist die volle Engine, keine Testversion.
- Der Richter kommt von einem anderen Anbieter, was das Selbstbenoten entfernt, das interne Reviews angreifbar macht.
- Funktioniert mit jedem Agenten mit Chat-Endpunkt, OpenAI-kompatibel oder nicht, ohne Änderung am Produktcode.
- Jeder Befund trägt Anfrage und Antwort mit sich, sodass ein Prüfer den Gedankengang nachvollzieht statt einer Zahl zu vertrauen.
- JSON-Ausgabe und --min-score machen daraus ein echtes CI-Gate, keinen Bericht, der einmal gelesen und vergessen wird. Die Compliance von Agenten mit internen Richtlinien läuft im selben Durchgang mit, statt als eigenes Projekt.
Nachteile
- Ein belastbarer Lauf braucht Schlüssel von mindestens zwei Anbietern, der Richter kostet also zusätzlich zum Verbrauch des Agenten.
- Die zehn Standardprüfungen sind bewusst flach. Die tieferen Kategorien kommen nur mit --full-run, was länger dauert und mehr kostet.
- Das Audit ist nur so gut wie das Profil. Beschreiben Sie Rolle und Rechte vage, fallen auch die Befunde vage aus.
- Die Note von A bis F hat keine Akkreditierung. Wer eine förmliche Bestätigung braucht, zahlt weiterhin einen externen Prüfer.
Häufige Fragen
Nein. Evals beantworten, ob der Agent die Aufgabe kann. Ein Audit für KI-Agenten fragt, ob er sie im Rahmen seiner Befugnisse erledigt hat, und die Demo des Projekts dreht sich um Agenten, die alle Evals bestehen und trotzdem eine nicht freigegebene Aktion ausführen. Beide Berichte wirken nebeneinander.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu iFixAi.
Alternativen zu iFixAi

Knocket
Knocket (Tencent RTC team) · Produktivität · Business · ChatbotKnocket ist ein kostenloses Werkzeug für Live-Chat und Kontaktseite: Besucher schreiben über Ihre Website, Ihre App oder einen Link, und Sie antworten aus Telegram oder einem einzigen Posteingang.

shippedit.me
Krawlup · Marketing · Businessshippedit.me leitet inzwischen auf Krawlup um, eine Web-Plattform, die SEO, AEO und Ladezeit wöchentlich prüft und die Korrekturen per MCP an Coding-Agenten übergibt.

Ayven
Alknoma · Produktivität · BusinessAyven ist ein KI-Kontrollzentrum von Alknoma: Es macht aus einem einfach formulierten Ziel einen datierten Plan, verteilt die Aufgaben an Ihr Team und seine KI-Agenten und fragt nur dann nach Freigabe, wenn die Entscheidung bei Ihnen liegt.