
LangWatch
LangWatch B.V. · Coding · Marketing
LangWatch ist eine Open-Source-Plattform für LLM-Observability: Sie zeichnet KI-Agenten auf, testet sie und bewertet ihre Antworten, dazu kommen KI-Gateway und Prompt-Management.
Über LangWatch
What Is LangWatch
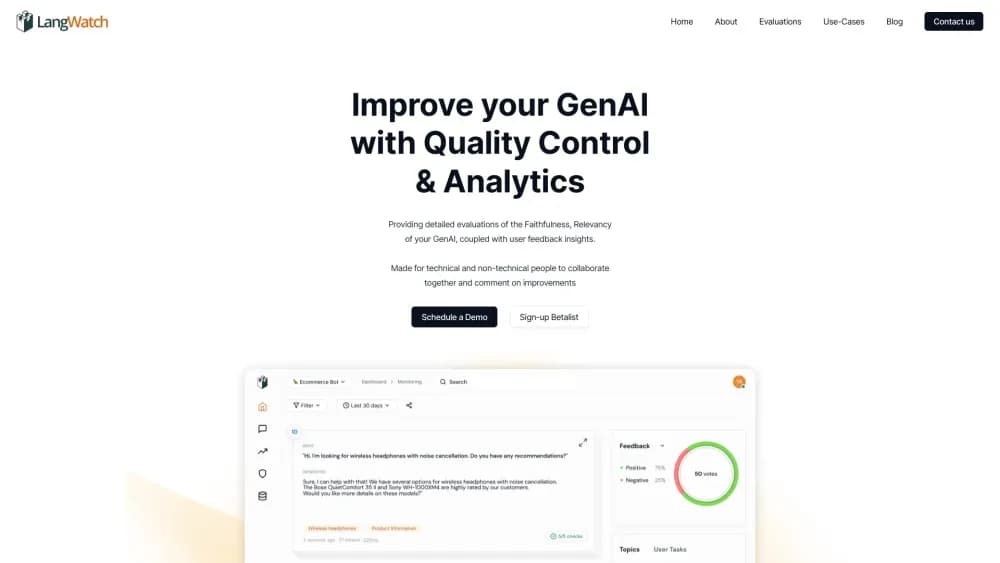
LangWatch ist eine Open-Source-LLMOps-Plattform der LangWatch B.V. mit Sitz in Amsterdam. Sie deckt vier Aufgaben ab, die sonst in getrennten Werkzeugen stecken: LLM-Tracing, KI-Agent-Tests, LLM-Evaluierung und Prompt-Management. Darüber liegt ein KI-Gateway, sodass jeder Modellaufruf über einen einzigen Endpunkt mit zugeordnetem Budget laufen kann.
Das Projekt ging im September 2023 als Open Source an den Start, der Kern steht weiterhin unter Apache 2.0. Sie betreiben die Plattform mit Docker oder Helm auf eigener Infrastruktur, und LangWatch Cloud nutzt denselben Code. Enterprise-Funktionen wie KI-Governance mit mehreren Quellen und Anomalieerkennung liegen in einem Ordner mit eigener Lizenz und verlangen einen bezahlten Tarif.
Die Lücke, die das Produkt schließt, ist fehlende Sichtbarkeit. Sobald ein Agent in Produktion läuft, kommt eine schlechte Antwort selten mit Erklärung. Sie müssen wissen, welcher Tool-Aufruf gescheitert ist, welche Suche leer zurückkam und was das Gespräch gekostet hat. LangWatch hält jeden Schritt als Trace fest und lässt Sie den Ablauf erneut abspielen. Der Haken: Das hier ist ein Entwicklerwerkzeug. Jemand im Team muss Traces lesen und Tests schreiben, und für einen Product Manager ohne technische Unterstützung gibt es keinen Weg ohne Code.
Erste Schritte
- Legen Sie ein Projekt auf app.langwatch.ai an. Der Developer-Tarif verlangt keine Kreditkarte.
- Binden Sie Ihre Anwendung über das Python- oder TypeScript-SDK an, oder richten Sie einen OpenTelemetry-Exporter auf den Ingestion-Endpunkt. LangChain, LangGraph, CrewAI, Mastra und Pydantic AI senden Traces ohne Umbau.
- Lassen Sie den Agenten einmal laufen und öffnen Sie die Trace-Ansicht, um Spans, Token, Latenz und das gesamte Gespräch zu prüfen.
- Ergänzen Sie einen Evaluator oder ein Szenario mit simuliertem Nutzer und blockieren Sie den Merge in der CI abhängig vom Ergebnis.
- Verschieben Sie Prompts in den Prompt-Manager, sobald Sie Versionierung und A/B-Tests außerhalb des Codes brauchen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von LangWatch.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler, die einen Agenten in Produktion bringen
- Plattformteams in mittelgroßen Unternehmen
- Engineering-Leads, die die KI-Kosten im Blick behalten
Aufgaben
- Eine falsche Antwort debuggen
- Regressionen vor einem Release prüfen
- Prompt-Versionen vergleichen
- Coding-Assistenten prüfen
Szenarien
- Ein Agent scheitert bei einer Kundengruppe
- Ein Anbieter erhöht über Nacht die Preise
- Ein regulierter Rollout braucht Self-Hosting
Wichtigste Funktionen
LLM-Tracing für jedes Framework
Jeder Modellaufruf, Tool-Aufruf, jede Suche und jede Bewertung landet als Span in einem Trace, mit verschachtelten Spans und einem Ausführungsgraphen für Agenten. Token und Kosten werden automatisch pro Anbieter, Prompt und Modell gezählt. Traces gruppieren sich über eine Thread-ID zu Sitzungen, sodass Sie ein ganzes Gespräch lesen statt einer einzelnen Anfrage. Text, Bild und Audio werden ebenfalls erfasst, was zählt, wenn ein Agent mit Screenshots oder Sprachnachrichten arbeitet.
KI-Agent-Tests mit simulierten Nutzern
KI-Agent-Tests starten mit einem geschriebenen Szenario, und ein LLM spielt den Nutzer, indem es daraus realistische Nachrichten erzeugt. Der Lauf deckt mehrstufige Dialoge ab statt eines einzelnen Prompts. Ein Judge-Agent bewertet jeden Zug und kann an jeder Stelle bestehen oder durchfallen lassen. Die Prüfung der Tool-Aufrufe kontrolliert, ob das richtige Werkzeug im richtigen Moment lief. Ein Visualizer spielt den Lauf Schritt für Schritt ab und lässt sich mitten im Gespräch für Notizen anhalten. Sprachtests laufen mit ElevenLabs, OpenAI Realtime, Twilio, Pipecat und Gemini Live, inklusive Time-to-First-Byte, p50- und p95-Latenz sowie eingespieltem Hintergrundgeräusch und Unterbrechungen. Adversarische Läufe nutzen Crescendo-Eskalation und Refusal-Erkennung, um Schwachstellen vor den Nutzern zu finden.
LLM-Evaluierung im Experiment und in Produktion
Die eingebauten Evaluatoren decken RAGAS-Metriken, Halluzination, Toxizität, PII-Erkennung und Bewertung durch ein LLM als Judge ab. Offline-Experimente starten Sie aus dem SDK oder über einen Assistenten ohne Code in der Oberfläche und vergleichen Läufe danach nach Qualität, Kosten und Latenz. Produktionsmonitore bewerten den laufenden Verkehr und melden, wenn die Qualität sinkt. Die Bewertung greift auf einen ganzen Thread und ebenso auf eine einzelne Nachricht, was zu Support-Bots und mehrstufigen Agenten passt. Datensätze entstehen aus echten Traces, werden mit KI erzeugt oder nehmen Bilder auf, und ein Annotationseingang sammelt die menschliche Prüfung. Eigene Evaluatoren definieren Sie einmal und teilen sie projektübergreifend; dieselben Prüfungen laufen inline als Guardrails.
KI-Gateway mit Budgets pro Team
Ein Endpunkt spricht sowohl die OpenAI- als auch die Anthropic-API und leitet an OpenAI, Anthropic, Google, Bedrock, Mistral oder andere Anbieter weiter, mit Ihren eigenen Schlüsseln. Jeder Aufrufer bekommt einen virtuellen Schlüssel mit eigenem Budget, festgelegt pro Person, Team oder Endkunde. Der Anbieter nennt 11 Mikrosekunden Overhead. Jede Anfrage darüber landet als Trace im selben Projekt, damit Gateway- und SDK-Verkehr an einer Stelle stehen.
Prompt-Management mit Versionen
Prompts sind strukturierte Objekte mit Nachrichten, Eingaben und Konfiguration, editierbar aus Code, Oberfläche oder API. Die Liquid-Vorlage bringt Variablen und Logik mit. Die GitHub-Synchronisierung lässt Änderungen wie eine Pull Request prüfen, Tags markieren Staging- und Produktionsversionen. Ein Playground stellt Varianten über Modelle hinweg gegenüber, und A/B-Tests melden Qualität, Kosten und Latenz je Version. Webhooks und Slack melden jede Änderung an einem Prompt.
Coding-Agenten und KI-Governance verfolgen
Ein Befehl, npx langwatch claude, bringt Claude Code, Codex, Copilot, Gemini CLI und opencode auf denselben Beobachtungsstandard. Sitzungen zeigen Token, Kosten und Cache-Nutzung pro Entwickler und Repository, was die Frage beantwortet, wohin die KI-Ausgaben tatsächlich gehen. Die KI-Governance ergänzt ein Verzeichnis aller genutzten Werkzeuge und Anbieter, Anomalieregeln auf der Aktivität und ein Audit-Log für Sicherheitsprüfungen.
Vor- und Nachteile
Vorteile
- Open-Source-Kern: Die Apache-2.0-Plattform läuft mit Docker oder Helm auf Ihrem eigenen ClickHouse, damit Traces das Netzwerk nicht verlassen müssen.
- Vier Werkzeuge in einem Konto: Tracing, Agent-Tests, Evaluierung und Prompts teilen dieselben Traces, was das Kopieren zwischen Anbietern spart.
- Breite Framework-Abdeckung: LangChain, LangGraph, CrewAI, Mastra, Pydantic AI, das Vercel-AI-SDK und reines OpenTelemetry senden Traces ohne Umbau.
- Brauchbarer Gratis-Tarif: 50.000 Events pro Monat, zwei Nutzer und 14 Tage Aufbewahrung kosten nichts und brauchen keine Karte, genug für einen Prototyp.
- Das Gateway behält die Kontrolle: Anbieterschlüssel und Budgets pro Person bleiben im eigenen Konto, und jeder geleitete Aufruf wird automatisch getraced.
Nachteile
- Zuerst ein Entwicklerwerkzeug: Es gibt keinen Drag-and-drop-Weg zum Bauen eines Agenten, und die Evaluierung setzt Python oder TypeScript voraus.
- Nutzungsabrechnung braucht Aufsicht: Im Growth-Tarif sind 200.000 Events enthalten, danach kostet 100.000 Events 5 €, und ein gesprächiger Agent mit Tools und Suchen verbraucht deutlich schneller als ein einfacher Chatbot.
- Self-Hosting bedeutet Betriebsarbeit: ClickHouse und die Plattform laufen bei Ihnen, Updates eingeschlossen, sofern Sie keinen Enterprise-Support buchen.
- Governance und SSO nur in Enterprise: Eigenes SSO, RBAC, Audit-Logs und Datenmaskierung fehlen im Growth-Tarif, was regulierte Teams bis zur Verhandlung ausschließt.
Häufige Fragen
LangWatch ist eine Open-Source-Plattform zum Beobachten, Testen und Bewerten von LLM-Anwendungen. Sie zeichnet Agent-Traces auf, führt simulierte Gespräche aus, bewertet die Antwortqualität und verwaltet Prompt-Versionen in einem Dashboard.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu LangWatch.
Alternativen zu LangWatch

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.