
Liquid Inference
Architect Financial Technologies Inc. · Coding · Produktivität
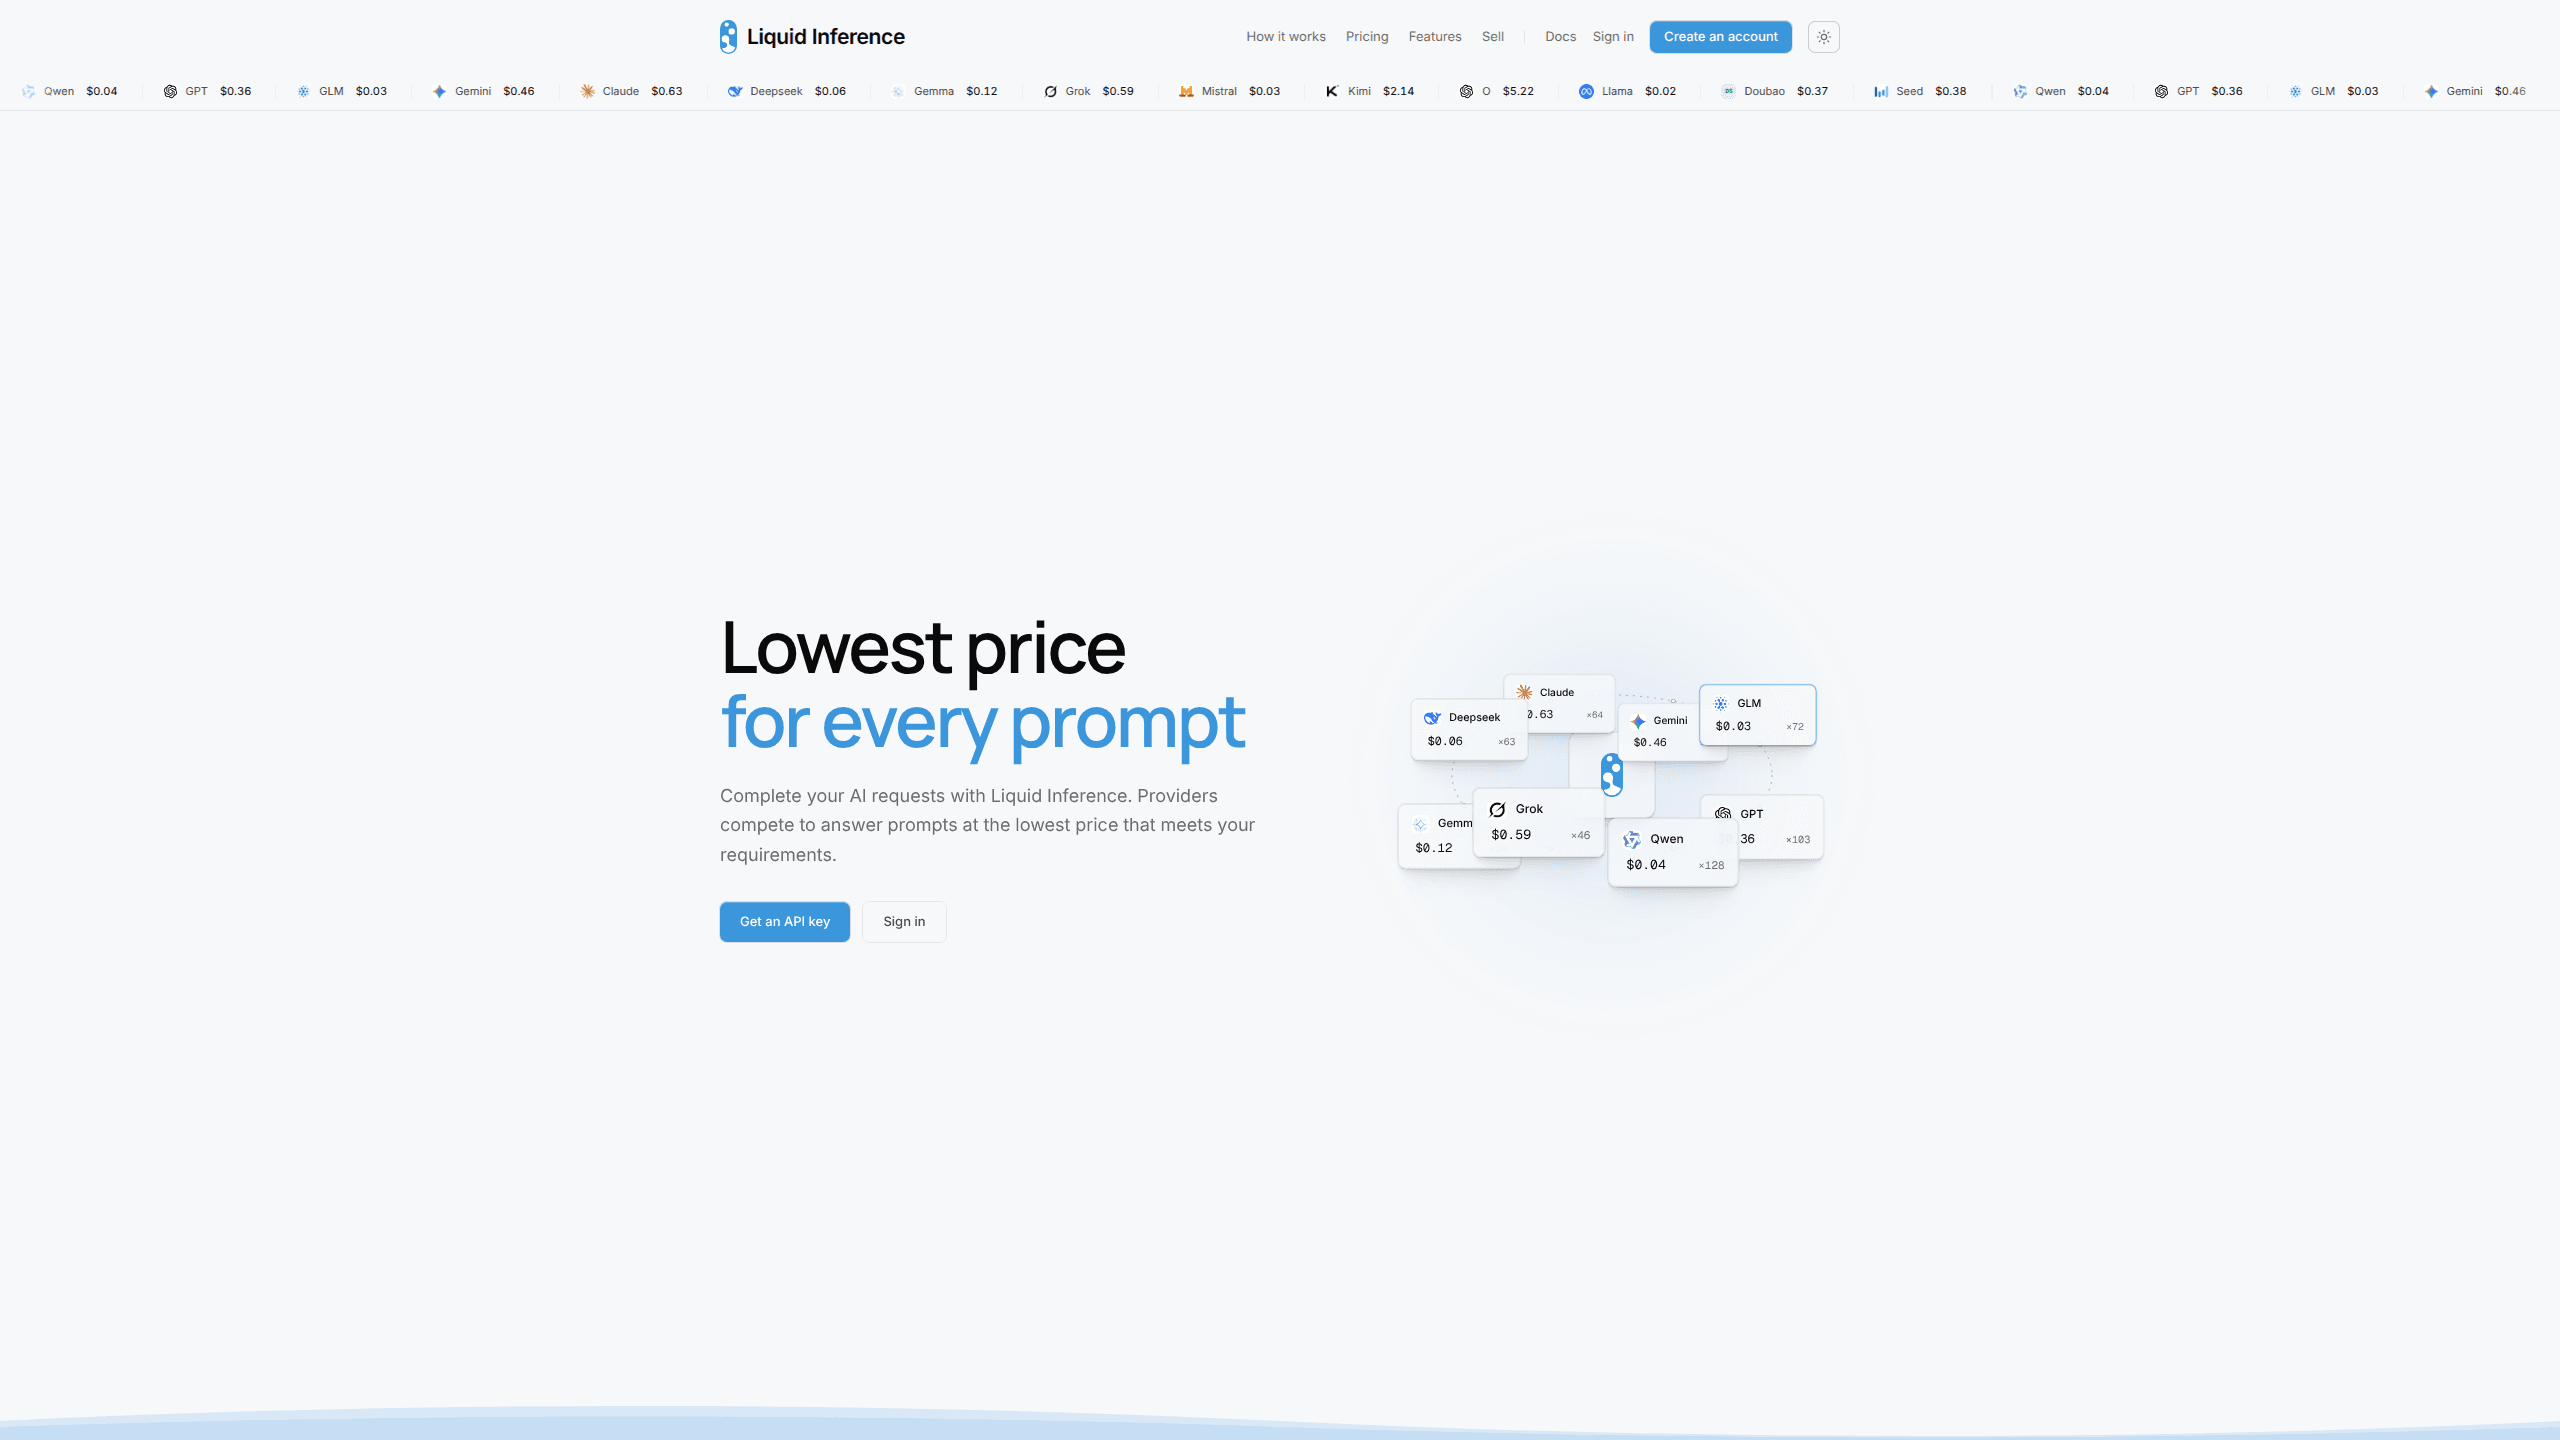
Liquid Inference ist ein Marktplatz für KI-Inferenz von Architect: Jede Anfrage wird versteigert und geht an den günstigsten Anbieter, der Ihre Bedingungen erfüllt.
Über Liquid Inference
About
Was ist Liquid Inference
Liquid Inference ist ein LLM-Router, der wie eine Börse arbeitet. Anbieter stellen für jedes Modell, das sie bedienen, ein Angebot mit einem Preis pro Token ein, und Ihre Anfrage geht an das günstigste Angebot, das Ihre Bedingungen erfüllt. Der Zugang läuft über einen Chat im Browser oder über die Inferenz-API, die das Format von OpenAI und das von Anthropic annimmt. Zugleich arbeitet Liquid Inference als Modell-Router: Sie wählen den Modellnamen, der Markt entscheidet, wer ihn bedient.
Das Problem liegt auf der Rechnung, nicht beim Modell. Die meisten Teams zahlen die Listenpreise eines geschlossenen Anbieters, obwohl mehrere Dienstleister dasselbe offene Modell hosten. Hier wird der Preisdeckel vor dem ersten Token festgeschrieben, nicht verbrauchtes Budget fließt zurück auf das Guthaben, und jeder Auftrag hinterlässt einen Beleg mit dem gewinnenden Anbieter und der endgültigen Belastung.
Die Grenzen sollte man kennen, bevor eine Produktionslast umzieht. Der Markt ist im Oktober 2026 gestartet, die Zahl der Verkäufer und die gelisteten Modelle ändern sich also noch. Die Qualität schwankt je nach Gewinner, deshalb enthalten die Kaufregeln Filter für Latenz, Durchsatz und Region. Dazu kommt ein Mindestsatz pro Token, der bei sehr billigen Modellen stärker wiegt als die beworbenen 5 Prozent.
Erste Schritte
- Registrieren Sie sich auf liquidinference.ai. Die Anmeldung legt einen Workspace mit Guthaben, API-Schlüsseln und Belegen an, und ein Startguthaben erlaubt Tests ohne Karte.
- Erstellen Sie auf der Schlüsselseite einen API-Schlüssel. Das Geheimnis wird nur einmal angezeigt, kopieren Sie es vor dem Schließen.
- Richten Sie Ihren OpenAI- oder Anthropic-Client auf die Basis-URL des Marktes und tauschen Sie den Schlüssel. Modellnamen müssen denen entsprechen, die die Plattform listet.
- Ergänzen Sie bei Bedarf ein
exchange-Objekt im Anfragetext, um einen Preisdeckel, eine Frist bis zum ersten Token, eine Aufbewahrungsregel oder eine Anbieterliste zu setzen. - Lesen Sie das Feld
exchangein der Antwort oder öffnen Sie den Beleg. Dort steht, welcher Anbieter gewonnen hat und was der Auftrag gekostet hat.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Liquid Inference.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler mit Coding-Agenten
- Startups mit schwer planbarem Volumen
- Plattformteams, die Nachweise brauchen
- GPU-Besitzer mit freier Kapazität
Aufgaben
- Batch-Jobs mit Kostenobergrenze
- Modelle mit demselben Prompt vergleichen
- RAG- und Suchpipelines
- Bilder, Sprache oder Transkripte einkaufen
Szenarien
- Eine Agentenschleife dreht durch und die Rechnung steigt
- Ein Anbieter fällt mitten in einem langen Lauf aus
- Ein Team sucht die günstigste LLM-API für ein internes Werkzeug und kann nicht jeden Verkäufer testen
Wichtigste Funktionen
Eine Auktion pro Anfrage
Jede Anfrage landet in einem live geführten Orderbuch. Die Plattform verwirft alle Angebote, die Ihre Grenzen verletzen, sortiert den Rest nach geschätzten Kosten plus erwarteter Wartezeit und vergibt den Auftrag an das beste. Der Preis wird vor der Generierung gedeckelt, der schlimmste Fall steht also vorher fest.
Kaufregeln in Ihrer Hand
Ein optionales exchange-Objekt trägt die Bedingungen. Sie setzen einen Kostendeckel in Dollar, eine Höchstzeit bis zum ersten Token, einen Mindestdurchsatz, erlaubte Regionen, Nullaufbewahrung sowie Positiv- und Negativlisten für Anbieter und Modelle. Nur Angebote, die alles erfüllen, treten an. Die Richtlinie wird damit ein Feld der Anfrage statt ein Ticket an den Support.
Wechsel vor dem ersten Token
Scheitert der Gewinner, bevor eine Ausgabe geschrieben ist, verschiebt die Plattform den Auftrag auf das nächste Angebot. Ab dem ersten Token wechselt sie nicht mehr, eine Antwort stammt also nie aus zwei Modellen. Das zählt bei streamenden Agenten, wo ein Wechsel mitten im Fluss bereits gesendete Tool-Aufrufe zerstören würde.
Belege und öffentliche Marktdaten
Jeder abgerechnete Auftrag hat einen Beleg mit Gewinner, Deckel, Verbrauch und Gebühr. Kontoinhaber sehen zusätzlich das Live-Orderbuch, die Kurse je Anbieter und abgeschlossene Geschäfte. Diese Daten lassen sich vor dem Senden über die API abrufen, etwa um zu prüfen, ob ein Modell über seinem üblichen Satz gehandelt wird.
Auto-Router und Achsen-Routing
Mit liquid.auto wählt die Plattform ein Modell nach veröffentlichter Bewertung und geschätzten Kosten innerhalb Ihres Deckels, in den Varianten premium, balanced und economy. Alternativ sortiert ein Suffix am Modellnamen die Angebote nach intelligent, schnell oder günstig. In beiden Fällen bleibt die Auktion darunter erhalten, der Preis kommt also von konkurrierenden Verkäufern.
Läuft mit Ihrem bestehenden Stack
Die Endpunkte bilden eine OpenAI-kompatible API für Chat Completions und Responses sowie eine Anthropic-Messages-Route. Die offiziellen SDKs funktionieren nach dem Wechsel der Basis-URL. Anleitungen gibt es für Claude Code, Codex, Cursor, Cline, Open WebUI, n8n, Dify, LangChain und viele weitere Werkzeuge. Die Liquid-CLI startet einen Coding-Agenten im Terminal mit demselben Schlüssel.
Eine Verkäuferseite für GPU-Besitzer
Anbieter registrieren Deployments, setzen einen Preis pro Modell und quotieren während einer Sitzung. Die Plattform verteilt Aufträge, misst den Verbrauch und rechnet Zahlungen ab. Wer ungenutzte GPUs hat, kann sie vermarkten, ohne eine eigene Abrechnung zu bauen. Wer bereits anderswo verkauft, listet dasselbe Deployment hier als zweiten Handelsplatz.
Vor- und Nachteile
Vorteile
- Der Deckel steht vor der Generierung fest, ein Prompt mit sehr hohem Ausgabelimit erzeugt also keine Überraschungsrechnung.
- Sie behalten SDK und Client. Meist besteht der Umzug aus Basis-URL und Schlüssel, nicht aus einem Neuschreiben.
- Die Kaufregeln decken Latenz, Region und Datenaufbewahrung ab, was den Marktplatz für Lasten mit Compliance-Anforderungen nutzbar macht.
- Belege und öffentliches Orderbuch halten fest, was jeder Auftrag gekostet hat und wer ihn bedient hat.
- Die Verkäuferseite bietet GPU-Besitzern einen Weg, freie Kapazität zu füllen, ohne eigene Abrechnung.
Nachteile
- Der Markt ist neu. Gestartet im Oktober 2026, hat er weniger Verkäufer als etablierte Router, und die Modellabdeckung kann sich ohne Vorankündigung ändern.
- Der Mindestsatz von 0,01 Dollar pro Million Token trifft billige und kostenlose Angebote hart. Bei einem Sparmodell kann die effektive Gebühr nahe an die Hälfte der Anbieterkosten reichen.
- Die Qualität hängt vom Gewinner ab. Die Auktion optimiert Preis und zugesagte Leistung, nicht die Qualität einer konkreten Antwort, und eine hohe Bewertung garantiert kein besseres Ergebnis.
- Eine Anfrage kann nach Beginn der Ausgabe nicht mehr den Anbieter wechseln. Verschlechtert sich der Verkäufer mitten im Fluss, bleiben eine Teilantwort und ein neuer Versuch.
Häufige Fragen
Liquid Inference ist ein Marktplatz für LLM-Inferenz von Architect Financial Technologies. Anbieter veröffentlichen Preise für die Modelle, die sie bedienen, und jede Anfrage geht an das günstigste Angebot, das die Regeln des Käufers zu Kosten, Tempo, Region und Daten erfüllt. Der Zugang läuft über Web, API und CLI.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Liquid Inference.
Alternativen zu Liquid Inference

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

GitGlow
GitGlow · Coding · ProduktivitätGitGlow ist ein Git-Client für den Desktop, der Ihren Code und die Änderungen Ihrer KI-Agenten in einer Review bündelt, damit Sie vor dem Ausliefern sehen, was die Maschine verlässt.